Yerli modellər artıq həqiqətən yaxşıdır: 2022-ci il Mac-də quraşdırma təcrübəsi
Mühəndis Vicki Boykis deyir ki, yerli modellər nəhayət agent əsaslı kodlaşdırma üçün kifayət qədər yaxşı olub: 64 GB RAM-li 2022-ci il M2 Mac-də öncül modellərin dəqiqlik və sürətinin təxminən 75%-nə çatırlar, hər sessiya Docker-də təcrid olunur.
Mühəndis Vicki Boykis yerli modellər meydana çıxandan bəri onlarla işləyir və 15 iyun 2026 tarixli yazısında yekunlaşdırır: nəhayət, onlar həqiqətən yaxşıdır. Test maşını 64 GB RAM və 1 TB yaddaşa malik 2022-ci il M2 Mac-dir.
O, Mistral 7B, Gemma 3, OpenAI OSS-20B, Qwen 3 MoE və Qwen 2.5 Coder kimi digər Qwen variantlarını müxtəlif mühitlərdə sınayıb: Open WebUI ilə təmiz llama.cpp, llama-cpp-python, Ollama, llamafiles və LM Studio.
Yerli modellər bu gün haradadır
Boykis GPT-OSS buraxılışını dönüş nöqtəsi sayır — bir API modeli ilə müqayisə edib yoxlamağı dayandırdığı ilk model. Onun şəxsi meyarı sadədir: bunu API modeli ilə təsdiqləməliyəmmi?
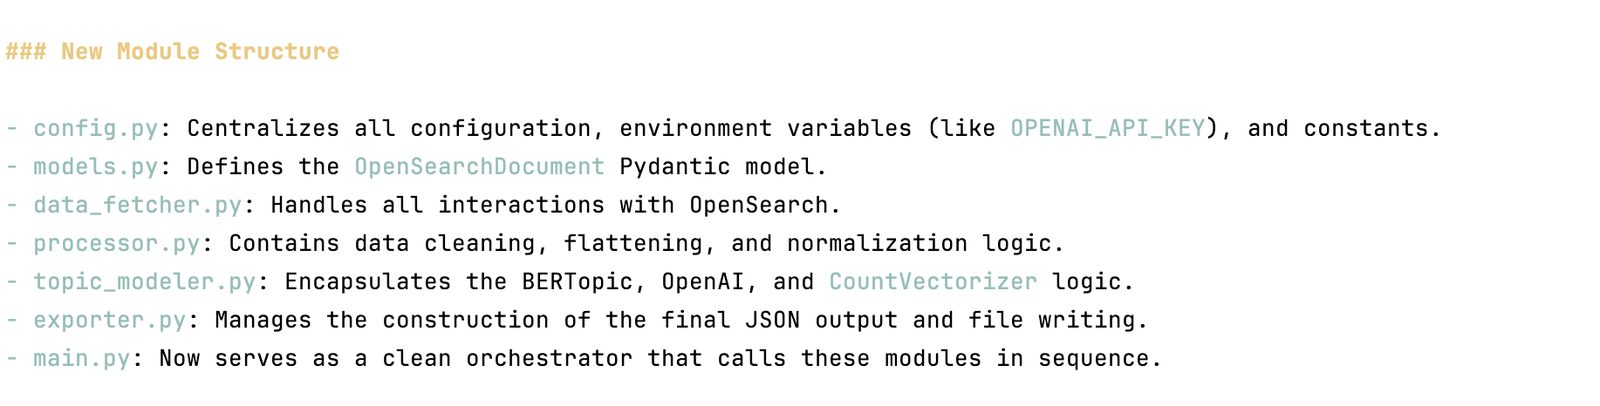
Gemma 4 ailəsinin ən yeni buraxılışları ilə nəhayət yerli olaraq agent əsaslı kodlaşdırmaya başladı: dövrlər öncül modellərin dəqiqlik və sürətinin təxminən 75%-i səviyyəsində işləyir. Standart yerli modeli LM Studio-da gemma-4-26b-a4b-dir. Onunla notebook skriptini beş-altı modulluq repoya çevirdi, tip göstərişlərini düzəltdi, bloq yazılarını redaktə etdi, unit testlər yazdı və sıfırdan two-tower tövsiyə modeli repozitoriyası qurdu. K-V keşi 64 GB-a qədər böyüyür və bu tapşırıqlar altı ay əvvəl yerli modellər üçün mümkünsüz idi.
Yerli agentləri bu gün necə işə salmaq olar
Üç hissə lazımdır: yerli inference mühərriki, agent çərçivəsi və model faylı; çərçivə yerli ünvana yönləndirilir. Boykis çərçivə kimi Pi-dən, inference serveri kimi LM Studio-dan istifadə edir və birbaşa llama.cpp-nin yəqin ki daha sürətli olacağını qeyd edir.
Təhlükəsizlik üçün hər Pi sessiyası yalnız bash icazəsi olan Docker konteynerində işləyir, beləliklə Python kodu işlədə və ya internetdə gəzə bilmir. Model olaraq gemma-4-12b-qat seçib: daha yeni, daha kiçik və sürətli, dəqiqlikdən ciddi itki olmadan.
Hələ də işləməyənlər
İnference yavaş ola bilər, kontekst pəncərələri kiçikdir və yalnız öz avadanlığınızla məhdudlaşır, erkən buraxılışlar isə prompt şablon uyğunsuzluğundan əziyyət çəkir, hələ ki bunlar tez düzəldilir. Ekosistemi LM Studio və HuggingFace-in Use This Model düyməsi xeyli asanlaşdırır.
Onun fikrincə bu, istehsalat proqram təminatı hazırlanması üçün hələ hazır deyil. Əvəzində üstünlük şəffaflıqdır: token generasiyasını canlı izləmək, kontekst pəncərəsini, sistem promptunu və kvantizasiyanı dəyişmək, modelləri bir-birinə qarşı sınamaq mümkündür.
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.