AWS MoE modellərinin RL təlimini EKS-də EFA və DeepEP ilə 40% sürətləndirdi
AWS, MoE modellərinin böyük miqyaslı RL təlimi üçün Amazon EKS, EFA və DeepEP-i birləşdirən istinad arxitekturasını yayımlayıb. 48 P5en instansında DeepEP-in EFA üzərində işə salınması rollout məhsuldarlığını 40 faiz artırıb.
AWS, Mixture-of-Experts (MoE) modellərinin böyük miqyaslı RL təlimi üçün Amazon EKS üzərində EFA və DeepEP-i birləşdirən istinad arxitekturasını yayımlayıb. 25 sentyabr 2026-cı il tarixli AWS Machine Learning bloq yazısı, DeepEP-in EFA üzərində işləməsi ilə ümumi rollout məhsuldarlığının 40 faiz artdığını bildirir.
Rabitə ilə məhdudlaşan rollout dövrü
Seyrək MoE arxitekturaları inferens xərclərini azaldır, amma təlimi hesablamadan çox rabitə ilə məhdudlaşdırır. Bu yükün əsas mənbəyi Expert Parallelism-dir (EP): Tensor, Data və Pipeline Parallelism sxemlərinə qurğular arasında dinamik all-to-all token marşrutlaşdırması əlavə olunur.
Asinxron RL işi eyni vaxtda iki yük daşıyır: rollout generasiyası ümumi məhsuldarlığı artıran paylanmış inferensdir, siyasətin təlimi isə sinxron, sıx bağlı işçilər tələb edir və bir geridə qalan bütün işi dayandıra və ya NCCL zaman aşımlarına səbəb ola bilər. Bir instansdan kənara çıxdıqda trafik qovşaqdaxili NVLink-dən daha yavaş qovşaqlararası xətlərə keçir.
DeepEP tokenləri EFA üzərində necə ötürür
DeepEP adi all-to-all kollektivləri iki kernel ilə əvəz edir: dispatch tokenləri uzaq ekspertlərə yönləndirir, combine nəticələri toplayır; qovşaq daxilində NVLink-dən, qovşaqlar arasında libfabric-dən istifadə edirlər. AWS, DeepEP-in primitivlərini libfabric-ə köçürən dəyişiklikləri upstream-ə əlavə edib; nəticədə DeepEP v2 EFA-nın yerli dəstəyini alıb və NCCL 2.31 EFA-nın ən son optimallaşdırmalarını əlavə edir. P5 və P6 instanslarında EFA NVIDIA GPUDirect RDMA ilə məlumatları birbaşa GPU yaddaş buferləri arasında ötürür.
Benchmark nə göstərir və nə tələb olunur
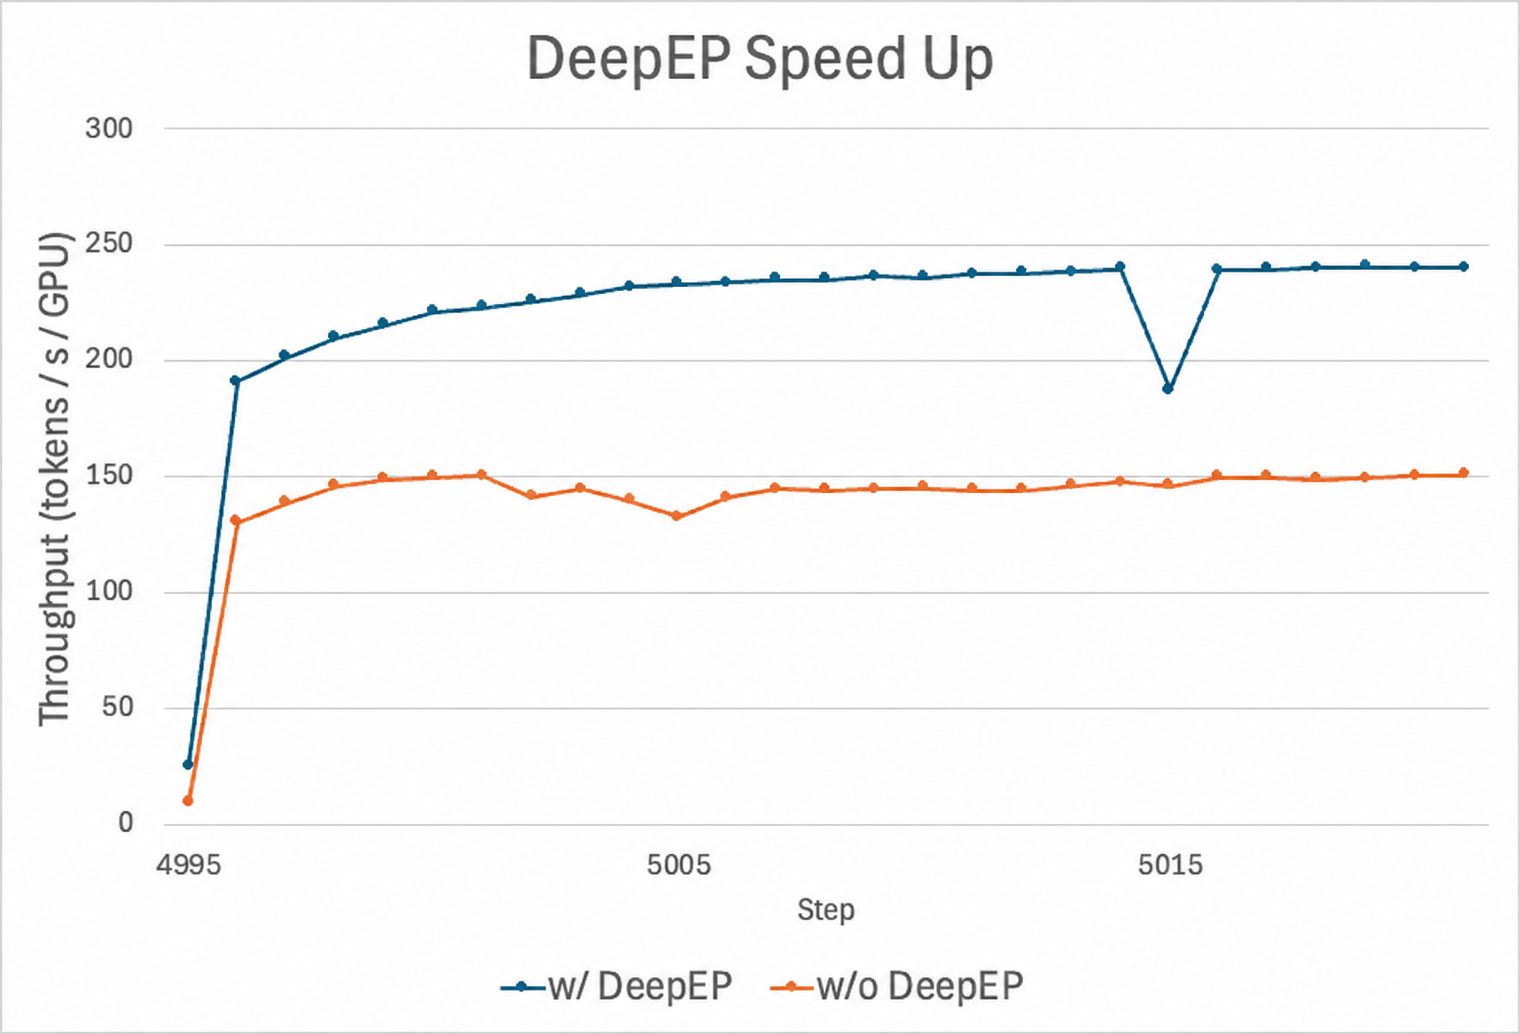
AWS-nin məlumatına görə, 16-sı təlimə, 32-si inferensə ayrılmış 48 P5en instansında, eyni super-seyrək MoE modelində DeepEP-in EFA üzərində işə salınması rollout məhsuldarlığını 40 faiz artırıb və miqyas təxminən min sürətləndiriciyə çatıb. Baza variantı EFA ilə sürətləndirilmiş expert parallelism olmadan Slime əsaslı stek (CUDA 12.9, PyTorch 2.9.1, NCCL 2.27, SGLang 0.5.9, Slime 0.2.4), təkmilləşdirilmiş variant isə DeepEP-over-EFA steki (CUDA 13.0, PyTorch 2.12, NCCL 2.31, EFA 1.49, DeepEP 2.0, SGLang 0.5.17, Miles 0.1.0) idi.
Yazıda Amazon EKS 1.31 və ya daha yeni versiya, AWS OFI NCCL plagini ilə EFA installer 1.49 və p5.48xlarge ya da p6-b200.48xlarge kimi instanslar sadalanır; qovşaqlar eyni Availability Zone-da olmalıdır. Rollout üçün Amazon EC2 Spot instansları uyğundur: yarımçıq tapşırıqlar növbəyə qayıdır, təlim isə sabit gücü saxlayır. İşlər TorchX ilə göndərilir, checkpoint-lər Amazon S3-də saxlanılır.
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.