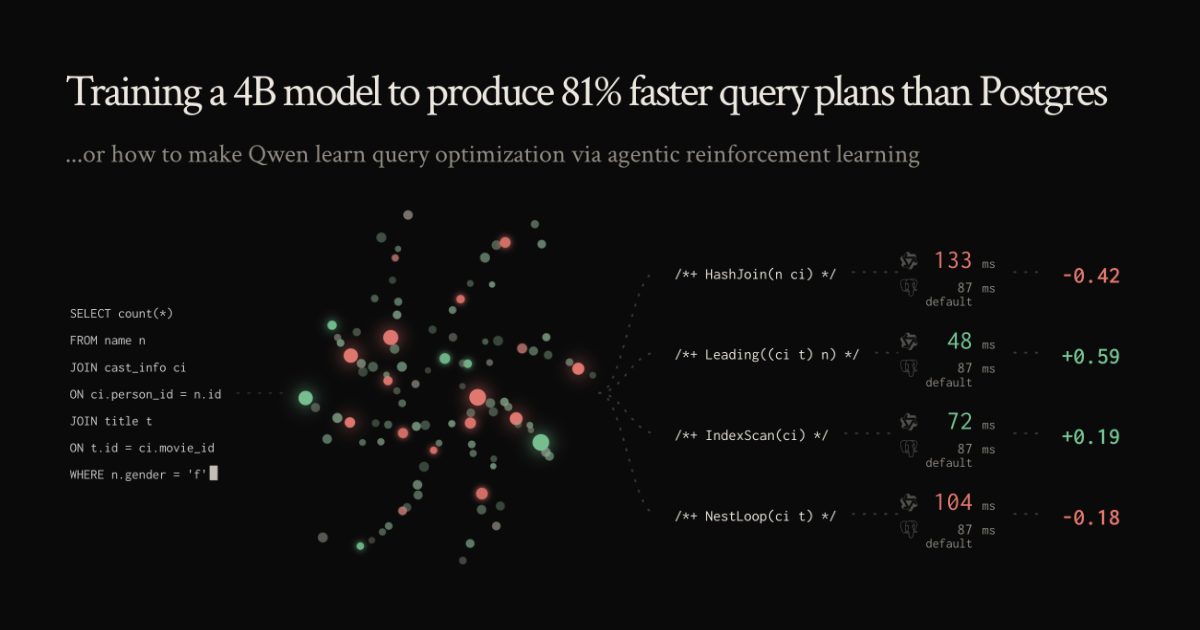
RL ilə öyrədilmiş 4B model Postgres-dən 81% daha sürətli sorğu planları yaradır
Rohan Bansal 4 milyard parametrli açıq modeli pg_hint_plan göstərişləri ilə PostgreSQL planlaşdırıcısını yönləndirmək üçün öyrədib. 113 birləşdirmə ağırlıqlı sorğuda ümumi gecikmə 44,7% azalıb.
Kiçik model Postgres planlaşdırıcısına qarşı
Rohan Bansal kiçik, açıq çəkili dil modelinin sonradan elə öyrədilə biləcəyini göstərən təcrübə dərc edib ki, model PostgreSQL üçün verilənlər bazasının özündən daha yaxşı sorğu planları yaradır. IMDb məlumat dəsti üzərində birləşdirmə ağırlıqlı 113 SQL sorğusundan ibarət Join Order Benchmark-da (JOB) öyrədilmiş 4B model ən yaxşı namizədin seçilməsi ilə həndəsi ortalamada 1,81x sürətlənmə əldə edib, bütün iş yükünün ümumi gecikməsi isə 44,7% azalıb. Həmin nəzarət nöqtəsi 68 qələbə və heç bir geriləmə qeydə alıb.
Başlanğıc vəziyyəti ürəkaçan deyildi: öyrədilməmiş model 113 sorğunun 99-u üçün yararlı plan qura bilmədi və yalnız 14 cəhdi etibarlı namizəd verdi. Müəllifin izahına görə sorğu optimallaşdırıcıları çətindir — birləşdirmələrin sırası NP-çətin məsələdir və planlaşdırıcı kardinallığı sətirləri saymaqla deyil, statistikadan təxmin edir. Lakin planı yoxlamaq asandır, çünki yeganə meyar icra vaxtıdır. Məhz bu asimmetriya məsələni gücləndirməli öyrənmə üçün əlverişli edir.
Göstərişlər, agent mühiti və distillyasiya
Model planlaşdırıcını əvəz etmir, onu yönləndirir. Bansal SQL şərhlərində strukturlaşdırılmış göstərişləri qəbul edən üçüncü tərəf genişlənməsi pg_hint_plan-dan istifadə edib və altı alətli qo-agent adlı agent mühiti qurub. Agent cədvəlləri və sütun statistikasını yoxlayır, standart planı oxuyur və namizəd plan əməliyyatları göndərir; hər namizəd göstərişə çevrilir, icra olunur və standart planla vaxt üzrə müqayisə edilir.
Təlim iki mərhələdə keçib. Əvvəlcə 500 GPT-6 Astra agent trayektoriyasından off-policy distillyasiya ilə nəzarətli incə tənzimləmə aparılıb; 4,66 milyard parametrli Qwen törəməsi üzərində yalnız 42,5 MB ölçülü və 21,2 milyon öyrədilə bilən parametrli LoRA adapteri yenilənib. İki epoxa nəticəni yaxşılaşdırıb, üçüncüsü isə validasiya itkisi heç dəyişmədiyi halda pisləşdirib.
Səs-küylü mühitdə mükafatlar
İkinci mərhələ fərdiləşdirilmiş GRPO variantı ilə agent əsaslı gücləndirməli öyrənmə idi. Sürətlənmə üç standart plan ölçməsinin medianının üç namizəd ölçməsinin medianına bölünməsi ilə hesablanırdı və ölçmə dəzgahı xüsusilə diqqətlə qurulmalı idi: bir maşında işləyən dörd PostgreSQL konteyneri ölçmələri korlayan Linux səhifə keşi rəqabəti yaradır. Təlim iki yerə bölünüb — vLLM və trainer kirayə 2x H100 düyünündə, verilənlər bazası konteynerləri isə müəllifin masasında. Mükafatın ilk formulu modeli daim Postgres-in standart planını qaytarmağa sövq edirdi; həll yolu rollout-ları mütləq bal vermək əvəzinə bir-biri ilə müqayisə etmək oldu.
Model nə öyrəndi
1200 yeniləmədən sonra yekun nəzarət nöqtəsində axtarışların çoxu əvvəlcə cədvəli, sütun statistikasını və ya standart planı yoxlayıb. Layihə təxminən 1200 dollara başa gəlib: Lambda-da təqribən 95 saat 2x H100 düyünü və nümayiş trayektoriyaları üçün 400 dollar OpenAI API haqqı. Bansalın nəticəsi böyük modellərin köhnəldiyi deyil — kiçik modelin işləməsinin səbəbi məhz Astra-dan edilən distillyasiyadır — kiçik modellər dar və asan yoxlanıla bilən tapşırıqlarda ciddi diqqətə layiqdir.
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.