Yerli LLM göründüyündən daha ağıllıdır: inference yığımı keyfiyyəti harada itirir
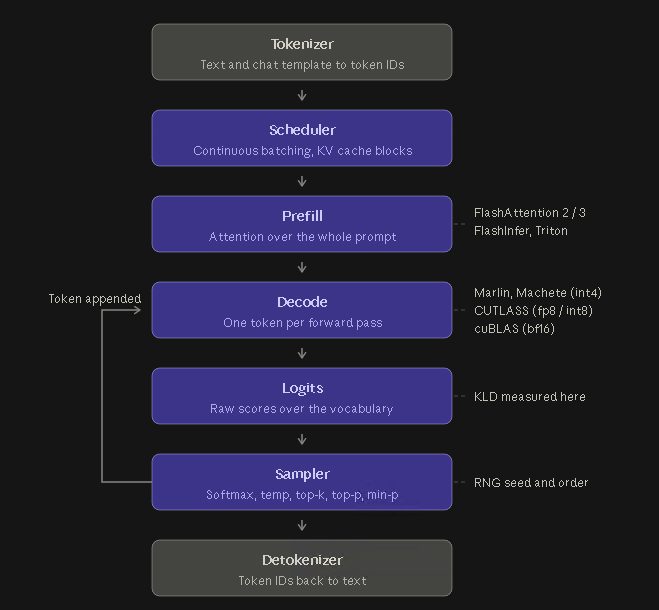
Level1Techs forumunda dərc olunmuş təcrübələr silsiləsi göstərir ki, yerli modelin "axmaq" görünməsi çox vaxt attention backend-ləri, KV keşinin kvantlaşdırılması və tensor paralelliyi ilə bağlıdır — modelin özü ilə deyil.
Level1Techs forumunda dərc olunmuş təcrübələr silsiləsi göstərir ki, yerli kompüterdə işlədilən model çox vaxt əslində olduğundan daha zəif görünür — və səbəb çox vaxt modelin özü deyil, inference yığımıdır. Mövzunun müəllifi, thr3e ləqəbli istifadəçi, eyni çəkiləri müxtəlif runtime parametrləri ilə işlədir və nəticələrin haradan ayrılmağa başladığını ölçür.
İki tətbiq eyni olmur
Müəllif "referens tətbiq" ifadəsini modeli dərc edən, ilk növbədə özü host edən və orijinal bençmark nəticələrini paylaşan laboratoriya üçün işlədir: onların aparat və proqram təminatı sizinkindən fərqlidir. Ev konfiqurasiyaları tez-tez müxtəlif nəsil GPU-ları qarışdırır; fərqli təlimat dəstləri isə eyni çəkilərlə belə növbəti tokenin riyaziyyatını başqa cür hesablayır. Testlərdə istifadə olunan vLLM nightly konteynerində 734 paket var idi, onlardan 252-si Python paketi — yəni hər biri öz xətalarına malik 734 kod bazası.
Üç test: backend-lər, KV keşi, kvantlaşdırma
Birinci testdə üç attention backend-i — FlashAttention 2, Flash Inference və Triton Attention — Qwen3.6-27B-nin BF16 versiyasında, RTX PRO 6000 Blackwell-də müqayisə edildi; başqa heç nə dəyişdirilmədi. İş yükü real iş axınından götürülmüş və alət çağırışları olan təxminən 100 min tokenlik kontekst idi. İlk bir neçə min token ərzində bütün backend-lər razılaşırdı, sonra fərqlənməyə başladılar. Eyni backend-in təkrarı bit səviyyəsində eyni logitlər verdi; deməli fərq təsadüfdən deyil, prefill mərhələsindəki riyaziyyatdan gəlir.
İkinci testdə yalnız KV keşi kvantlaşdırıldı: int8 versiyası pozulmuş alət çağırışından sonda bərpa olundu, int4 isə yox. Üçüncüdə çəkilərin beş formatı müqayisə edildi: ən yaxşısı INT8 W8A16 oldu, Nvidia-nın NVFP4-ü isə sonuncu yerdə qaldı — 88 min tokenlik kontekstdə tokenlərin təxminən 50%-i "döndü". NVFP4 və AWQ W4A16 Cisco cihazında səhv əmr işlətdi: 'show arp' lazım olduğu yerdə 'show run'.
Bir dönmüş token, bir uğursuz tapşırıq
Yazının ikinci hissəsində müəllif alət çağırışları zamanı logitlərin 100%-ni qeyd edib generasiyaları budaqlandırdı və hər versiyanın hara getdiyini izlədi. Bir halda FlashAttention 2 ilə işləyən versiya GigabitEthernet0/0/1.201 əvəzinə GigabitEthernet0/1/4 ünvanını hədəflədi və sonra 'show mac address table' əvəzinə 'show run' işlətdi; başqa halda interfeys təsvirini ümumiyyətlə qura bilmədi. Tensor paralelliyində eyni tapşırıq TP1-də keçdi, TP2-də uğursuz oldu, TP4-də yenidən keçdi — dərin ayırmada bu, adətən NCCL-i göstərir.
Düzgün ölçmə necə aparılır
Forumdakı tövsiyə real iş yükünüzü təmsil edən standart bençmarklar işlətməkdir: temperature-ı sıfıra salıb üç test promptu yeritmək agent əsaslı işlərin yaxşı analoqu deyil; uzun kontekstdə alət çağırışları və sahəyə xas bilik yoxlamaları lazımdır. Model kartındakı sampler parametrləri və chat template istifadə edilməlidir — çox aşağı temperature bəzi modellərin THINK çıxışı içində dövrəyə düşməsinin səbəbidir. Şərhlərdə həmçinin qeyd olundu ki, KL divergensiyası paylanmanın referensdan nə qədər uzaqlaşdığını ölçür, düzgünlüyü yox, və istiqamətlidir; top-1 uyğunsuzluğu isə ayrı və daha sərt ölçüdür. BF16 rəqəmsal dəqiqliyin referensidir, "orakul" deyil: kvantlaşdırılmış model ondan uzaqlaşıb yenə də daha yaxşı cavab verə bilər.
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.