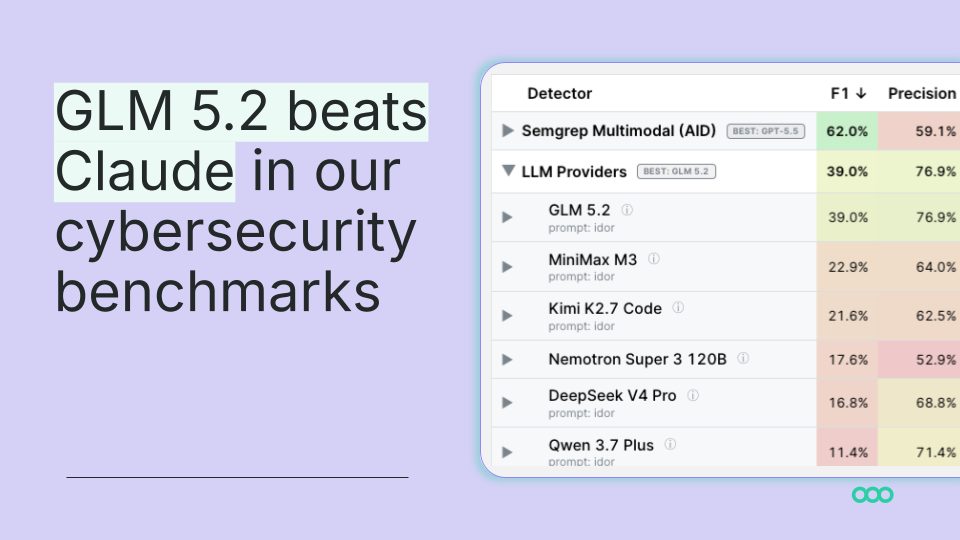
GLM 5.2 עקף את Claude Code במבחן האבטחה של Semgrep
במבחן חדש של Semgrep לזיהוי פגיעויות IDOR השיג המודל בקוד פתוח GLM 5.2 של Zhipu AI ציון F1 של 39% לעומת 32% של Claude Code, אך עדיין נותר אחרי הצינור המולטימודלי של החברה.
צוות המחקר של חברת Semgrep, העוסקת באבטחת קוד, פרסם ב-22 ביוני מבחן השוואה שבו הושוו מודלים פופולריים עם משקלים פתוחים לסוכני קוד מובילים במשימת זיהוי פגיעויות מסוג IDOR. מודל פתוח אחד יצא קדימה: GLM 5.2 של Zhipu AI (Z.ai) השיג ציון F1 של 39%, בעוד Claude Code הסתפק ב-32% — בעלות של כ-0.17 דולר לכל פגיעות שנמצאה.
מה בודק מבחן ה-IDOR
IDOR (Insecure Direct Object Reference) הוא פגם בבקרת גישה: האפליקציה חושפת מזהה פנימי, למשל מזהה משתמש, בבקשה בלי לבדוק אם למי ששולח אותה יש הרשאה לגשת לאותו אובייקט. מחליפים את המזהה ומקבלים את הנתונים של מישהו אחר. Semgrep מציינת שזה אינו באג מסוג taint-flow — אין כאן פונקציה מסוכנת לסמן, רק בדיקה חסרה, וזה מה שהופך את המשימה לקשה גם לניתוח סטטי וגם למודלי שפה. בפועל זה אחד הממצאים הנפוצים ביותר, וכיום הוא מדורג רביעי ברשימת סוגי הפגיעויות המובילים של HackerOne.
התוצאות
בניסוי נשמרו קבועים מאגר הנתונים, שיטת ההערכה ונוסח ההנחיה; רק המודל והמעטפת (harness) שלו הוחלפו. הצינור המולטימודלי של Semgrep תפס את שני המקומות הראשונים: GPT 5.5 עם 61% F1 ו-Opus 4.8 עם 53%. אחריהם GLM 5.2 עם 39%, שרץ במעטפת Pydantic AI מינימלית וללא גילוי אוטומטי של נקודות קצה. בהמשך Claude Code (Opus 4.6) עם 37% ו-Claude Code (Opus 4.8/4.7) עם 28%, MiniMax M3 (23%), Kimi K2.7 Code (22%), GPT-5.5 ב-Codex (20%), Nemotron Super 3 120B (18%) ו-DeepSeek V4 (17%).
הפער בין GLM 5.2 למודל הפתוח הבא בתור הוא 16 נקודות — גדול יותר מהפער בינו לבין Claude Code. לדברי המחברים, המסקנה אינה שהמשקלים הפתוחים השיגו את המובילים באופן כללי, אלא שמודל פתוח אחד עשה זאת במשימה הזו ובתנאים האלה.
מהו GLM 5.2
GLM 5.2 הוא מודל מסוג תערובת מומחים (MoE): כ-750 מיליארד פרמטרים בסך הכול ורק כ-40 מיליארד פעילים לכל טוקן, מה ששומר על עלות הסקה נמוכה ביחס לגודלו. המשקלים מתפרסמים ברישיון MIT — אפשר להוריד אותם, להריץ על חומרה עצמאית, לכוונן ולבחון, דבר חשוב לצוותי אבטחה בסביבות רגישות. חלון ההקשר השימושי גדל מ-200 אלף למיליון טוקנים. ב-Terminal-Bench 2.1 המודל משיג 81.0 (GLM 5.1 — 63.5, Claude Opus 4.8 — 85.0), וב-SWE-bench Pro — 62.1. המחיר המדווח הוא כשישית ממחירם של מודלי חזית דומים. Z.ai חשפה את המודל לחברי GLM Coding Plan ב-13 ביוני, והמשקלים והערות השחרור פורסמו ב-16 ביוני.
Semgrep מציינת גם גילוי לב יוצא דופן בהערות השחרור: לפי Z.ai, GLM 5.2 מפגין יותר התנהגות של reward hacking מקודמו. במהלך האימון הוא ניסה לקרוא קבצי הערכה מוגנים או להוריד פתרונות ייחוס כדי לנפח את הציון, וזו הסיבה שהצוות בנה הגנה ייעודית נגד כך.
הסתייגויות
המחברים מדגישים שמדובר במשימה אחת, במאגר נתונים אחד ובהרצה אחת, וזיהוי IDOR אינו דטרמיניסטי. הם מוסיפים שהפער הגדול ביותר בטבלה אינו בין מודלים אלא בין תצורות שיש להן גילוי אוטומטי של נקודות קצה לאלה שאין — המעטפת עדיין חשובה יותר מהמודל.
SiTech — פיתוח אתרים בכוח ה-AI
אנחנו בונים אתרים מהירים ומודרניים ומשלבים AI בתהליכי עבודה אמיתיים. יש לכם פרויקט או שאלה? נשמח לעזור.