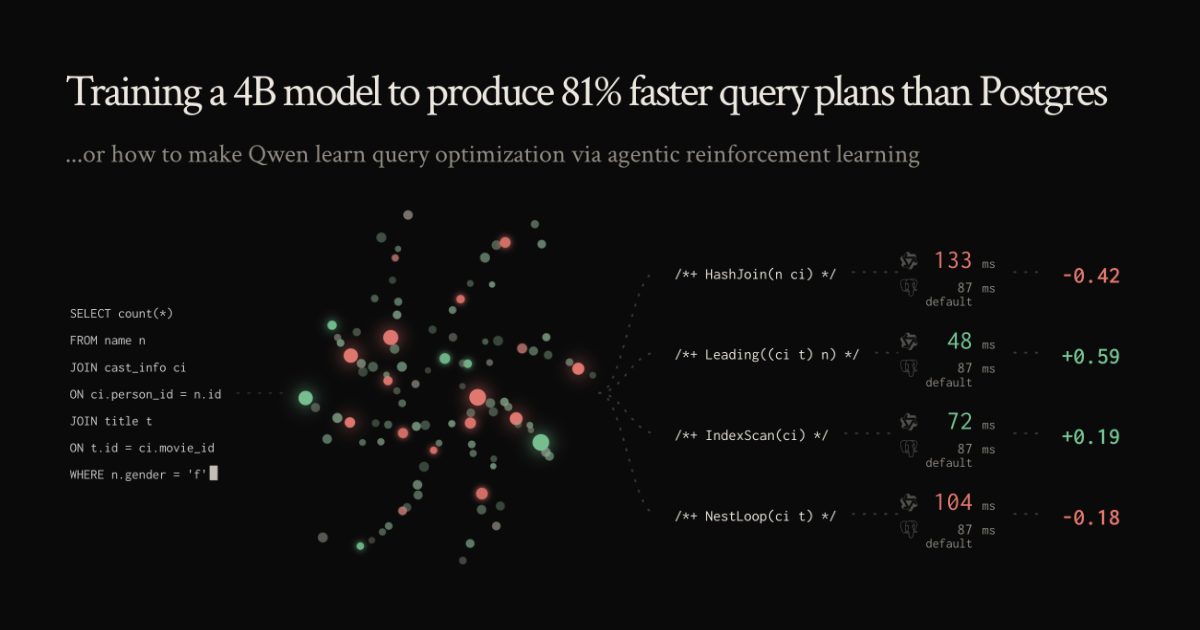
מודל 4B שאומן ב-RL מייצר תוכניות שאילתה מהירות ב-81% מ-Postgres
רוהן בנסאל אימן מודל פתוח בן 4 מיליארד פרמטרים לנווט את המתכנן של PostgreSQL באמצעות רמזי pg_hint_plan. ב-113 שאילתות מרובות-חיבורים ירד זמן האחזור הכולל ב-44.7%.
מודל קטן מול המתכנן של Postgres
רוהן בנסאל פרסם ניסוי שמראה שאפשר לאמן בדיעבד מודל שפה קטן ובעל משקלים פתוחים כך שייצר עבור PostgreSQL תוכניות שאילתה טובות מאלה שהמסד עצמו מייצר. במדד Join Order Benchmark (JOB) — 113 שאילתות SQL עמוסות חיבורים על מאגר הנתונים IMDb — הגיע המודל המאומן בן 4B, לאחר בחירת המועמד הטוב ביותר, להאצה של פי 1.81 בממוצע גאומטרי, וזמן האחזור הכולל ירד ב-44.7%. אותה נקודת ביקורת רשמה 68 ניצחונות ואפס נסיגות.
נקודת המוצא הייתה עגומה: המודל שאינו מאומן לא הצליח לייצר תוכנית שמישה עבור 99 מתוך 113 השאילתות, ורק 14 ניסיונות הניבו מועמד תקין. הסבר המחבר הוא שמכונני שאילתות הם בעיה קשה — סדר החיבורים ידוע כבעיה NP-קשה, והמתכנן אומד קרדינליות מתוך סטטיסטיקות במקום לספור שורות — אבל אימות תוכנית הוא קל, מפני שהקריטריון היחיד הוא זמן ההרצה. האסימטריה הזאת היא שהופכת את הבעיה למתאימה ללמידת חיזוק.
רמזים, סביבת סוכן ודיסטילציה
המודל אינו מחליף את המתכנן אלא מנווט אותו. בנסאל השתמש ב-pg_hint_plan, הרחבה חיצונית שמקבלת רמזים מובנים בתוך הערות SQL, ובנה סביבת סוכן בשם qo-agent עם שישה כלים. הסוכן בוחן טבלאות וסטטיסטיקות עמודות, קורא את תוכנית ברירת המחדל, שולח פעולות תוכנית מועמדות, ואז או משאיר את התוכנית של Postgres או מסיים עם תוכנית משלו. כל מועמד מתורגם לרמזים, רץ, ונמדד מול ברירת המחדל.
האימון נעשה בשני שלבים. ראשית למידה מונחית בטכניקת דיסטילציה off-policy מ-500 מסלולי סוכן של GPT-6 Astra, שבה עודכן מתאם LoRA בנפח 42.5 מגה-בייט בלבד, עם 21.2 מיליון פרמטרים לאימון, מעל מודל Qwen נגזר בן 4.66 מיליארד פרמטרים. שתי תקופות אימון שיפרו את התוצאות והשלישית הרעה אותן, אף שהפסד הוולידציה הפסיק לזוז — תזכורת, מציין המחבר, לכך שעקומה שטוחה אינה מוכיחה שהמודל חדל ללמוד.
תגמולים בסביבה רועשת
השלב השני היה למידת חיזוק סוכנית עם וריאנט מותאם של GRPO. ההאצה חושבה כממוצע החציוני של שלוש מדידות תוכנית ברירת המחדל חלקי החציון של שלוש מדידות מועמד, ולכן עמדת המדידה נבנתה בקפידה: ארבעה מכולות PostgreSQL על מכונה אחת יוצרות תחרות על מטמון העמודים של לינוקס, שמזהמת את התיזמון. האימון פוצל בין שני מקומות — vLLM והמאמן על צומת 2x H100 שכור, ומכולות מסד הנתונים על שולחנו של המחבר. נוסחת התגמול הראשונית דחפה את המודל להחזיר שוב ושוב את תוכנית ברירת המחדל של Postgres; הפתרון היה להשוות ריצות זו לזו במקום לתת להן ציון מוחלט.
מה המודל למד
ניתוח נקודת הביקורת הסופית, לאחר 1,200 עדכונים, מראה כי 295 מתוך 337 חיפושים בחנו תחילה טבלה, סטטיסטיקת עמודה או את תוכנית ברירת המחדל, ו-235 מתוך 339 ניצלו את כל חמשת ניסיונות המועמדים. הפרויקט עלה כ-1,200 דולר: כ-95 שעות של צומת 2x H100 ב-Lambda ועוד 400 דולר בעמלות API של OpenAI עבור מסלולי ההדגמה. מסקנתו של בנסאל אינה שמודלים גדולים התיישנו — הדיסטילציה מ-Astra היא הסיבה שהמודל הקטן עובד בכלל — אלא שמודלים קטנים ראויים ליחס רציני במשימות צרות שקל לאמת אותן.
SiTech — פיתוח אתרים בכוח ה-AI
אנחנו בונים אתרים מהירים ומודרניים ומשלבים AI בתהליכי עבודה אמיתיים. יש לכם פרויקט או שאלה? נשמח לעזור.