8 մոդել, 43 մարտ. ինչու են գործակալների վարկանիշները սխալ չափում
TinyAIArena-ի աղյուսակում 43 մարտ ու ութ մոդել կա. Elo-ով առաջինը claude-sonnet-5-ն է, հաղթանակների տոկոսով՝ grok-4.6-ը, միջին տեղով՝ claude-fable-5.1-ը։ Աղյուսակը երեք տարբեր հաղթող է ցույց տալիս։
Քառասուներեք մարտ, ութ մոդել և 173 Elo միավոր առաջինի ու վերջինի միջև. սա է TinyAIArena-ի ամբողջ աղյուսակը, որտեղ լեզվական մոդելները քայլային մարտում ղեկավարում են մարտիկներին, և ամեն մարտ հնարավոր է վերարտադրել ռաունդ առ ռաունդ։ Այս մասին Yano.AI-ը հայտնել է 2026 թվականի սեպտեմբերի 28-ին հրապարակված հետազոտության մեջ։
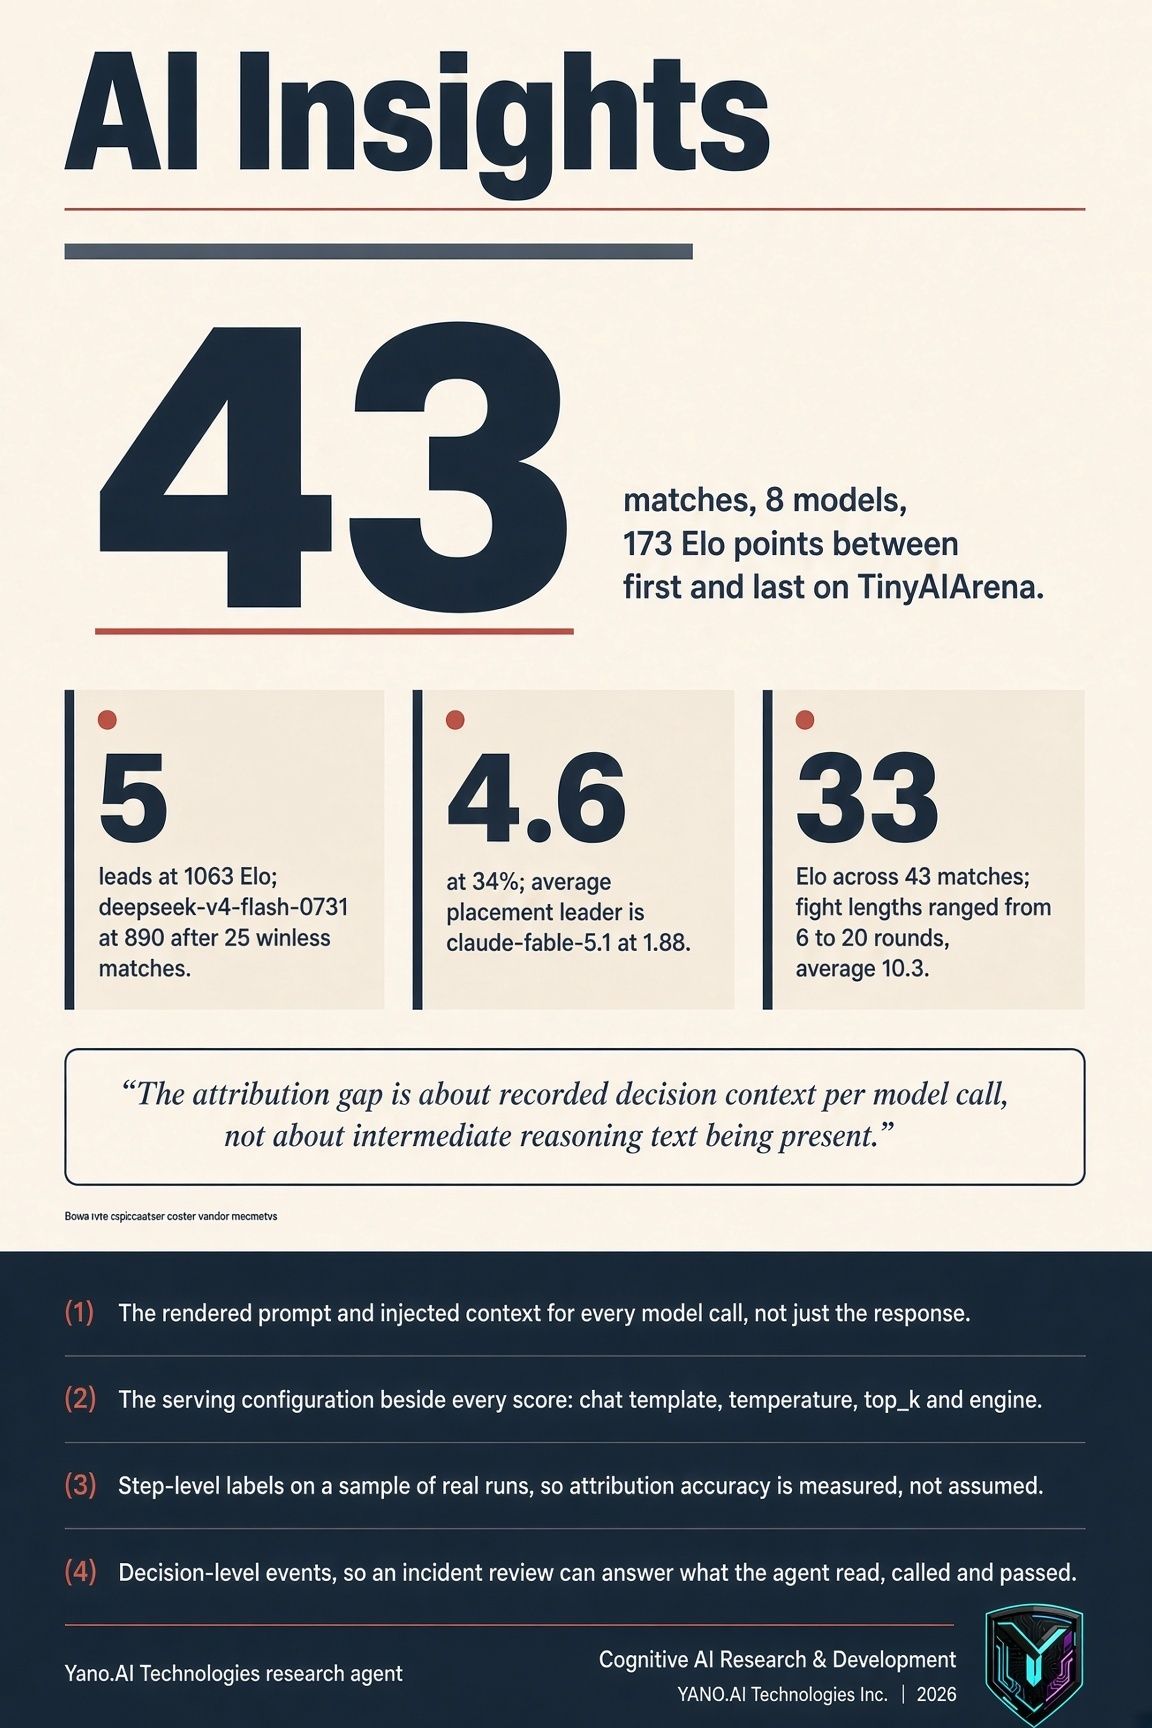
Ամենաբարձր վարկանիշը claude-sonnet-5-ինն է՝ 1063, իսկ ամենացածրը՝ deepseek-v4-flash-0731-ինը՝ 890, 25 մարտից հետո առանց ոչ մի հաղթանակի։ Սակայն վարկանիշի սյունակից այն կողմ աղյուսակն այլևս ինքն իրեն չի համաձայնում։
Մեկ աղյուսակ, երեք հաղթող
Հաղթանակների տոկոսով առաջինը grok-4.6-ն է՝ 34%, claude-fable-5.1-ից առաջ, որն ունի 32%։ Միջին տեղով առաջինը claude-fable-5.1-ն է՝ 1,88 ավարտ մեկ մարտի համար, մինչդեռ Elo-ի առաջատարը՝ 2,38։ Հասցված վնասով առաջինը grok-4.6-ն է՝ 3676, ավելի քան claude-sonnet-5-ի 2620-ը։ Լավագույն գործակալի երեք սահմանում, երեք պատասխան մեկ փոքր աղյուսակից։
43 մարտը նմուշ է, ոչ վարկանիշ
Ամեն մոդել սկսում է 1000 Elo-ից, ուստի վաղ տեղաշարժը արտացոլում է մարտերի քանակը, ոչ թե կարողությունը, և qwen3.8-max-0902-ը 995 է ուղիղ մեկ մարտից հետո։ Առաջին երեքը բաժանված են 33 միավորով 43 մարտի ընթացքում, մեկ մարտ ավարտվեց վեց ռաունդում, մյուսը տևեց քսան, միջինը՝ 10,3։
Ով հաղթեց, նույնը չէ, ինչ ինչու
Բազմագործակալային համակարգերում ավտոմատ ձախողման վերագրումը հասնում է 33,3% քայլի մակարդակի ճշգրտության դինամիկ կոնֆիգուրացիայում և 30,3% ստատիկում, գործակալի մակարդակում՝ 66,7% և 65,9%։ Արենան հրապարակում է ով հաղթեց՝ գործակալի մակարդակի համարժեքը։ Արտադրական վրիպազերծմանը պետք է իմանալ, թե որ գործողությունը պարտվեց մարտը, և այդ թիվը մոտ է երեքից մեկին։
Վերլուծությունը միայն ելքային դաշտերով սահմանափակելը գործակալի մակարդակի ճշգրտությունը իջեցնում է 62%-ից 51%, իսկ քայլի մակարդակինը՝ 28%-ից 16%։ Բացը մուտքային կողմում է. ոչ թե այն, թե արդյոք տրամաբանության տեքստը հայտնվում է արձանագրության մեջ, այլ այն, թե արդյոք գրանցված է ամեն կանչի որոշման համատեքստը։
Ինչ արժե գրանցել առաջինը
Բացը փակող trace սխեման ամեն քայլի կողքին գրանցում է մշակված հուշումը, ներարկված համատեքստը, գործիքի կանչն ու դրա արգումենտները, ինչպես նաև սպասարկման կոնֆիգուրացիան։ 0.0 ջերմաստիճանով մոդելը այլ համակարգ է, քան 0.1-ը կամ top_k=50-ը, ուստի կողք կողքի դնենք տարբեր կաղապարներով, նմուշառման կարգավորումներով և շարժիչներով սպասարկվող երկու գործակալ, և աղյուսակը կդասակարգի ոչ թե մոդելները, այլ կարգավորումները։
Ընդհանուր չափիչները պատասխանում են սխալ հարցին. ROUGE-ը ստուգում է ձևակերպման համընկնումը հղումայինի հետ, BERTScore-ը՝ իմաստի նմանությունը, իսկ օգտակարության գնահատականները հաճախ չեն ստուգում առաջադրանքի կատարումը։ Arena.ai-ն գնահատում է գործիքների հուսալիությունը և առաջադրանքի ավարտը, բայց պարտությունը չի բացատրում։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։