AI գործակալները ստեղծում են խմբագրելի 3D տեսարաններ, սակայն դժվարանում են գնահատել ճշգրտությունը
LEGO-Anything-ը լուսանկարները վերածում է խմբագրելի Blender-ի կոդի, իսկ նրա բենչմարկը ցույց է տալիս, որ կոդավորման գործակալները կարող են ստեղծել օգտակար տեսարաններ, սակայն հաճախ սխալ են գնահատում երկրաչափությունը և կորցնում ճշգրտությունը։
Լուսանկարից մինչև խմբագրելի Blender-ի կոդ
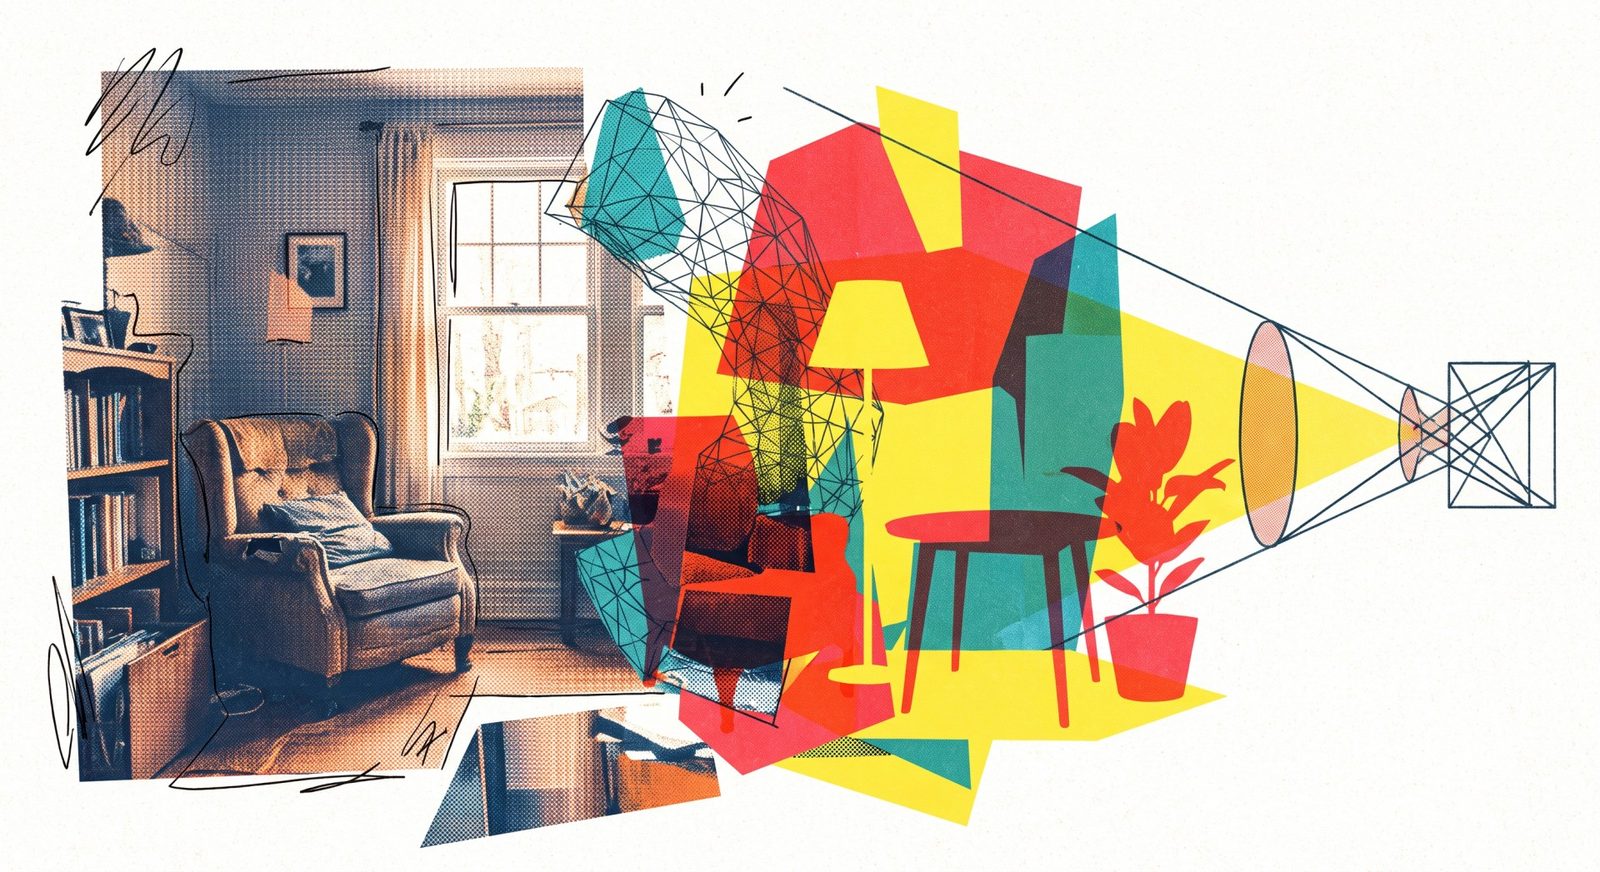
LEGO-Anything-ը՝ Մերիլենդի համալսարանի և AWS-ի հետազոտողների նախագիծը, օգտագործում է կոդավորման գործակալ՝ մեկ լուսանկարն աշխատող Blender-ի ծրագրի վերածելու համար։ Գործակալը գրում է կոդ, գործարկում այն, ստուգում արդյունքը և փոխում տեսարանը, մինչև այն չնմանվի սկզբնական պատկերին։
Image-to-Code կոչվող մոտեցումը ստեղծում է ավելին, քան միայն ռենդերացված պատկերը։ Օբյեկտները, երկրաչափությունը, դասավորությունը և տեսախցիկի դիրքը հստակ ներկայացված են ծրագրում, որը կարելի է գործարկել, դիտել, խմբագրել և օգտագործել պատկերի վերլուծության համար։
Բենչմարկ՝ սիմուլյատորի հղումային տվյալներով
Թիմը ներկայացրել է LEGO-Bench-ը՝ ստացված տեսարանները գնահատելու համար։ Այն պարունակում է 208 պատկեր 104 փակ և բացօթյա տեսարաններից և օգտագործում է 443 գրանցված ակտիվ։ Պատկերները ռենդերվում են պրոֆեսիոնալ կերպով հավաքված սիմուլյատորի տեսարաններից, ինչը մուտքային տվյալներին բնական տեսք է հաղորդում և միաժամանակ պահպանում է ճշգրիտ երկրաչափությունը, խորությունը և օբյեկտների պատկանելությունը՝ որպես հղումային ճշմարտություն։
Տեսարանի բարդությունը կարելի է մեծացնել՝ առանց լուսավորության կամ տեսախցիկի պարամետրերը փոխելու։ Բենչմարկը գնահատում է վավերականությունը, երկրաչափական ճշգրտությունը և սկզբնականին վիզուալ նմանությունը։ Արտաքին տեսքը չափվում է ներկայացված տեսարանի վերառենդերով և հղումային պատկերի հետ պիքսել-պիքսել համեմատությամբ։
Օգտակար տեսարաններ, թույլ երկրաչափական դատողություն
Ստուգված GPT կոնֆիգուրացիաներից բոլոր վեցը գրեթե միշտ տալիս էին աշխատող տեսարան, սակայն դրանց ճշգրտությունը լայնորեն տարբերվում էր։ GPT-6 Astra-ն՝ լավագույն ստուգված մոդելը, փակ տեսարաններում գրանցել է 53,4%, իսկ բացօթյա տեսարաններում՝ 39,6%։ Որոշ թույլ կոնֆիգուրացիաներ հասել են մոտ 15%-ի։ Ճշգրտությունը նվազում էր տեսարանների բարդացմանը զուգընթաց, իսկ բացօթյա տեսարանները ավելի դժվար էին, քան ինտերիերը։
Մտածողության բյուջեի ավելացումը բարելավեց GPT-6 տարբերակները։ Գրասենյակի թեստային ենթախմբում Astra-ի միավորը 32,3%-ից բարձրացավ մինչև 61,8%։ Գործակալների աշխատանքի վերլուծությունը բացահայտեց վատ սկզբնական փորձեր, վերանայումների ընթացքում նախկին առաջընթացի չեղարկում և անվստահելի ինքնագնահատում՝ որպես տարածված խնդիրներ։ Հետազոտողները նաև արձանագրեցին, որ Astra-ն ուշ վերանայումից հետո 33,9%-ից ընկավ մինչև 4,4%։
Երբ մոդելներին խնդրեցին որոշել, թե երկու տարբերակներից որն է ավելի համապատասխան սկզբնականին, նրանց երկրաչափական դատողությունը մոտ էր պատահականության մակարդակին կամ դրանից ցածր։ Հետազոտողները եզրակացրին, որ բարելավումը պետք է հիմնվի կոնկրետ չափումների վրա, այլ ոչ թե գործակալի սեփական աշխատանքի գնահատման։
Փլագինը և տեսողության հետագա թեստերը
Ստացված LEGO-Plugin-ը լրացուցիչ մարզում չի պահանջում։ Այն սկզբնական տեսարանը խարսխում է հղումային պատկերին, ինքնագնահատումը փոխարինում է կոնկրետ չափումներով և պաշտպանում է ճիշտ առաջընթացը ռեգրեսիվ խմբագրումներից։ Փլագինը բարելավեց բոլոր վեց ստուգված մոդելները, իսկ թույլ ագենտները ստացան մինչև 62,7% աճ։ Ամենաուժեղ մոդելն ավելացրեց մոտավորապես երկու տոկոսային կետ։
Թիմը նաև ստուգեց վերակառուցված տեսարանները որպես մուտքային տվյալներ օբյեկտի ճանաչման, սեգմենտավորման և խորության գնահատման համար։ Առանց լրացուցիչ մարզման՝ նրանք ստացան օգտակար, թեև արտասովոր արդյունքներ։ Օբյեկտի ճանաչումը լավագույնս աշխատեց և հասավ մասնագիտացված DINO մոդելի արդյունքի մոտավորապես կեսին։ Մասնագիտացված մոդելների՝ SAM 3-ի և Depth Anything 3-ի դեպքում, տարբերությունը ավելի մեծ էր սեգմենտավորման և խորության գնահատման մեջ։ Հետազոտողները ասացին, որ ներկայիս կոդավորման ագենտները խոստումնալից են, բայց դեռ չեն ստեղծում տեսարանի ծրագրեր, որոնք բավականաչափ ճշգրիտ են հավատարիմ վերակառուցման համար։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։