AMD-ն ասում է, որ MEXT-ը կարող է պահպանել սերվերի կատարողականության 95%-ը DRAM-ի կեսով
AMD-ն ասում է, որ MEXT-ը կարող է 20%-ից 75%-ով կրճատել սերվերների DRAM-ի օգտագործումը՝ պահպանելով կատարողականության մեծ մասը։ Այն տեղակայված է 145 սերվերում, իսկ հաջորդ տարի նախատեսվում է հասցնել 2,000-ի։
AMD-ն ներկայացրել է, թե ինչպես MEXT-ը՝ կանխատեսող հիշողության շարժիչը, կարող է կրճատել սերվերներում անհրաժեշտ ֆիզիկական DRAM-ը՝ պահպանելով կատարողականության մեծ մասը։ MEXT-ը պնդում է, որ ապահովում է լիարժեք DRAM-ով համակարգի կատարողականության 99%-ից ավելին՝ աշխատելով ֆիզիկական DIMM-ների ընդամենը 25%-ով։ Տեխնոլոգիան սառը էջերը տեղափոխում է flash պահեստավորում և AI մոդելով վերադարձնում դրանք նախքան կարիքը։
Ինչպես է MEXT-ը հիշողությունը տեղափոխում flash
MEXT-ը սառը հիշողության էջերը բեռնաթափում է flash պահեստավորում, սակայն բացակայող հիշողությունը օպերացիոն համակարգի համար դեռևս գրանցվում է որպես տեղադրված DRAM։ Քանի որ flash-ը DRAM-ից դանդաղ է, MEXT-ը AI մոդելով կանխատեսում է, թե որ էջերը կպահանջվեն, և վերադարձնում է դրանք նախքան պահանջվելը։ AMD-ն ասում է, որ մոդելը առաջին տեղակայման ժամանակ ուսուցանվում է մեկ վայրկյանից պակաս ժամանակում, աշխատում է մեկ EPYC միջուկի վրա՝ առանց GPU-ի, և շարունակում է ուսուցանվել աշխատանքի ընթացքում։ MEXT-ը Linux միջուկի մոդուլ է, որն աշխատում է ցանկացած Linux բաշխման հետ, և օգտագործում է AI մոդելների անսամբլ՝ transformer-ի վրա հիմնված մեծ լեզվական մոդելի գլխավորությամբ։
AMD-ի ներքին կատարողականության պնդումները
Որոշ ներքին բեռներում, օրինակ՝ Synopsys PrimeTime-ում, AMD-ն ասում է, որ 50% DRAM հզորությամբ աշխատող սերվերները պահպանում են լիարժեք սերվերի կատարողականության 95%-ը, իսկ 25% հզորությունը՝ 80%-ը։ 5-րդ սերնդի EPYC պրոցեսորներով երեք հանգույցից բաղկացած Azure կլաստերում MEXT-ը TPC-DS բենչմարկի Spark SQL աշխատանքային բեռի վրա 50% DRAM հզորության դեպքում ապահովել է լիարժեք կլաստերի կատարողականության 99%-ը։ Գործակալային AI-ի համար AMD-ն պնդում է 99%՝ 50% հիշողության հզորության դեպքում, և 85%՝ 25%-ի դեպքում, ըստ հինգ գործակալների միաժամանակյա աշխատանքի երկրաչափական միջինի։ Հիշողության նկատմամբ պահանջկոտ գործակալի համար AMD-ն պնդում է 90%՝ 50% հզորության դեպքում, և 88%՝ 25%-ի դեպքում։
Տեղակայում և տարածում
AMD-ն MEXT-ը ներքին կարգով տեղակայել է 145 սերվերում և ասում է, որ հաջորդ տարի կընդլայնի մինչև 2,000 սերվեր։ Ընկերությունը նաև հայտարարել է HPE-ի հետ գործընկերության մասին՝ MEXT-ը հաճախորդներին հասցնելու համար։ 1-ին փուլը ներառում է որոշ EPYC Venice սերվերներ՝ MEXT Ready պիտակով և առանձին NVMe սկավառակով կամ բայով՝ բեռնաթափման համար։ 2-րդ փուլը այդ սերվերներին կբերի MEXT լիցենզիաներ և RAM View հավելվածը, սակայն AMD-ն չի նշել, թե երբ կսկսվի այն։
Աշխատանքային բեռներ և սահմանափակումներ
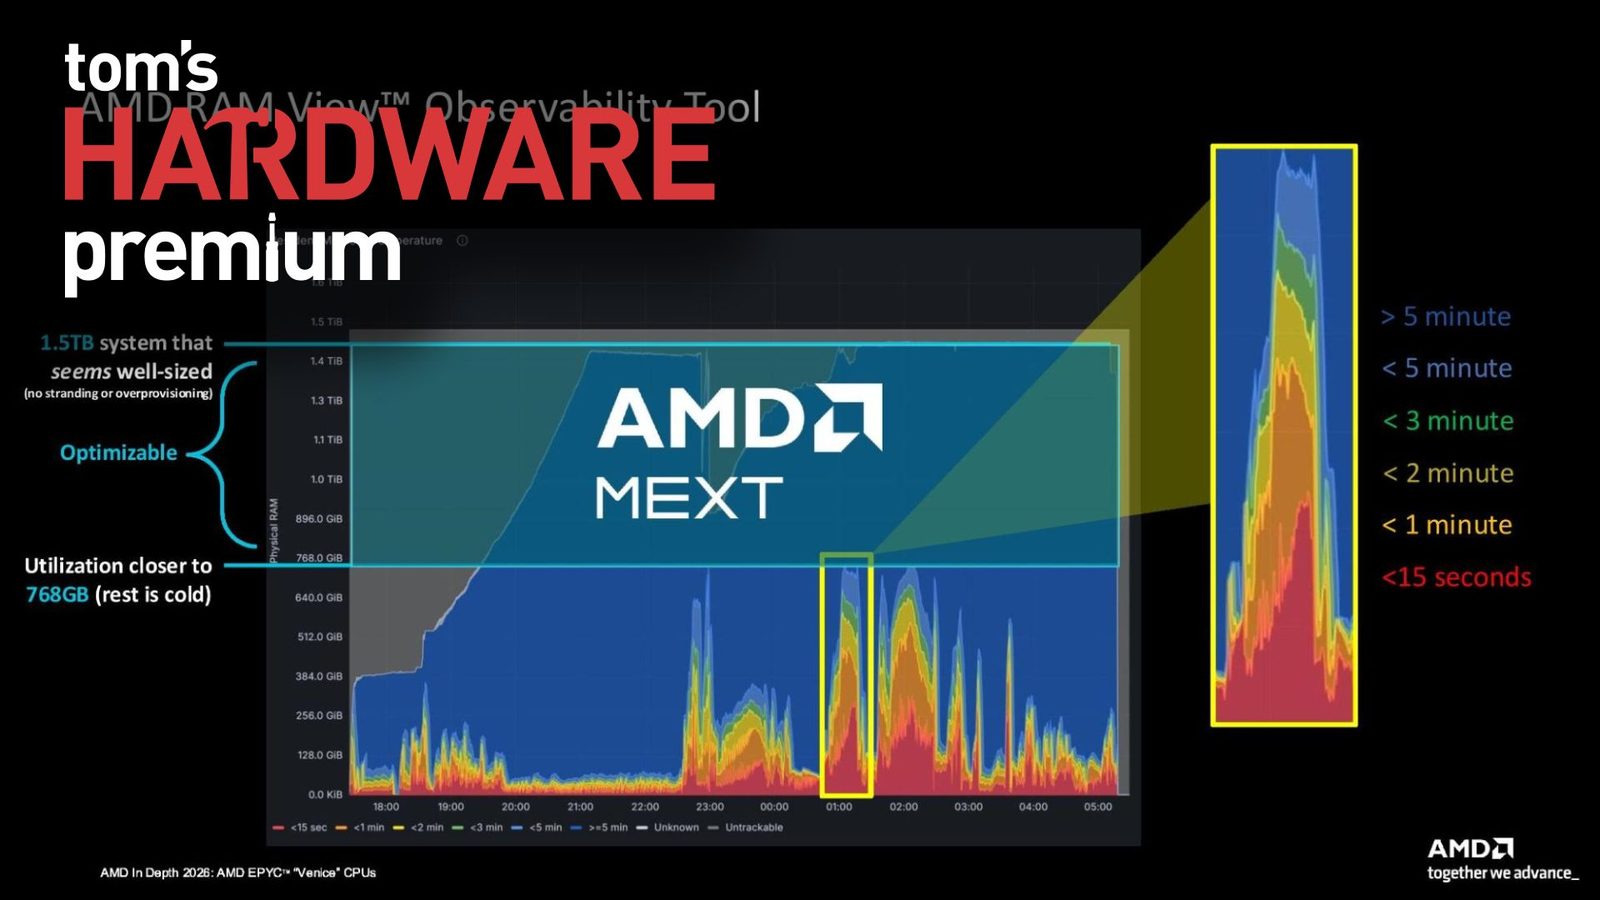
AMD-ն սկզբում MEXT-ը կիրառում է իր ներքին օգտագործման կրիտիկական EDA հավելվածների վրա, այդ թվում՝ Synopsys PrimeTime-ի, և օպտիմիզացնում է գործակալային AI-ի, տվյալների բազաների, մեդիայի ու ժամանցի բեռները։ Ընկերությունը ասում է, որ շատ բեռներ կարող են հզորությունը կրճատել մոտ 20%-ից 25%-ով, իսկ ավելի մեծ կրճատումների դեպքում հավելվածները դառնում են ավելի մասնագիտացված և կատարողականության տարբերությունները մեծանում են։ RAM View-ը ցույց է տալիս, թե որ էջերն են տաք, և որոնք՝ սառը։ Մեկ ընդհանրացված օրինակում 1,5 TB հիշողություն ունեցող համակարգը ցույց է տվել գրեթե լիարժեք օգտագործում, ընդ որում էջերի մոտ կեսին հինգ րոպե կամ ավելի չեն դիպել։ AMD-ն չի պարզաբանել այդ օրինակի բեռը և չի կիսվել որոշ բենչմարկ սլայդների ծանոթագրություններով։
Աղբյուրներ: Tom's Hardware · The Register
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։