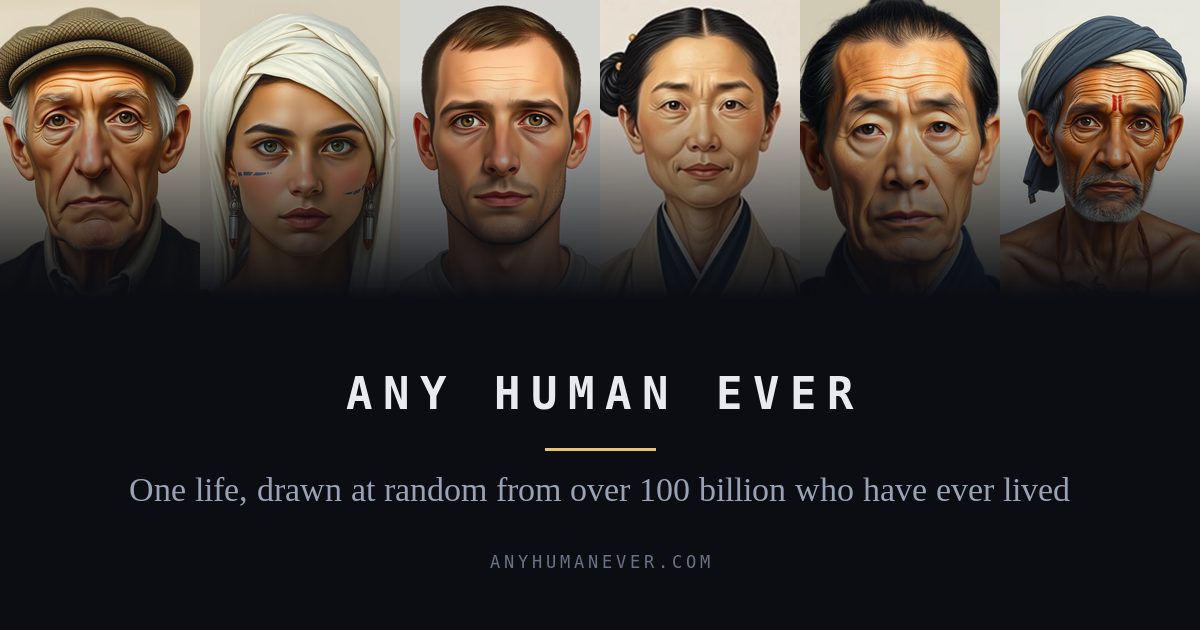
Any Human Ever. մեկ կյանք՝ պատահականորեն 100 միլիարդ մարդուց
Նախագիծը իրական ժողովրդագրական տվյալներից պատահականորեն ընտրում է տարի, վայր և կյանք, ապա պատմում պատմությունը։ Աղբյուրների էջը փաստագրում է 326 աշխատանք և 87 830 տող՝ յուրաքանչյուրը ծագման նշումով։
Any Human Ever կոչվող նոր կայքը ժողովրդագրական և պատմական տվյալները վերածում է պատահականորեն ընտրված մեկ կյանքի։ Գլխավոր էջը գաղափարը ձևակերպում է մեկ տողով. «Ավելի քան 100 000 000 000 մարդ երբևէ ապրել է։ Ընտրիր մեկին»։ Այցելուն սեղմում է կոճակը, և կայքը քայլ առ քայլ ընտրում է տարին, վայրը և կյանքը. ամեն մեկը վերցված է իրական տվյալներից, պատահականորեն, ապա պատմում է ստացված պատմությունը։ Կայքի սեփական նկարագրությունը խոստանում է, որ ամեն մանրամասն ունի աղբյուր։
Ինչպես է աշխատում ընտրությունը
Առաջին փուլը ծննդյան տարին է։ Գրեթե բոլորը, ովքեր երբևէ ապրել են, ծնվել են վերջերս, բացատրում է կայքը, որովհետև բնակչությունը աճում էր էքսպոնենցիալ, ուստի պատահական ծնունդը շատ ավելի հավանական է մոտիկ անցյալում։ Այս փաստարկը ցուցադրվում է բնակչության գրաֆիկով, որտեղ կարելի է փոխել լոգարիթմական և գծային առանցքները։ Երկրորդ փուլը վայրն է՝ աշխարհի քարտեզի վրա, որտեղ ավելի վառ կուտակումները նշանակում են ավելի շատ մարդ։ Երրորդ փուլը ավելացնում է ժողովրդագրական ցուցանիշներ և ժամանակագիծ, իսկ չորրորդը ներկայացնում է պատմությունը՝ ուղիղ նշումով, որ ընտրված մարդը իրական անհատ չէ։
Նկարները միայն ցանկության դեպքում
Ամեն կյանքի համար առաջարկվում է նկար, սակայն այն թաքնված է մնում, քանի դեռ անջատիչը միացված չէ։ Կայքը նշում է, որ պատկերները ստեղծվել են FLUX.1-schnell մոդելով՝ հեղինակի սեփական նոթբուքում, և այդ ծանոթագրությունը զետեղված է նկարի տակ։ Զննարկիչում ընտրված կյանքերը պահվում են տեղում. պատկերասրահը տեղավորում է մինչև 100 գրառում, և ամեն մեկն ունի տարածելի հղում։
Որտեղից են գալիս տվյալները
Աղբյուրների էջը թվարկում է 326 տվյալների հավաքածու և գիտական աշխատանք, որոնք 80 աղյուսակներում տալիս են 87 830 տող, և ամեն տող նշում է ըստ ծագման։ «Extracted» տողերը (տողերի 72.0%-ը, ընթերցողի տեսած հղումների 14.2%-ը) վերցված են մեջբերված հրատարակչից ներբեռնված աղյուսակից։ «Derived» ցուցանիշները (11.1% / 1.5%) հաշվարկված են մեջբերված թվերից, իսկ թվաբանությունը գրված է տողի մեջ։ «Attributed» արժեքները (7.7% / 47.6%) գրել է մոդելը՝ պնդելով, որ այդպես ասված է աղբյուրում։ «Context» տողերը (3.7% / 22.5%) աղբյուրն օգտագործում են կատեգորիաների համար, մինչդեռ թիվը սահմանել է մոդելը։ «Authored» փաստերը (5.6% / 14.1%) մոդելի պնդումներ են առանց մեջբերելի աղբյուրի և բոլորը գրանցված են RH109 նույնացուցիչով։ Այս մասնաբաժինները չափվել են 200 կյանքով՝ 2026 թվականի սեպտեմբերի 21-ին։ Աղբյուրների ամենամեծ կատեգորիան ընտանիքը, աշխատանքը և հասարակությունն է՝ 85 գրառմամբ, ապա կլիման ու երկինքը (66), հավատը, լեզուն և թաղումը (57). պատերազմն ու հակամարտությունը ներկայացված են մեկ աղբյուրով։
Ինչու է ստեղծվել
«Մեր մասին» էջում նախագիծը պնդում է, որ գրավոր պատմությունը կողմնակալ նմուշ է. ֆրանկական թագավորների հաջորդականության մասին ավելի շատ բան հայտնի է, քան V դարի Ավինյոնի սովորական գյուղացու առօրյայի մասին, թեև երբևէ ապրած մարդկանց մեծամասնությունը ասիացի էր, աղքատ ու կարճ կյանքով։ Նախագծի հարցն այն է, թե ինչ կլիներ, եթե պատմությունները քաղվեին իրական տվյալներից և պատահականացվեին՝ մարդկության անցյալը արդարացիորեն ներկայացնելու համար։ Էջում մեջբերվում է նաև բանաստեղծուհի Մյուրիել Ռուկեյզերի խոսքերը. «Տիեզերքը կազմված է պատմություններից, ոչ թե ատոմներից»։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։