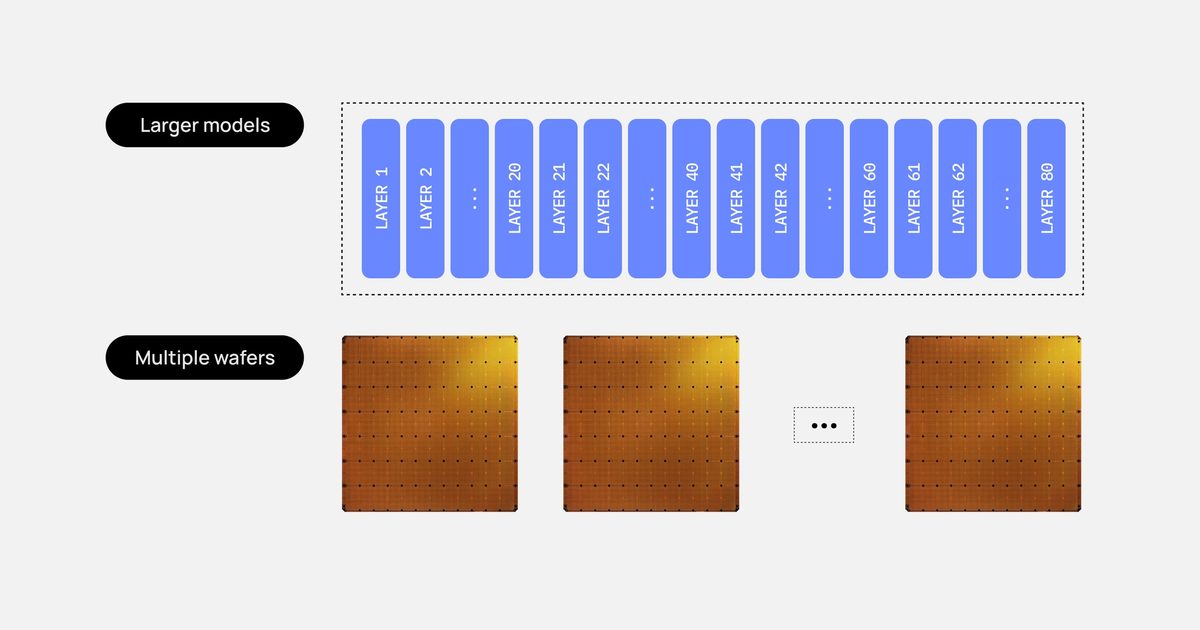
Cerebras-ը բացատրում է, թե ինչպես է տրիլիոն պարամետրով AI մոդելները տեղակայում wafer-scale չիպերում
Cerebras-ը ներկայացնում է, թե ինչպես է մեծ frontier մոդելները բաժանում WSE-3T wafer-ների միջև՝ օգտագործելով Kimi K3-ը որպես օրինակ՝ բացատրելու on-chip հիշողությունը, pipeline-ը և միաժամանակյա հարցումների մշակումը։
Cerebras-ը բացատրել է տրիլիոն պարամետրով frontier մոդելների տեղակայումը wafer-scale չիպերում։ Մեկ WSE-3T wafer-ն ունի 44 GB on-chip հիշողություն, իսկ տրիլիոն պարամետրով մոդելների կշիռները՝ տերաբայթեր։ Ըստ Cerebras-ի՝ մեծ մոդելը բաժանվում է մի քանի WSE-3T wafer-ների միջև՝ բազմատրիլիոն պարամետրով մոդելները վայրկյանում 1000-2000+ թոքենով աշխատեցնելու համար։
Kimi K3-ը որպես օրինակ
Օրինակ՝ բաց կոդով Kimi K3-ն է։ Այն ունի մոտ 3 տրիլիոն պարամետր՝ 69 linear-attention և 24 dense շերտերով։ Cerebras-ը նշում է, որ Kimi K3-ը Terminal-Bench 2.1-ում ստանում է 88.3%, GPT-5.6 Sol-ը՝ 88.8%, BrowseComp-ում՝ 91.2%, GPT-5.6 Sol-ը՝ 90.4%։ Ըստ Cerebras-ի՝ սա ցույց է տալիս frontier մակարդակի ծրագրավորում և agentic հնարավորություններ, և մոդելը որոշ benchmark-ներում գերազանցում է առաջատար սեփականատիրական մոդելներին։
Օրինակում Cerebras-ը ենթադրում է 256k միջին հարցում, 4-bit կշիռների քվանտացում և 8-bit KV cache։ Այն հաշվարկում է շերտի չափը և մոդելը բաժանում 93 շերտերի։ Ստացվում է մոտ 16 GB մեկ շերտի համար։
Շերտերի քարտեզագրումը wafer-ների վրա
WSE-3T wafer-ի 44 GB տարողությունը որոշում է, թե քանի շերտ է տեղավորվում, և դա կախված է շերտի տեսակից։ Dense շերտերին KV cache-ի համար լրացուցիչ տեղ է պետք, քանի որ յուրաքանչյուր dense full-attention շերտ պահում է բանալիներ և արժեքներ յուրաքանչյուր token-ի համար ամեն ակտիվ հարցումում։ Ուստի Cerebras-ը մեկ wafer-ում դնում է մեկ dense շերտ, իսկ մնացած SRAM-ը՝ KV cache-ի համար։
Linear-attention շերտերին KV cache պետք չէ։ Յուրաքանչյուր token-ի բանալիներ և արժեքներ պահելու փոխարեն՝ այն յուրաքանչյուր հարցման համար պահում է փոքր, ֆիքսված վիճակ՝ անկախ կոնտեքստից։ Դա թողնում է տեղ երկու linear շերտի համար մեկ wafer-ում՝ 2 x 16 GB = 32 GB։ 69 linear և 24 dense շերտերով քարտեզագրումը տալիս է 35 wafer linear և 24 wafer dense շերտերի համար, ընդհանուր 59 wafer։
Pipeline-ի կատարումը և զուգահեռությունը
Cerebras-ը մոդելները կատարում է pipeline-ով։ Կոմպիլյատորը շերտերը քարտեզագրում է wafer-ների վրա, runtime-ը՝ token-ների ուղին։ Wafer-ների միջև անցնում են միայն ակտիվացիաները՝ RDMA over Ethernet-ով, մոտ 2 միկրովայրկյան hop-ի համար։ Քանի որ յուրաքանչյուր wafer ունի 44 GB on-chip SRAM, իսկ շերտը՝ մոտ 16 GB, ամբողջ շերտերը սովորաբար տեղավորվում են չիպում։ Շատ դեպքերում կշիռները չեն տեղաշարժվում, և շերտերը պետք չէ բաժանել wafer-ների միջև։
Wafer-ը հավաքման գծի փուլ է։ Wafer 1-ը կատարում է 1-2 շերտերը և ակտիվացիաները ուղարկում Wafer 2-ին, որը կատարում է 3-4 շերտերը և փոխանցում առաջ, մինչև վերջին wafer-ը տալիս է հաջորդ token-ը։ Cerebras-ը pipeline-ը լցնում է տարբեր հարցումներով։ Փուլերը միաժամանակ աշխատում են տարբեր հարցումների վրա և մշակում micro-batch, ոչ թե մեկ հարցում։ Փոքր micro-batch-երը արագացնում են հարցումը, մեծերը՝ բարձրացնում թողունակությունը։
KV cache-ին հատկացված on-chip հիշողությունը սահմանում է միաժամանակյա հարցումների առավելագույնը։ Յուրաքանչյուր ընթացիկ հարցում ունի իր KV cache-ը յուրաքանչյուր dense-layer wafer-ում։ Cerebras-ը նշում է, որ զուգահեռությունը և batch size-ը ինքնին չեն ցույց տալիս inference-ի արդյունավետությունը։ Ավելի իմաստալից է ընդհանուր token թողունակությունը էներգիայի միավորի հաշվով՝ չափված նույն ելքի արագությամբ։
Աղբյուրներ: cerebras.ai
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։