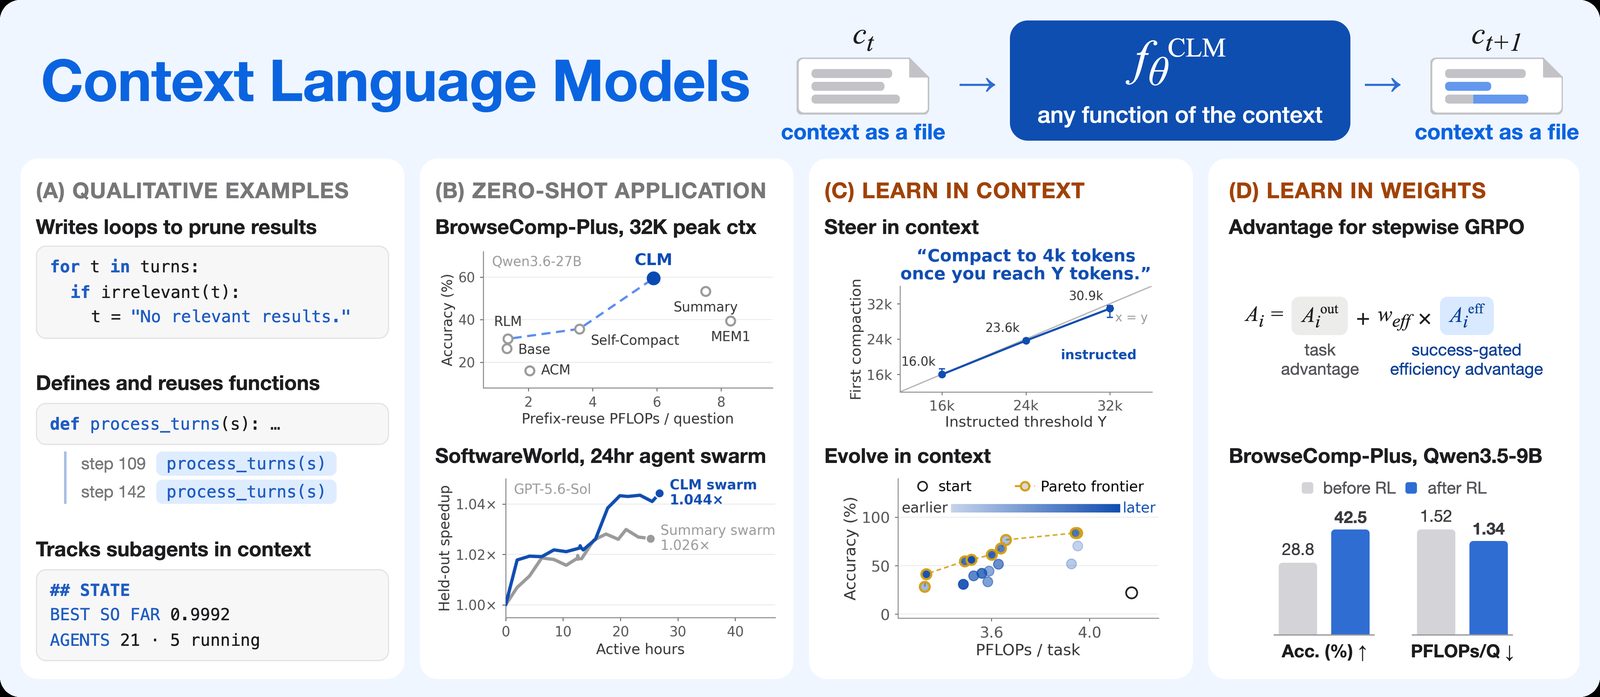
Context Language Models. մոդելներ, որոնք համատեքստը իրենք են կառավարում
Washington-ի համալսարանի, MIT-ի և Meta-ի գիտնականները ներկայացրել են Context Language Models (CLM)․ այն համատեքստը պահում է որպես ֆայլ և ինքն է խմբագրում։ BrowseComp-Plus-ում ճշգրտությունը բարձրացել է 11,4%-ով, ծախսը՝ նվազել 21,5%-ով։
Washington-ի համալսարանի, MIT-ի և Meta-ի հետազոտողները ներկայացրել են Context Language Models (CLM)՝ լեզվական մոդելներ, որոնք իրենք են կառավարում իրենց համատեքստը։ Աշխատությունը arXiv-ում հրապարակվել է սեպտեմբերի 29-ին։
Մինչ այժմ համատեքստը կառավարում էին արտաքին մեխանիզմները՝ ձեռքով հավաքված համակարգերը կամ սահմանափակ գործիքները։ CLM-ում այս գործը վստահված է հենց մոդելին։
Համատեքստը որպես ֆայլ
CLM-ում համատեքստը պահվում է որպես ֆայլ։ Մոդելը կարող է ազատորեն փոփոխություններ մտցնել դրա մեջ՝ կա՛մ ավելացնել նոր թոքեններ, կա՛մ Bash-ի օգնությամբ խմբագրել ցանկացած հատված։ Յուրաքանչյուր փոփոխություն անմիջապես արտացոլվում է մոդելի կենդանի համատեքստում։
Քանի որ համատեքստը առանձին ֆայլ է, մեկ համակարգում կարող են գոյություն ունենալ դրանցից մի քանիսը, և մոտեցումը տարածվում է նաև բազմագենտ համակարգերի վրա։ Թեստերում մոդելները նաև նոր վարքագիծ ցուցադրեցին՝ ստեղծեցին թրեքերներ բազմագենտ նվագախմբության համար, ներմուծեցին չատի նոր դեր ներքին գրառումների համար և սահմանեցին համատեքստի կառավարման բազմակի ֆունկցիաներ։
Հեղինակների խոսքով՝ արդյունքը հաստատում է «Bitter Lesson»-ի գաղափարը՝ ազատությունը մոդելին տալիս է ավելի լավ ռազմավարություններ, քան ձեռքով գրված կանոնները։
Արդյունքներ
CLM-ը աշխատում է առանց լրացուցիչ մարզման այնպիսի մոդելների վրա, ինչպիսիք են Qwen3.6-27B-ը և GPT5.6-Sol-ը։ Խորը հետազոտության BrowseComp-Plus բենչմարկում CLM-ը 32K համատեքստի սահմանաչափով ցույց տվեց 59,4%․ սա 11,4%-ով ավելի բարձր ճշգրտություն է, քան ամենաուժեղ բազային մեթոդը, իսկ FLOPs-ի ծախսը 21,5%-ով պակաս է։
TerminalBench 2.1-ում CLM-ը հասավ ամենաուժեղ մեթոդի ճշգրտությանը, բայց ծախսեց 29,5%-ով պակաս FLOPs։ 12-ժամյա EdgeBench-ում ցույց տվեց 5%-ով ավելի բարձր միավոր՝ 59%-ով պակաս հաշվողական ծախսով։ 24-ժամյա առաջադրանքում, որտեղ ագենտների խումբը աշխատում է վեց փոխկապակցված ռեպոզիտորիաների վրա, նույն բյուջեով հասավ 65%-ով ավելի մեծ արագացման։
Ուսուցում և արդյունավետություն
CLM-ի վարքագիծը կարելի է կառավարել նաև տեքստային հրահանգներով՝ օգտատերը կարող է պարզապես նկարագրել ցանկալի ռազմավարությունը։ Հմտությունների օպտիմալացման ցիկլը ինքն է բարելավում համատեքստի կառավարման հրահանգները․ ContextBench-ում ճշգրտությունը բարձրացավ առավելագույնը 35,9 միավորով, իսկ հաշվողական ծախսը նվազեց։
Առցանց ամրապնդող ուսուցման նոր մեթոդով հեղինակները Qwen3.5-9B մոդելի արդյունքը BrowseComp-Plus-ում բարելավեցին 47,6%-ով և FLOPs-ի սպառումը կրճատեցին 12%-ով։
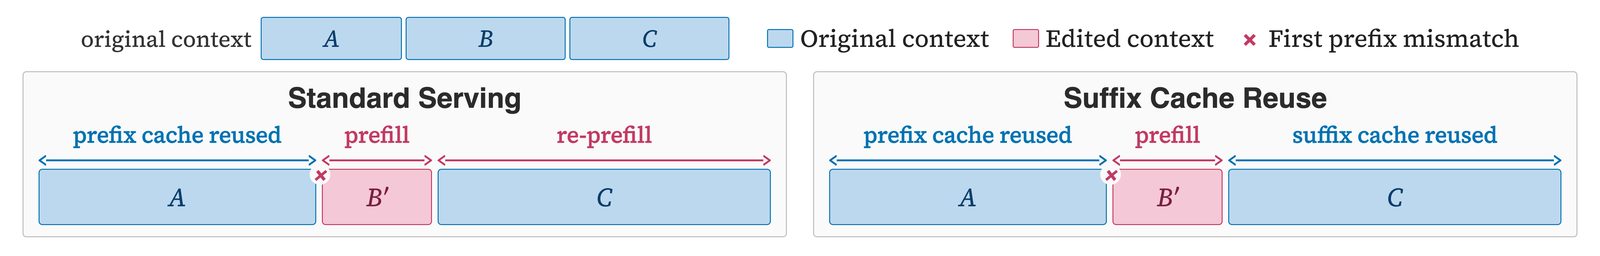
CLM-ը համատեքստը խմբագրում է նաև մեջտեղում, ինչը ստիպում է ստանդարտ սպասարկման համակարգերին վերահաշվարկել քեշը։ Այս խնդիրը լուծելու համար հեղինակները SGLang-ի համար մշակեցին Suffix Cache Reuse (SCR)․ փոփոխությունից հետո SCR-ը պահպանում է անփոփոխ մնացած հատվածների քեշը և սերվերի հաշվողական ծախսը ստանդարտ SGLang-ի համեմատ նվազեցնում է 35%-ով՝ պահպանելով նույն արդյունավետությունը։
Կոդը հրապարակված է GitHub-ում։ Գործնականում երկարաժամկետ ագենտների համար համատեքստի կառավարումն ավելի շատ կախված կլինի հենց մոդելից և ավելի քիչ՝ ձեռքով հավաքված արտաքին համակարգերից։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։