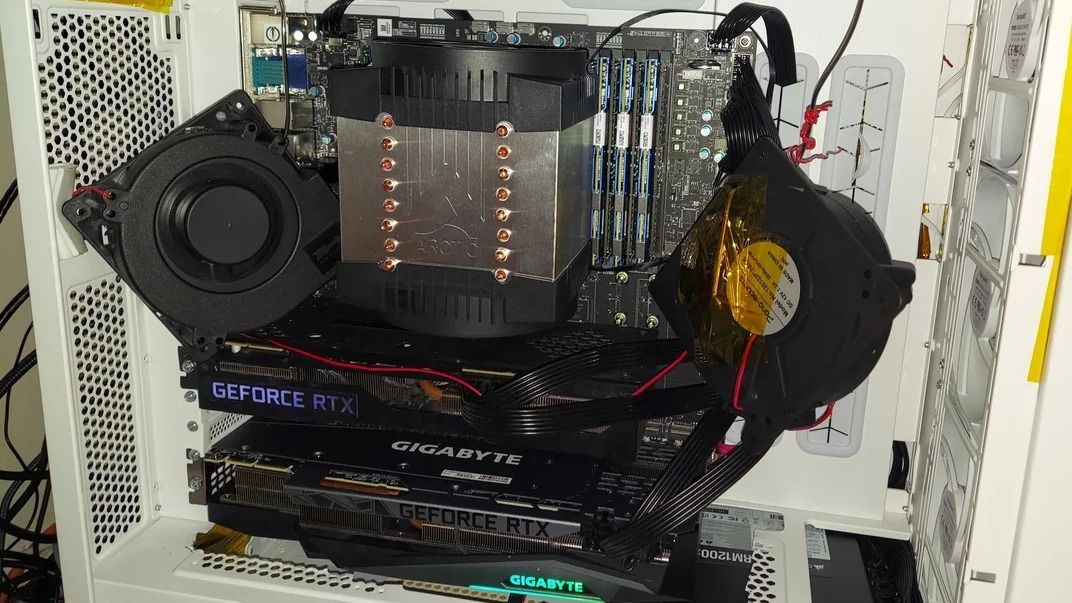
Հոմլաբերը 2,8 տրիլիոն պարամետրով Kimi մոդելը գործարկել է 3,11 թոքեն/վ արագությամբ՝ երկու RTX 3090-ով և Optane-ով
Հոմլաբերի երկրորդ սերնդի Optane համակարգին ավելացվել են երկու RTX 3090 տեսաքարտ, որպեսզի գործարկվի Moonshot-ի 2,8 տրիլիոն պարամետրով Kimi K3 մոդելը 3,11 թոքեն վայրկյանում, իսկ RAM դիսկը գեներացիայի արագությունը բարձրացրել է մոտ 41%-ով։
Հոմլաբերը Reddit-ի հետագա գրառման մեջ ներկայացրել է երկրորդ սերնդի Optane AI համակարգի բարելավումները՝ ավելացնելով երկու RTX 3090 տեսաքարտ, որպեսզի գործարկի Moonshot-ի 2,8 տրիլիոն պարամետրով Kimi K3 մոդելը 3,11 թոքեն վայրկյանում։ Մոդելի գրեթե կեսը RAM դիսկ տեղափոխելը գեներացիայի արագությունը բարձրացրել է մոտ 41%-ով, իսկ հարցման գնահատումը՝ մոտ 26%-ով։ Համակարգը դեռ լրացուցիչ հովացուցիչների կարիք ունի, քանի որ Optane հիշողությունը շատ է տաքանում։
Արդյունավետությունը RAM դիսկով և առանց դրա
Երկու GPU-ով, բայց առանց RAM դիսկի, համակարգը գործել է 2,20 թոքեն վայրկյանում գեներացիայի և 13,3 թոքեն վայրկյանում հարցման գնահատման համար։ 94 շարդից 45-ը, կամ 865 GB մոդելի 414 GB-ը, tmpfs RAM դիսկում և մնացածը Optane-ում տեղադրելուց հետո գեներացիան հասել է 3,11 թոքեն վայրկյանում, իսկ հարցման գնահատումը՝ 16,8 թոքեն վայրկյանում։ Կառուցողի չափումները կատարվել են llama.cpp-ով, Optane հատվածի համար DAX-ը միացված էր։
Նման կազմակերպումը նորություն չէ այն էնտուզիաստների համար, ովքեր համակարգային հիշողությունը հատկացնում են ավելի արագ արդյունավետության համար կեղծ ոչ կայուն եղանակով, որտեղ այն երևում է որպես դիսկ, թեև այս օրերին բոլորը այդքան RAM ազատ չունեն։
Ինչպես են օգտագործվում GPU-ները և հիշողությունը
Երկու RTX 3090-ներն ունեն 24 GB VRAM յուրաքանչյուրը, կամ 48 GB ընդհանուր, ինչը կազմում է 865 GB մոդելային ֆայլի մոտ 5,5%-ը, ուստի դրանք չեն պահում մոդելը։ Մոդելը mixture-of-experts տիպի է՝ 896 փորձագետով. Յուրաքանչյուր թոքենի համար ընտրվում է 16-ը, գումարած երկու ընդհանուր, ընդհանուր 104 միլիարդ ակտիվ պարամետր 2,8 տրիլիոնից։ Routed-expert տենզորները մնում են CPU կողմում՝ Optane-ում և RAM դիսկում, մինչդեռ RTX 3090-ները մշակում են attention-ը, խիտ feed-forward ցանցի շերտը, ընդհանուր փորձագետները, այլ ակտիվ խիտ բաղադրիչները, KV cache-ը, պահված զրույցի համատեքստը և GPU հաշվարկային բուֆերները։
DRAM-ը ավելի դանդաղ է, քան VRAM-ը, բայց դեռ ընդունակ է տալու բավարար արագացում, և GPU-ներով արագությունը գտնվում էր կառուցողի սպասած միջակայքում՝ սկզբնական համակարգի թեմայում 2-ից 4 թոքեն վայրկյանում գուշակելուց հետո։
Մոդելի չափը և քվանտացումը
Բոլոր 2,8 տրիլիոն պարամետրերը 16-բիթ ճշտությամբ կզբաղեցնեին մոտ 5,6 TB։ Moonshot-ի սեփական թողարկումը օգտագործում է 4-բիթ MXFP4 ձևաչափ և կազմում է մոտ 1,56 TB, իսկ այստեղ օգտագործված Q2_K ֆայլը մոդելը փոքրացնում է մինչև 865 GB՝ միջինը 3 բիթից պակաս յուրաքանչյուր պարամետրի համար։ Զեկույցը նշում է, որ 865 GB թիվը հավանաբար գիբիբայթերով է, բայց օգտագործում է GB արժեքները՝ հոմլաբերի գրած տեսքով։
Հովացում և ապագա ծրագրեր
GPU-ների տեղադրումը մասամբ սպասել է կորպուսի փոփոխություններին, որոնց համար պահանջվել է մետաղի կտրում և սնուցման բլոկի տեղափոխում՝ GPU-ներին և դրանց հովացմանը տեղ ազատելու համար։ Հովացումը մնում է կարևոր խնդիր, և Optane DIMM-ների երկու 12W փչիչ հովացուցիչները պահվում են տեղում՝ նույնիսկ երկու 350W դասի GPU-ների դեպքում։ Կառուցողը առջևում տեսնում է լրացուցիչ օպտիմիզացիաներ, ներառյալ "customized quantization"-ը, որը կարող է նման լինել փաստաբան Նիք Մերմիգեսի օգտագործած տեխնիկաներին, և նշում է, որ միայն արագությունը բավարար չէ, քանի որ արդյունքի որակը նույնպես պետք է հաշվի առնվի։
Աղբյուրներ՝ Tom's Hardware
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։