Ai2-ը թողարկեց Olmo-core 3-ը տրիլիոն պարամետր չափով մասշտաբային MoE մոդելների ուսուցման համար
Ai2-ը թողարկեց բաց համակարգը Olmo-core 3-ը, որը մեծացնում է MoE մոդելների ուսուցումը մինչև տրիլիոն պարամետր: Մեկ բենչմարկում փորձագետների լիճակը 8-ից 128 է մեծացել, իսկ ուսուցման թողունակությունը կրճատվել է 5%-ից պակաս:
Ai2-ը (Allen Institute for AI) թողարկեց Olmo-core 3-ը հոկտեմբերի 1-ին: Սա իր բաց շրջանակի թարմացումն է վերամշակված MoE (փորձագետների խառնուրդի) ուսուցման համակարգով: Ինստիտուտի հայտարարությամբ, այն նախատեսված է մինչև տրիլիոն պարամետր մասշտաբայնության համար և հանդիսանում է հաջորդ սերնդի Olmo-ի հիմնական համակարգերից մեկը:
MoE մոդելը յուրաքանչյուր տվյալի համար օգտագործում է միայն մասը, սակայն ամբողջ մոդելի պահպանումը և տվյալների ճիշտ փորձագետներին վերահասցեավորումը ստեծում է ծախսեր, որոնք աճում են չափի հետ մեկտեղ:
Ինչ է փոխում Olmo-core 3-ը
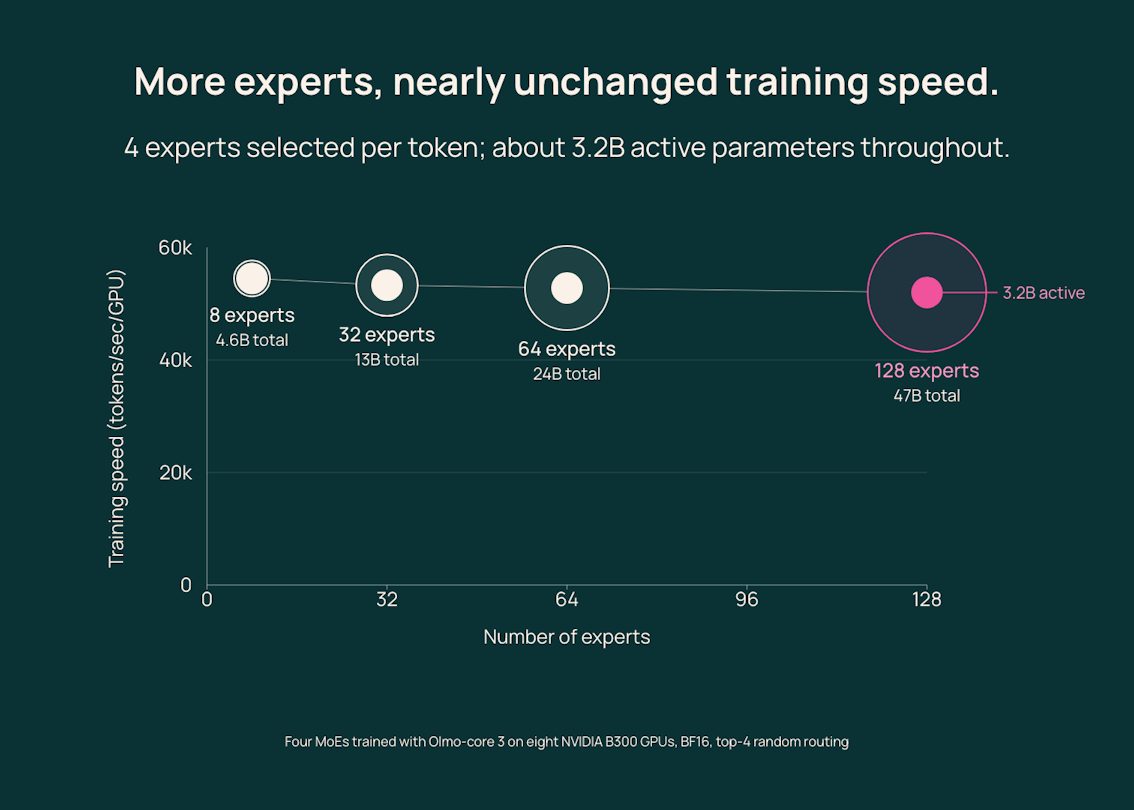
Մեկ բենչմարկում փորձագետների լիճակը 8-ից 128 է մեծացել, յուրաքանչյուր թոկենի համար կրկին ընտրվում էր չորս փորձագետ, ակտիվ պարամետրերի քանակը թոկենի համար մնում էր մոտավորապես 3,2 միլիարդի մակարդակում: Պարամետրերի ընդհանուր տոննաժը 4,6 միլիարդից 47 միլիարդ է մեծացել, իսկ թողունակությունը կրճատվել է 5%-ից պակաս:
Հին տարբերակը օգտագործում էր ամբողջությամբ բաժանված տվյալների զուգահեռությունը (FSDP), իսկ Olmo-core 3-ը անցել է բաշխված տվյալների զուգահեռության (DDP) սխեմային: Փորձագետները մնում են GPU-ներում, տվյալները դեպի նրանց են ուղղվում:
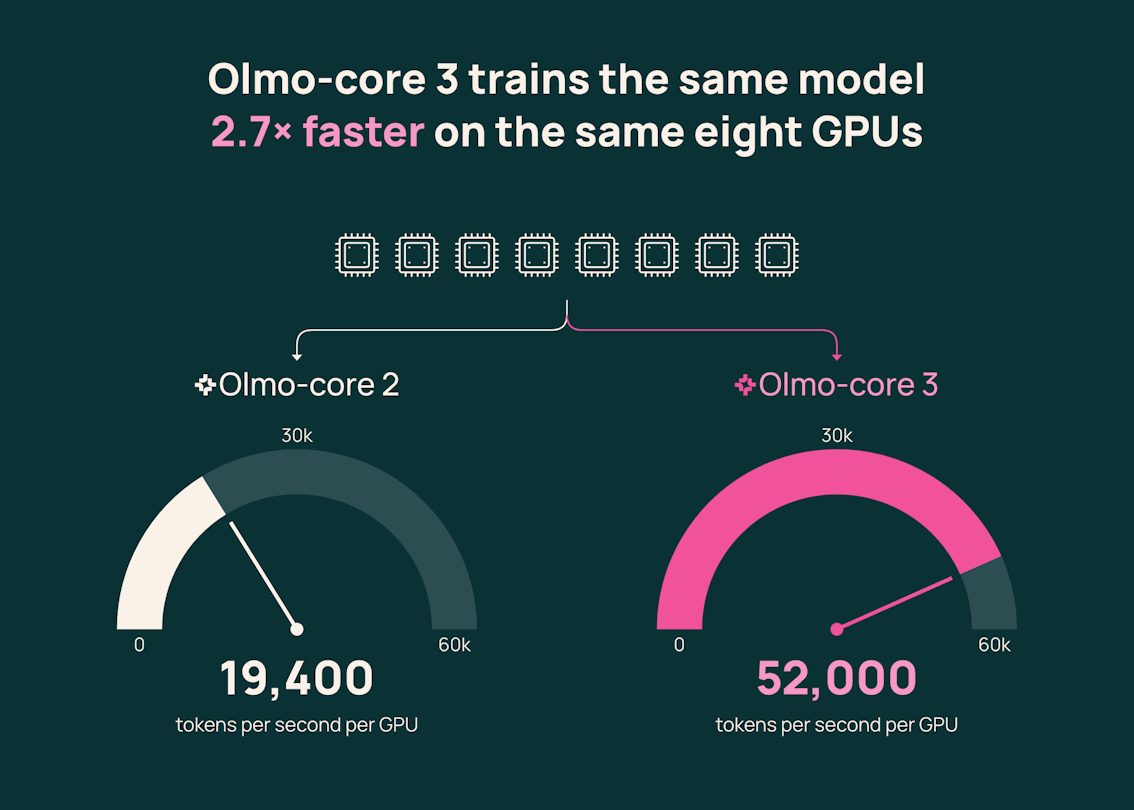
NVIDIA-ի ութ B300 GPU-ում 47 միլիարդ պարամետր ունեցող MoE մոդելը նոր համակարգով մեկ GPU-ում վայրկյանում մշակեց 52 000 թոկեն, հին տարբերակով՝ 19 400, այսինքն մոտավորապես 2,7 անգամ ավելին:
Մասշտաբայնություն մինչև տրիլիոն պարամետր
Olmo-core 3-ը մոդելները բաժանում է փորձագետների և կահապատվերի զուգահեռությամբ և բաշխված օպտիմիզատորով: Մետատվյալները մնում են GPU-ներում, երթական տվյալները ուղղակիորեն ընկնում են փորձագետի բուֆեր, իսկ խմբավորված GEMM-ը միավորում է փոքր հաշվարկները:
Համակարգը նաև աջակցում է MXFP8-ը, ցածր ճշգրտության ձևաչափը: Չորս B300 GPU-ում այն ցուցադրեց մոտավորապես 21% ավելի մեծ թողունակություն BF16-ի հետ համեմատած, իսկ գագաթնակետ ակտիվ հիշողությունը իջավ 103 GiB-ից 95 GiB:
Ai2-ը նաև ստուգեց 1,2 տրիլիոն պարամետր ունեցող մոդելը 512 GPU-ում, որտեղ յուրաքանչյուր թոկենի համար 58,36 միլիարդ պարամետր է ակտիվ: Առավելագույն թողունակությունը մեկ GPU-ում կազմել է 858 TFLOP/s: Թեստերը չափեցին համակարգի աշխատանքը պատահական երթականությամբ, ոչ թե մոդելի որակը: DeepEP v2-ի փորձարկումը կարճ թեստում հասավ 2,38 տրիլիոն պարամետրի:
Բաց ենթակառուցվածք
Հաջորդ սերնդի Olmo-ն օգտագործում է MoE ճարտարագիտությունը և պետք է դառնա ամենաուժեղ Olmo-ն, ուսուցված ամենամեծ տվյալների հավաքածուի վրա և ամենաերկար համատեքստով: Համակարգը ամբողջովին բաց է: Հետազոտողները կարող են դրա վրա ուսուցնել իրենց սեփական MoE մոդելները և հարմարեցնել այլ սարքայինության: Տեխնիկական հաշիվը, կոդը և ինտերակտիվ ցուցադրությունները արդեն հասանելի են:
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։