Ai2-ը թողարկեց բաց կշեռքով մոդել AstaBrief 8B: գիտական հաշվետվությունները պատրաստում է 3,5 անգամ արագ
Ai2-ը (Allen Institute for AI) թողարկեց բաց կշեռքով մոդել AstaBrief 8B: այն հաշվետվություն է պատրաստում հետազոտության հարցումից և գտնված գրականությունից մեջբերումներով՝ Fast mode-ում միջինում 51,1 վայրկյանում, 3,5 անգամ արագ, քան Thinking mode-ում:
Allen Institute for AI-ը (Ai2) հոկտեմբերի 2-ին թողարկեց բաց կշեռքով մոդել AstaBrief 8B: Մոդելը հաշվետվություն է պատրաստում հետազոտության հարցման և գտնված գրականության հատվածներից մեջբերումներով և արդեն աշխատում է Asta-ում Fast mode-ի տեսքով, Thinking mode-ի կողքին:
Ամբողջ ուղությամբ Fast mode-ը մեկ հաշվետվություն պատրաստում է միջինում 51,1 վայրկյանում՝ Thinking mode-ի 178,5 վայրկյանի համեմատ, այսինքն մոտ 3,5 անգամ արագ: Մոդելը հաշվետվությունը գրում է մեկ անցում և բաց է թողնում ամփոփման և կլաստերիզացիայի փուլերը: Ai2-ի խոսքով՝ որակը չի տուժել:
Բաց մոդել գիտական հաշվետվությունների համար
AstaBrief 8B-ը ութ միլիարդ պարամետրի մոդել է Qwen3-8B-ի հիմքի վրա: Ai2-ի հետազոտողները հիմնականում աշխատել են post-training տվյալների և գնահատման վրա: Բաց կշեռքերը ինստիտուտներին հնարավորություն են տալիս գործարկել մոդելը սեփական ենթակառուցվածքում՝ firewall-ի հետո, ինչը կարևոր է սենսիտիվ հետազոտությունների համար:
Ինչպես վերապատրաստեցին մոդելը
AstaBrief-ը վերապատրաստեցին երկու փուլով՝ supervised fine-tuning (SFT) և direct preference optimization (DPO): Ai2-ը թանկ և անկայուն RL մոտեցման փոխարեն ընտրեց ավելի պարզ ճանապարհ: Վարժության հարցերը վերցնել են իրական օգտատիրոջ լոգերից: զտման հետո մնաց 90 հազար հետազոտական հարց:
SFT-ի համար նախատեսված հաշվետվությունները ստեղծեց ScholarQA-ի ուղությունը (Claude 3.5 Sonnet, Claude 3.7 Sonnet, o3, o4-mini, GPT-4.1): զտման հետո մնաց 47 հազար օրինակ: DPO-ի համար զույգերը համեմատում էին երկու դատավոր մոդելներ (GPT-4.1 և DeepSeek-R1), վերջնական ընտրանքում ՝նում է մինչև 6 հազար օրինակ: Չորս ստատիստիկական ֆիլտրերից ամենաշատ շահը տվեց մեջբերումների ցածր խտությամբ օրինակների հեռացումը:
Արդյունքները և կիրառումը
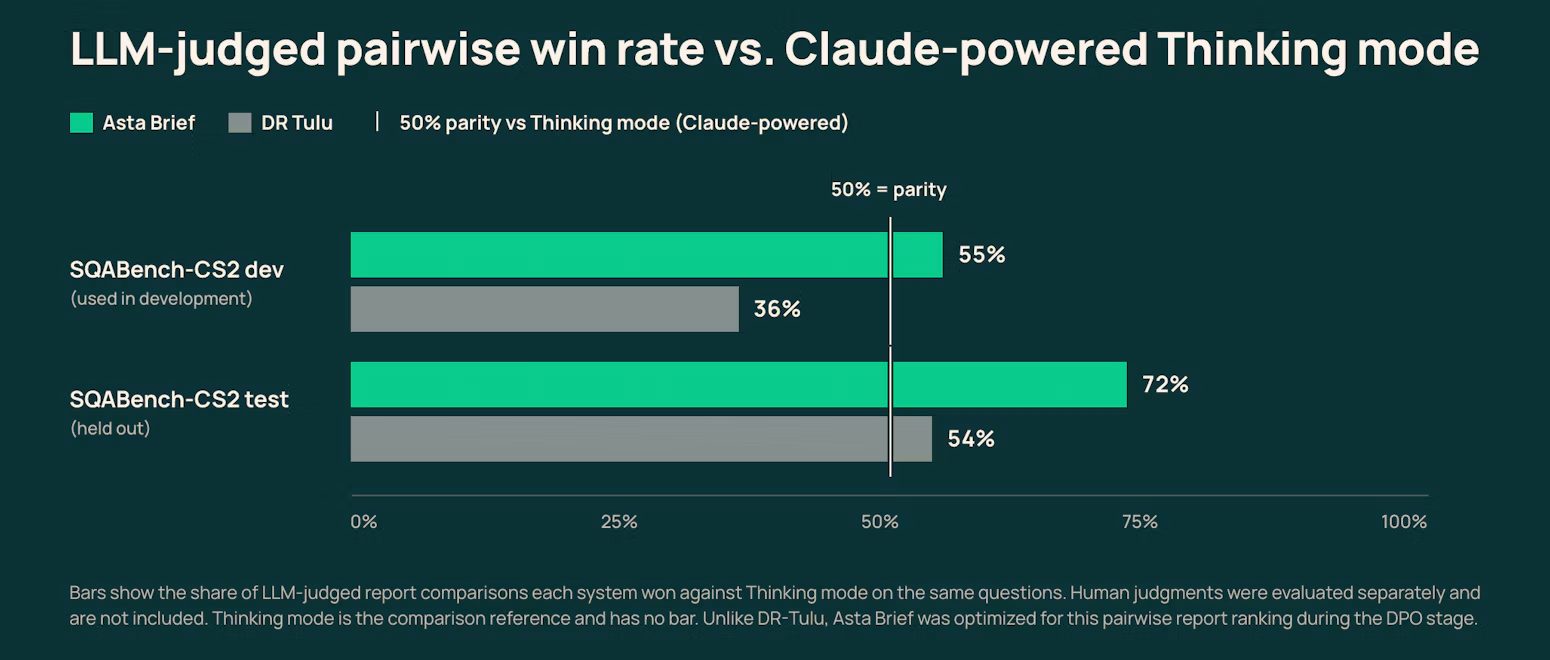
Գնահատման հիմնական նպատակը եղել է SQABench-CS2: 200 հարց համակարգչային գիտությունից: Չափել են գնահատականի միավորը, պատասխանի ճշգրտությունը, մեջբերումների ճշգրտությունը և սխալները: լրացուցիչ՝ ստուգել են DeepScholarBench-ում (63 հարց) և անցկացրել 14 հարցի մարդկային հետազոտություն:
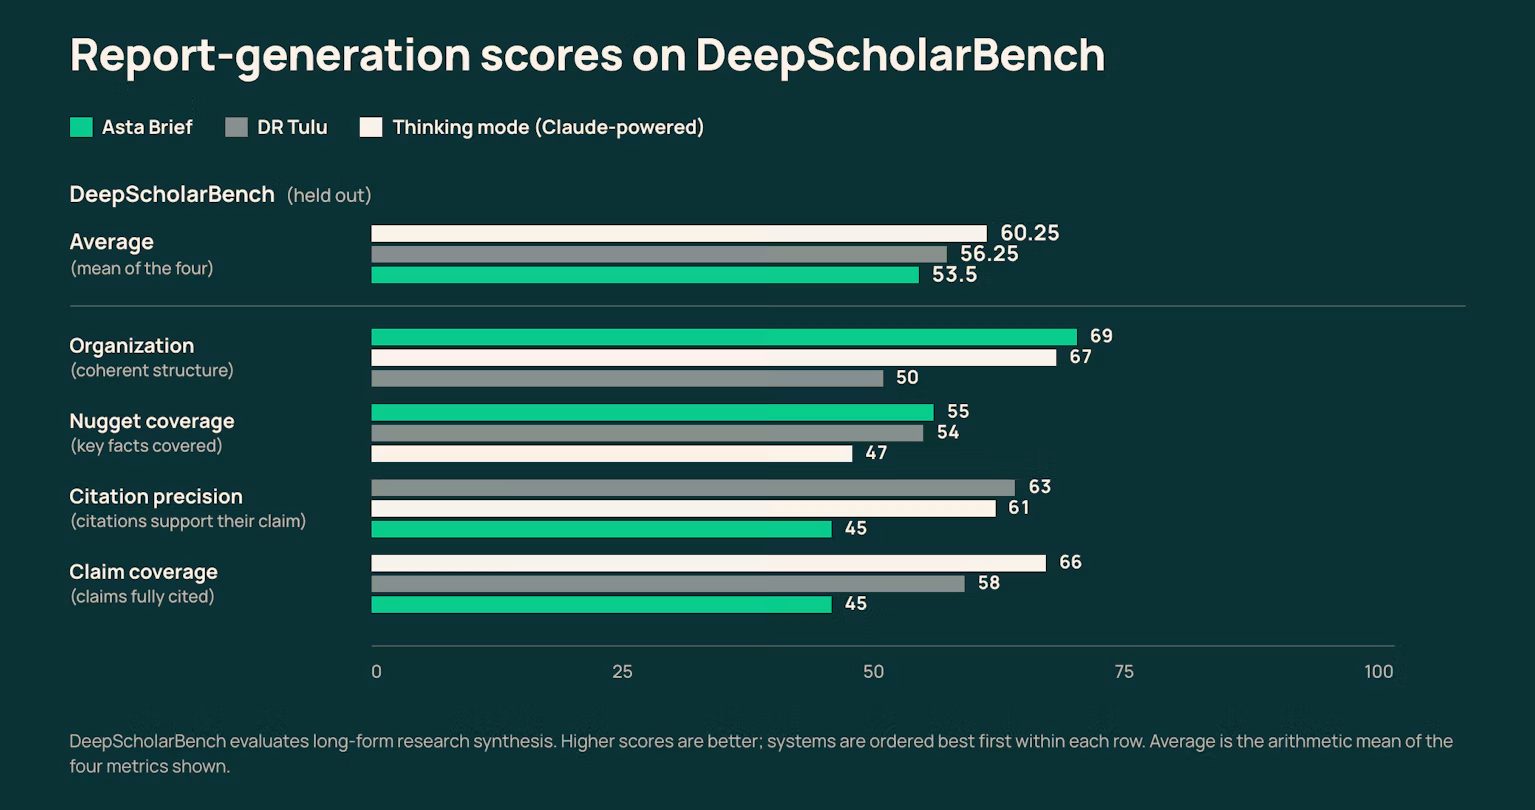
AstaBrief-ը մրցունակ է Claude-ի վրա հիմնված ուղության և DR Tulu-ի համեմատ: Մարդկային հետազոտության ընթացքում ընդհանուր առմամբ հաղթում է DR Tulu-ն, սակայն երեք հետազոտողից երկուսը մեջբերումների ճշգրտության մեջ առավելություն տվեցին AstaBrief-ին: Ai2-ը նշում է, որ գնահատումը հիմնականում անցկացվել է 2025 թվականին և չի կրկնվել ներկա մոդելների հետ:
Վաղ կիրառումը դրական է: Fast mode-ը փորձել է 374 օգտատեր, 29,1%-ը այն օգտագործում է երկու կամ ավելի օր, իսկ միջինում ստեղծում են 3,67 հաշվետվության թռեդ: 23%-ը նախընտրել է մնալ Fast mode-ում, 18%-ը՝ անցնել ռեժիմների միջև, իսկ թռեդների 40%-ը անցկացրել է Fast mode-ում: Դրական արձագանքը երկու ռեժիմներում նման է: 84,2% Fast mode-ի համար և 85,2% Thinking mode-ի համար:
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։