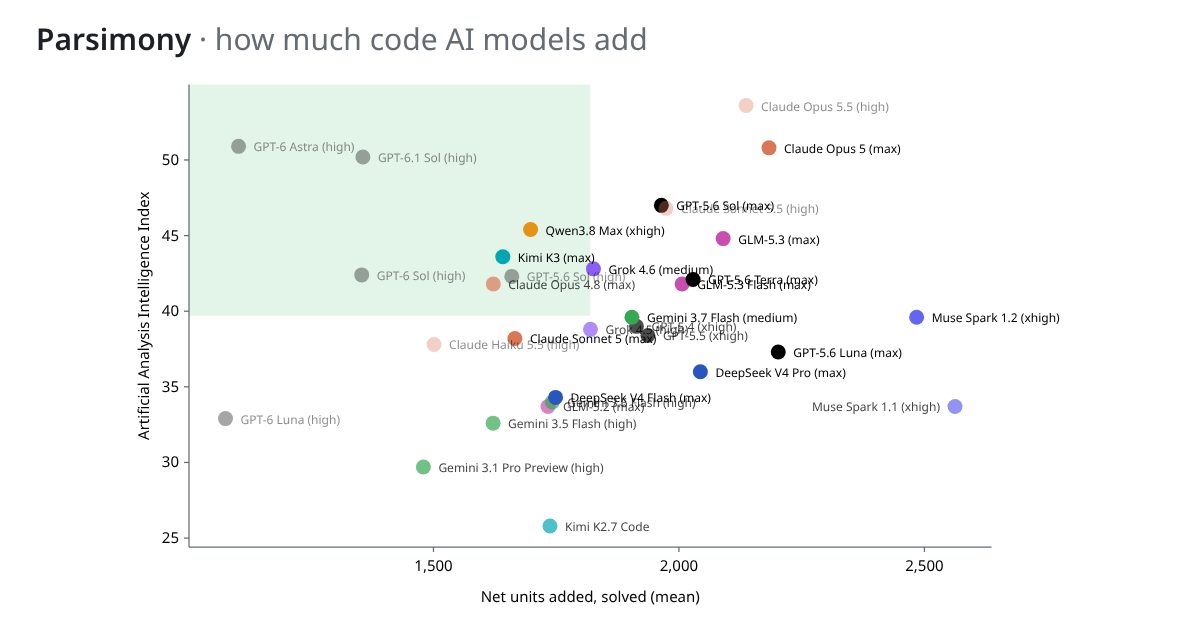
Parsimony նոր բենչմարկը գնահատում է AI կոդավորման գործակալներին՝ ավելացված կոդի հիման վրա
Parsimony-ն բենչմարկ է, որը չափում է, թե որքան կոդ են ավելացնում AI կոդավորման գործակալները խնդիրը լուծելիս։ Այն հաշվում է շարահյուսական միավորները՝ ոչ թե տողերը, հանում է ջնջված կոդը և մոդելները դասավորում SWE-bench Verified-ում՝ միջին զուտ միավորներով։
Գոյություն ունեցող AI կոդավորման բենչմարկները չափում են լուծման տոկոսն ու ծախսը, բայց չեն պատժում ավելորդ կոդը, ինչը ժամանակի ընթացքում կարող է բարդացնել կոդաբազայի հետ աշխատանքը։ Parsimony-ն, նոր բենչմարկը, օգտագործում է տարբեր մոտեցում՝ չափում է, թե որքան կոդ են ավելացնում AI մոդելները խնդիրը լուծելիս։
Ինչպես է աշխատում Parsimony-ն
Parsimony-ն վերցնում է այն պատչերը, որոնք բենչմարկներն արդեն հրապարակում են, և հաշվում է կոդային միավորները, այսինքն՝ շարահյուսական տարրերը, ինչպիսիք են հրահանգները, կանչերը, համեմատությունները, անունները և լիտերալները։ Տողերը չեն հաշվվում, հետևաբար կոդը քիչ տողերի մեջ տեղավորելը չի խրախուսվում։ Ջնջված կոդը հանվում է, ինչը տալիս է պարզ բանաձև՝ զուտ միավորները հավասար են ավելացվածի հանած ջնջվածը։ Ամեն պատչը կիրառվում է խնդրի կոդի վրա, և յուրաքանչյուր փոփոխված ֆայլի երկու տարբերակն էլ վերլուծվում է․ ոչինչ չի կատարվում։ Թեստերը, դոկումենտացիան և գեներացված ֆայլերը բացառվում են, և չափվում է միայն Python։ Հաջող ու անհաջող արդյունքները վերցվում են SWE-bench-ի հրապարակված արդյունքներից, իսկ թեստերը կրկին չեն գործարկվում։
Ինչպես կարդալ առաջատարների աղյուսակը
Մոդելները դասավորվում են լուծած խնդիրներում ավելացված միջին զուտ միավորներով՝ սկսած ամենացածրից։ «Net units added (mean)» ցուցանիշը նաև ներառում է անհաջող փորձերը։ «Solved» սյունակը վերցվում է SWE-bench Verified-ից, իսկ «Measured»-ն ցույց է տալիս, թե քանի լուծված փորձ կարող էր չափվել։ Artificial Analysis Intelligence Index-ը երևում է որպես արտաքին միավոր՝ կախված մոդելից և մտածողության ջանքից, բայց ազդեցություն չի ունենում դասավորության վրա։ Աղյուսակի մթեցված գրառումները հեղինակը գործարկել է առաջին 3-ից մինչև 10 DeepSWE Python խնդիրների վրա՝ OpenAI մոդելների համար օգտագործելով pi, իսկ Anthropic մոդելների համար՝ Claude Code, և գնահատել է յուրաքանչյուր խնդրի սեփական թեստերով․ դրանք չեն վերիֆիկացված կամ դասավորված։ GPT-5.6 Sol-ը գործարկվել է երկու եղանակով, իսկ հեղինակի գործարկումը հրապարակված գործարկման կոդի 0,88 անգամն է ավելացրել։
Սահմանափակումներ և նախազգուշացումներ
Նախագիծը նշում է, որ ավելի փոքրը միշտ չէ, որ ավելի լավ է․ միավորները չափում են չափը, այլ ոչ թե ընթեռնելիությունը կամ նախագծումը։ Ավելի շատ կոդ գրող մոդելները, որպես կանոն, նաև ավելի շատ խնդիրներ են լուծում՝ Spearman կորելյացիաները տատանվում են 0,33-ից 0,60-ի սահմաններում՝ 26 և ավելի մոդելներ ունեցող աղյուսակներում։ Յուրաքանչյուր մոդել օգտագործում է նույն գործակալը՝ mini-SWE-agent, բայց գործակալը դեռ ազդում է նրա վրա, թե որքան կոդ է գրվում։
Սեփական բենչմարկի ավելացում
Այն ընթերցողը, ով մեկ այլ բենչմարկից ունի կոդի չափի թվեր, կարող է ներբեռնել նմուշ JSON ֆայլը, լրացնել իր արդյունքները և բացել այն՝ նույն դիագրամն ու աղյուսակը ստանալու համար։ Ֆայլը մնում է բրաուզերում։
Աղբյուրներ՝ parsimony.lasu.dev
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։