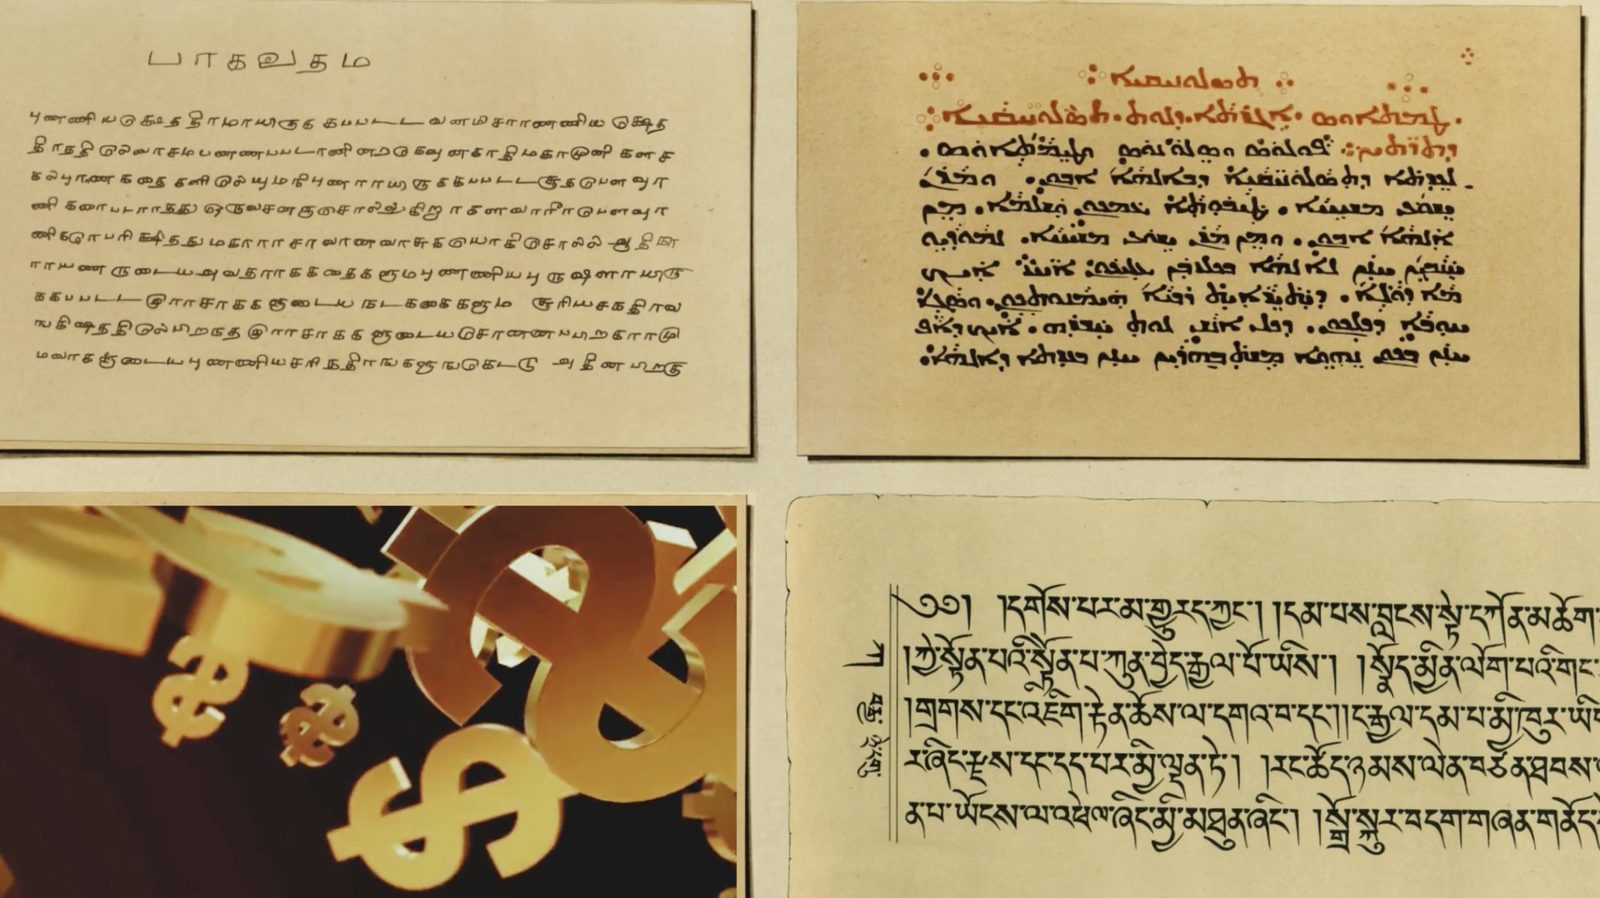
Տոկենայզերի հարկը: ինչու են ոչ անգլալեզու AI օգտատերերը ավելի շատ վճարում տոկենների համար
AI հետազոտություններում լեզվական հավասարության կոալիցիայի ուսումնասիրությունը նշում է, որ AI մոդելները որոշ լեզուների համար կարող են օգտագործել շատ ավելի շատ տոկեններ՝ բարձրացնելով ծախսերը, ուշացումը և կոնտեքստի սահմանները ոչ անգլալեզու օգտատերերի համար։
AI հետազոտություններում լեզվական հավասարության կոալիցիայի ուսումնասիրությունը պարզել է, որ AI մոդելները որոշ լեզուների համար կարող են պահանջել շատ ավելի շատ տոկեններ, քան մյուսների համար՝ ստեղծելով թաքնված տոկենայզերի հարկ։ Այս ազդեցությունը կարող է AI-ն ավելի թանկ դարձնել ավելի քիչ տարածված լեզուներ օգտագործողների համար, հատկապես երբ այդ լեզուներն ավելի փոքր առցանց ներկայություն ունեն։ Տոկենները տեքստի կամ տվյալների միավորներն են, որոնք մշակում են AI մոդելները։
Ինչպես են տոկենների քանակները տարբերվում ըստ լեզվի
Տոկենայզերները հում տեքստը, պատկերները կամ աուդիոն բաժանում են տոկենների։ Մեկ օրինակում անգլերեն նախադասությունը բաժանվել է ճանաչելի բառերի, իսկ նույն նախադասությունը մալայալամ լեզվով՝ բազմաթիվ բեկորների յուրաքանչյուր բառի համար՝ առանց հաշվի առնելու բազմաբայթ նիշերը։ Նույնիսկ ինտերնետի 20 ամենատարածված լեզուների շրջանակում հետազոտությունը հայտնաբերել է տոկենների օգտագործման բաց: այդ լեզուներից ամենաթանկը օգտագործել է 1.5-ից 5 անգամ ավելի շատ տոկեն, քան ամենաէժանը։ Երբ հավաքածուն ընդլայնվել է մինչև 200 լեզու, մեկ AI մոդելում տոկենների արժեքի բացը աճել է 17 անգամ։ Ուսումնասիրությունը նշել է, որ Բենգալուրուի ստարտափը կարող է վճարել հավելավճար ամեն հուշման և ավարտի համար, մինչդեռ նրա մրցակիցը Օսթինում չի վճարում։
Արժեքը միակ վնասը չէ
Ավելի բարձր տոկենների քանակը նաև վերածվում է ավելի բարձր ուշացման և նվազեցված էֆեկտիվ կոնտեքստի տարողության, նշել է ուսումնասիրությունը։ Ոչ անգլերեն լեզուները փաստաթղթերի կամ զրույցի պատմության համար ավելի քիչ տեղ են թողնում և պատասխան ստեղծելու համար ավելի շատ աշխատանք են պահանջում՝ ըստ Activate AI-ի Պրատյուշ Չոուդհուրիի։ Նա խնդիրը համեմատել է ուսուցչի հետ, որը պահում է ուսանողի նախորդ սխալներն ու բացատրությունները: եթե այդ պատմությունը մեկ լեզվով կոնտեքստային պատուհանը շատ ավելի արագ է լցնում, ապա թերությունը տարածվում է մինչև ծառայության որակը։ Ուսումնասիրությունը նշել է, որ այս տույժերը ամենից ուժեղ են հարվածում այնտեղ, որտեղ հաշվարկային ռեսուրսներն ու կապը արդեն սահմանափակ են, և որ տոկենայզերի անհավասարությունը սահմանափակում է, թե ով կարող է մասնակցել AI տնտեսությանը։
Գիրը, տվյալները և նախագծումը կարևոր են
Լեզվի հազվադեպությունը տոկենների օգտագործման միակ գործոնը չէ: գիրը մեծ դեր է խաղում։ Աստուրիերենը, որն ունի համեմատաբար քիչ խոսողներ և Common Crawl տվյալներ չունի, օգտվում է լատինատառ առավելությունից և կապված ռոմանական լեզուների, ինչպես օրինակ իտալերենի, ներկայացուցչությունից։ Լեզուները, որոնք գրված են գրերով, որոնք տոկենայզերները հազվադեպ են տեսել, այդ թվում՝ բիրմաներենը, տիբեթերենը, տիֆինագը, քմերերենը, լաոսերենը և Ol Chiki-ն, գրեթե բոլոր մոդելներում հետևողականորեն ամենամեծ թերությունն ունեին։ Maya Research-ի գլխավոր տնօրեն Դհիմանթ Ռեդդին ասել է, որ շատ տոկենայզերներ դեռ անհամաչափ օպտիմալացված են անգլերենի և այլ բարձր ռեսուրս ունեցող լեզուների համար, և որ հիմնական խնդիրը բարձր որակի թվային տվյալների բացակայությունն է։ Լեզվի մշակումը բարելավելու մի ճանապարհ հիմքային տվյալների բարելավումն է։ Navana.ai-ի համահիմնադիր և գլխավոր տնօրեն Ռաուլ Նանավատին նշել է RESPIN-ը՝ Հնդկաստանի գիտությունների ինստիտուտի հետ համատեղ նախաձեռնությունը, որը ֆինանսավորվել է Gates Foundation-ի կողմից և հավաքել է տեքստ 38 բարբառների մայրենի խոսողներից՝ ընթերցված խոսքի հետ միասին։
Բացը վերացնելը
Միայն ավելի լավ ուսուցման տվյալները չեն վերացնում տոկենայզերի խնդիրը՝ զգուշացրել է Ռեդդին։ Տոկենների գները արագ են նվազում, ուստի անմիջական արժեքի ազդեցությունը ժամանակի ընթացքում պետք է դառնա ավելի քիչ ծանր, իսկ ավելի լավ բազմալեզու և սինթետիկ տվյալները պետք է բարելավեն մոդելի որակը։ Սակայն տոկենացման բացը իրականում վերացնելու համար դեռ կպահանջվի, որ լաբորատորիաները միտումնավոր նախագծեն ապագա տոկենայզերները՝ այս լեզուներն ու գրերը ավելի լավ մշակելու համար։ Չոուդհուրին ասել է, որ լեզվական արդյունավետությունը պետք է լինի արտադրանքի պահանջ՝ ճշգրտության, արագության և հուսալիության կողքին։ Նա ասել է, որ կատարյալ հավասարությունը կարող է անիրատեսական լինել, բայց մեծ և մշտական տարբերությունները պետք է պահանջեն բացատրություն և բարելավման պլան, և նա խնդրել է յուրաքանչյուր խոշոր լաբորատորիայից հրապարակել լեզու-լեզվի գնահատական քարտ, որը կցուցադրի, թե որքան է արժենում համեմատելի առաջադրանքները հաջողությամբ ավարտելը, և պարտավորվել ապահովել չափելի բարելավումներ իր ամենաքիչ սպասարկված լեզուների համար։
Աղբյուրներ: Rest Of World · Techmeme
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։