Cerebras-ი განმარტავს, როგორ უშვებს ტრილიონპარამეტრიან AI მოდელებს ვაფლის მასშტაბის ჩიპებზე
Cerebras-ი ხსნის, როგორ ანაწილებს დიდ მოწინავე მოდელებს WSE-3T ვაფლებზე; Kimi K3-ის მაგალითზე განმარტავს ჩიპშიდა მეხსიერებას, კონვეიერულ დამუშავებასა და პარალელური მოთხოვნების მართვას.
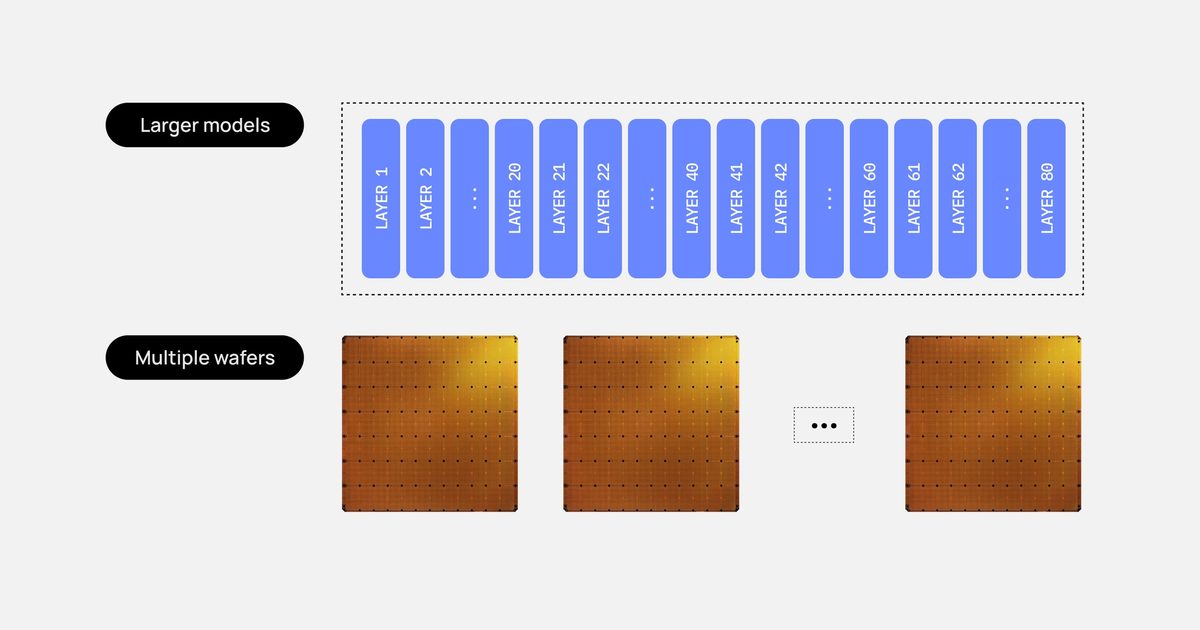
Cerebras-მა გამოაქვეყნა განმარტება, თუ როგორ უშვებს ტრილიონპარამეტრიან მოწინავე მოდელებს ვაფლის მასშტაბის ჩიპებზე. Cerebras-ის ერთ WSE-3T ვაფლს 44 GB ჩიპშიდა მეხსიერება აქვს, ხოლო ტრილიონპარამეტრიან მოდელებს მხოლოდ წონებისთვის ტერაბაიტები სჭირდებათ. კომპანიის თქმით, ის დიდ მოდელს რამდენიმე WSE-3T ვაფლზე ანაწილებს, რათა მრავალტრილიონპარამეტრიანი მოდელები წამში 1000-2000+ ტოკენის სიჩქარით ამუშაოს.
Kimi K3 მაგალითის სახით
Cerebras-ი მაგალითისთვის იყენებს ღია კოდის Kimi K3 მოდელს. Kimi K3-ს დაახლოებით 3 ტრილიონი პარამეტრი აქვს; მოდელი შედგება 69 linear-attention ფენისა და 24 dense ფენისგან. Cerebras-ის თქმით, Kimi K3 Terminal-Bench 2.1-ზე 88,3%-ს აჩვენებს, მაშინ როცა GPT-5.6 Sol 88,8%-ს აღწევს; BrowseComp-ზე Kimi K3-ს 91,2% აქვს, GPT-5.6 Sol-ს კი 90,4%. Cerebras-ი ამბობს, რომ ეს შედეგები აჩვენებს მოწინავე დონის კოდირებისა და აგენტული შესაძლებლობებს: მოდელი ზოგიერთ ბენჩმარკზე წამყვან პროპრიეტარულ მოდელებს აღემატება.
მაგალითისთვის Cerebras-ი ვარაუდობს 256k საშუალო მოთხოვნის ზომას, 4-bit წონების კვანტიზაციასა და 8-bit KV cache მეხსიერებას. ის ითვლის ყოველი მოდელის ფენის ზომას, შემდეგ კი მოდელს 93 ფენად ყოფს. შედეგად, თითო ფენაზე დაახლოებით 16 GB მოდის.
ფენების ვაფლებზე განაწილება
თითოეული WSE-3T ვაფლის 44 GB ტევადობა განსაზღვრავს, რამდენი ფენა ეტევა ერთ ვაფლზე, და პასუხი ფენის ტიპზეა დამოკიდებული. dense ფენებს KV cache მეხსიერებისთვის დამატებითი ადგილი სჭირდებათ, რადგან ყოველი dense (full-attention) ფენა ინახავს key-ებსა და value-ებს ყოველი ტოკენისთვის ყოველ აქტიურ მოთხოვნაში. ამიტომ Cerebras-ი თითოეულ dense ფენას ცალკე ვაფლზე ათავსებს და დარჩენილ SRAM-ს KV cache მეხსიერებისთვის ტოვებს.
linear-attention ფენებს KV cache მეხსიერებისთვის დამატებითი ადგილი არ სჭირდებათ. ყოველი ტოკენისთვის key-ებისა და value-ების შენახვის ნაცვლად linear-attention ფენა თითო მოთხოვნაზე ინახავს პატარა, ფიქსირებული ზომის მდგომარეობას, კონტექსტის სიგრძის მიუხედავად. ეს ტოვებს ადგილს ორი linear ფენისთვის ერთ ვაფლზე, 2 x 16 GB = 32 GB. 69 linear ფენისა და 24 dense ფენის განაწილებით მიიღება 35 ვაფლი linear ფენებისთვის, 24 ვაფლი dense ფენებისთვის, სულ 59 ვაფლი.
კონვეიერის შესრულება და პარალელურობა
Cerebras-ი მოდელებს კონვეიერის პრინციპით ამუშავებს. კომპილატორი მოდელის ფენებს ვაფლების უბნებზე ანაწილებს, ხოლო runtime განსაზღვრავს გზას, რომლითაც ტოკენები ვაფლებს შორის გადაადგილდებიან. ვაფლებს შორის მხოლოდ აქტივაციები უნდა გადავიდეს და ეს შეიძლება გაკეთდეს RDMA over Ethernet საშუალებით, თითო ჰოპზე დაახლოებით 2 მიკროწამი. რადგან თითოეულ ვაფლს 44 GB ჩიპშიდა SRAM აქვს, ხოლო თითოეული ფენა დაახლოებით 16 GB-ია, მთელი ფენები ჩვეულებრივ პირდაპირ ჩიპზე ეტევა. უმეტეს შემთხვევაში მოდელის წონებს საერთოდ გადაადგილება არ სჭირდება და ფენების ვაფლებზე გაყოფა არ არის საჭირო.
თითოეული ვაფლი აწყობის ხაზში ერთ საფეხურს ასრულებს. მაგალითად, პირველი ვაფლი ამუშავებს 1-2 ფენებს და აქტივაციებს მეორე ვაფლს უგზავნის, რომელიც 3-4 ფენებს ამუშავებს და შედეგებს შემდეგ გზავნის, სანამ ბოლო ვაფლი შემდეგ ტოკენს არ წარმოქმნის. ბევრი მოთხოვნის მომსახურებისთვის Cerebras-ი კონვეიერს სავსეს ინახავს სხვადასხვა მოთხოვნით. თითოეულ საფეხურს ერთდროულად სხვადასხვა მოთხოვნაზე მუშაობა შეუძლია, და თითოეულ საფეხურს შეუძლია ერთი მოთხოვნის ნაცვლად micro-batch დაამუშაოს. უფრო მცირე micro-batch თითოეულ მოთხოვნას აჩქარებს, უფრო დიდი micro-batch კი მთლიან გამტარუნარიანობას ზრდის.
KV cache მეხსიერებისთვის გამოყოფილი ჩიპშიდა მეხსიერების რაოდენობა განსაზღვრავს პარალელური მოთხოვნების მაქსიმალურ რაოდენობას. ყოველ აქტიურ მოთხოვნას საკუთარი KV cache მეხსიერება სჭირდება ყოველ dense ფენის ვაფლზე. Cerebras-ი აღნიშნავს, რომ პარალელურობა და batch size მხოლოდ თავისთავად ინფერენსის ეფექტურობას არ აჩვენებს; უფრო მნიშვნელოვანი მეტრიკაა ტოკენების მთლიანი გამტარუნარიანობა ენერგიის ერთეულზე, გაზომილი გამომავალი ტექსტის გენერაციის იმავე სიჩქარეზე.
წყაროები: cerebras.ai
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.