Context Language Models: მოდელები, რომლებიც კონტექსტს თავად მართავენ
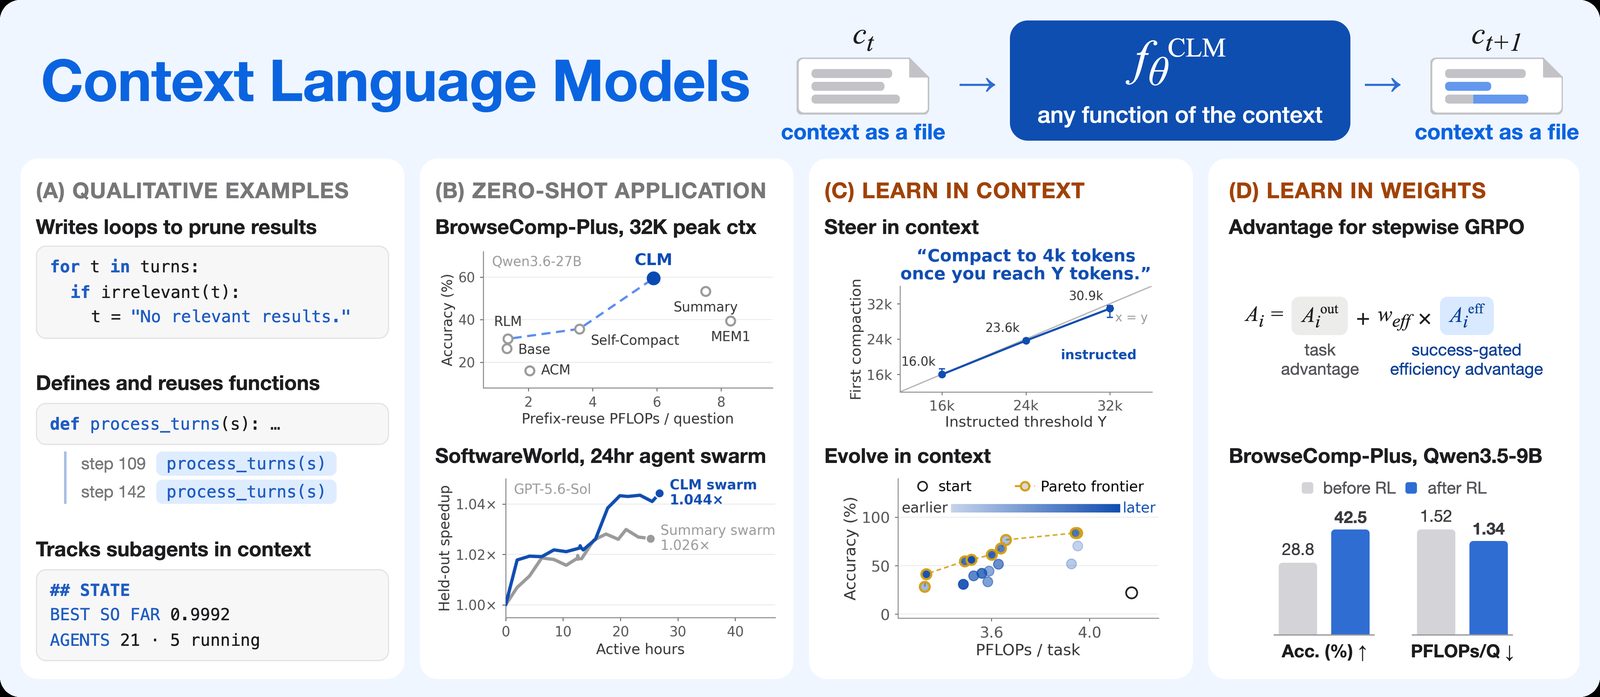
Washington-ის უნივერსიტეტის, MIT-ისა და Meta-ს მკვლევრებმა წარმოადგინეს Context Language Models (CLM): მოდელები კონტექსტს ფაილის სახით ინახავენ და თავად არედაქტირებენ. BrowseComp-Plus-ზე სიზუსტე 11,4%-ით გაიზარდა, ხარჯი კი 21,5%-ით შემცირდა.
Washington-ის უნივერსიტეტის, MIT-ისა და Meta-ს მკვლევრებმა წარმოადგინეს Context Language Models (CLM), ენის მოდელები, რომლებიც საკუთარ კონტექსტს თავად მართავენ. ნაშრომი 29 სექტემბერს arXiv-ზე გამოქვეყნდა.
აქამდე კონტექსტს გარე მექანიზმები მართავდნენ: ხელით აწყობილი სისტემები ან შეზღუდული ხელსაწყოები. CLM-ში ეს საქმე თავად მოდელს ევალება.
კონტექსტი ფაილის სახით
CLM-ში კონტექსტი ფაილის სახით ინახება. მოდელს მასში ცვლილებების შეტანა თავისუფლად შეუძლია: ან ახალ ტოკენებს ამატებს, ან Bash-ის დახმარებით ნებისმიერ მონაკვეთს არედაქტირებს. ყოველი ცვლილება მყისიერად აისახება მოდელის ცოცხალ კონტექსტში.
რადგან კონტექსტი ცალკე ფაილია, ერთ სისტემაში რამდენიმე მათგანი შეიძლება არსებობდეს და მიდგომა მრავალაგენტიან სისტემებზეც ვრცელდება. ტესტებში მოდელებმა ახალი ქცევებიც აჩვენეს: მრავალაგენტიანი ორკესტრაციისთვის ტრეკერები შექმნეს, შიდა ჩანაწერებისთვის ჩატის ახალი როლი შემოიღეს და კონტექსტის მართვის მრავალჯერადი ფუნქციები განსაზღვრეს.
ავტორების თქმით, შედეგი „Bitter Lesson“-ის იდეას ადასტურებს: თავისუფლება მოდელს ხელით დაწერილ წესებზე უკეთეს სტრატეგიებს აძლევს.
შედეგები
CLM დამატებითი წვრთნის გარეშე მუშაობს ისეთ მოდელებზე, როგორიცაა Qwen3.6-27B და GPT5.6-Sol. ღრმა კვლევის ბენჩმარკზე BrowseComp-Plus CLM-მა 32K კონტექსტის ლიმიტით 59,4% აჩვენა: ეს ყველაზე ძლიერ საბაზისო მეთოდზე 11,4%-ით მეტი სიზუსტეა, FLOPs-ის ხარჯი კი 21,5%-ით ნაკლები.
TerminalBench 2.1-ზე CLM-მა ყველაზე ძლიერი მეთოდის სიზუსტეს მიაღწია, მაგრამ 29,5%-ით ნაკლები FLOPs დახარჯა. 12-საათიან EdgeBench-ზე 5%-ით მაღალი ქულა აჩვენა 59%-ით ნაკლები გამოთვლითი ხარჯით. 24-საათიან ამოცანაზე, სადაც აგენტების ჯგუფი ექვს ურთიერთდამოკიდებულ რეპოზიტორზე მუშაობს, იმავე ბიუჯეტით 65%-ით მეტ დაჩქარებას მიაღწია.
სწავლება და ეფექტურობა
CLM-ის ქცევა ტექსტური ინსტრუქციებითაც იმართება: მომხმარებელს სასურველი სტრატეგიის უბრალოდ აღწერა შეუძლია. უნარების ოპტიმიზაციის ციკლი კონტექსტის მართვის ინსტრუქციებს თავად აუმჯობესებს; ContextBench-ზე ზუსტობა მაქსიმუმ 35,9 პუნქტით გაიზარდა, გამოთვლითი ხარჯი კი შემცირდა.
ონლაინ გაძლიერებითი სწავლების ახალი მეთოდით ავტორებმა Qwen3.5-9B მოდელის შედეგი BrowseComp-Plus-ზე 47,6%-ით გააუმჯობესეს და FLOPs-ის მოხმარება 12%-ით შეამცირეს.
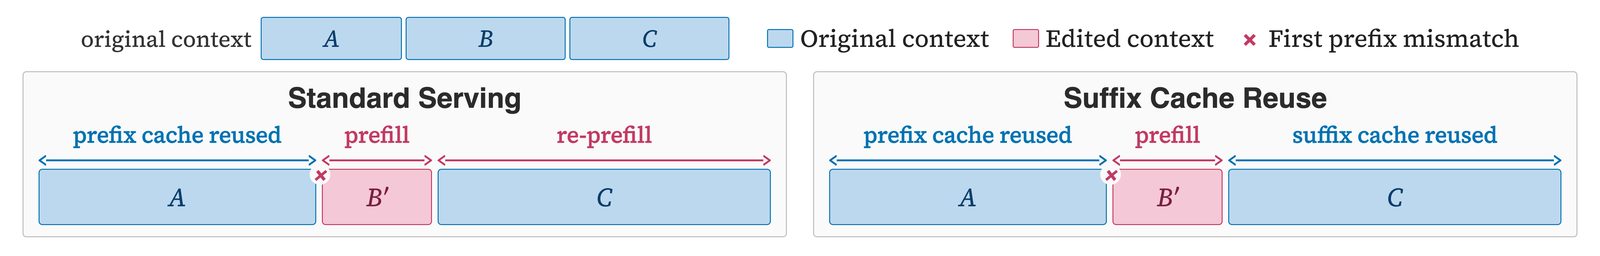
CLM კონტექსტს შუაშიც არედაქტირებს, რაც სტანდარტულ სერვინგ სისტემებს კეშის ხელახლა გამოთვლას აიძულებს. ავტორებმა ამ პრობლემის მოსაგვარებლად SGLang-ისთვის Suffix Cache Reuse (SCR) შეიმუშავეს: SCR ცვლილების შემდეგ უცვლელად დარჩენილი მონაკვეთების კეშს ინახავს და სერვერის გამოთვლით ხარჯს სტანდარტულ SGLang-თან შედარებით 35%-ით ამცირებს, იმავე შედეგიანობის შენარჩუნებით.
კოდი GitHub-ზეა გამოქვეყნებული. პრაქტიკულად, გრძელვადიანი აგენტებისთვის კონტექსტის მართვა მეტად თავად მოდელზე იქნება დამოკიდებული და ნაკლებად ხელით აწყობილ გარე სისტემებზე.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.