Stanford-მა და NVIDIA-მ კონტრასტული ენის მოდელი CLM-8B წარადგინა
Stanford-ის უნივერსიტეტისა და NVIDIA Research-ის გუნდმა 23 სექტემბერს Contrastive Language Models წარადგინა: მოდელი მდგომარეობებსა და მოქმედებებს ერთ სივრცეში აკავშირებს. CLM-8B Jev-ის დონეზე მუშაობს, მაგრამ 9-ჯერ უფრო სწრაფად.
რა არის CLM
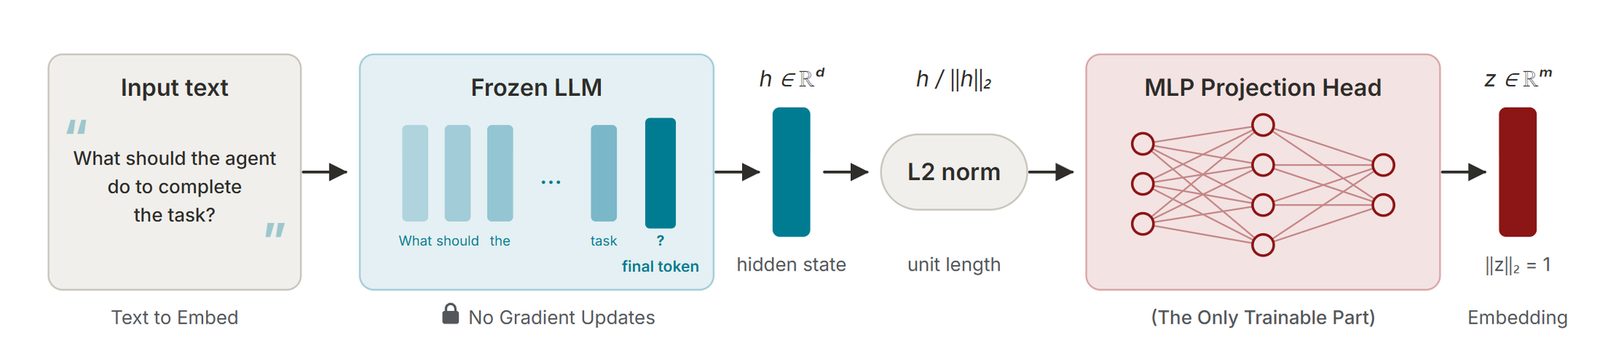
Stanford-ის უნივერსიტეტისა და NVIDIA Research-ის გუნდმა, ჯეკი კვოკის ხელმძღვანელობით, 23 სექტემბერს Contrastive Language Models (CLM) წარადგინა. ავტორების თქმით, ეს „System One“ ტიპის ახალი კლასის მოდელია: ნაბიჯ-ნაბიჯ მსჯელობის ნაცვლად ის სწრაფ და რეფლექსურ გადაწყვეტილებებს იღებს და მდგომარეობისა და მოქმედების ენკოდერებს ერთ, საერთო ემბედინგების სივრცეში აკავშირებს, ვარჯიში კი ორმხრივი InfoNCE კონტრასტული ფუნქციით მიმდინარეობს.
გამოყენებისას ორი ენკოდერი ერთად zero-shot კლასიფიკატორად მუშაობს: მოცემული მდგომარეობისა და კანდიდატ მოქმედებებისთვის CLM თითოეულს კოსინუსური მსგავსებით აფასებს და უმაღლეს ქულას ირჩევს. თითოეული ენკოდერი გაყინულ LLM-სა და 20 მილიონი პარამეტრის პროექციის თავს აერთიანებს, ამიტომ გრადიენტებს მხოლოდ თავი იღებს; Nemotron DQA-ზე სრული წინასწარი ვარჯიში ერთ RTX 4090-ზე დაახლოებით საათს გრძელდება.
მონაცემთა სამეტაპიანი რეცეპტი
წინასწარი ვარჯიში Nemotron DQA-ს დაახლოებით 60 მილიონ კითხვა-პასუხის წყვილს მოიცავს, სადაც კითხვა მდგომარეობაა, პასუხი კი მოქმედება. შუალედურ ეტაპზე ემატება დაახლოებით 30 მილიონი სინთეტიკური რთული ნეგატივი, რომლებიც Gemini 2.5 Flash-Lite-ის დახმარებით შეიქმნა, ხოლო შემდგომ ვარჯიშზე გამოიყენება დაახლოებით 1 მილიონი აგენტური ტრაექტორია Agent Data Protocol-იდან.
შედეგები და სიჩქარე
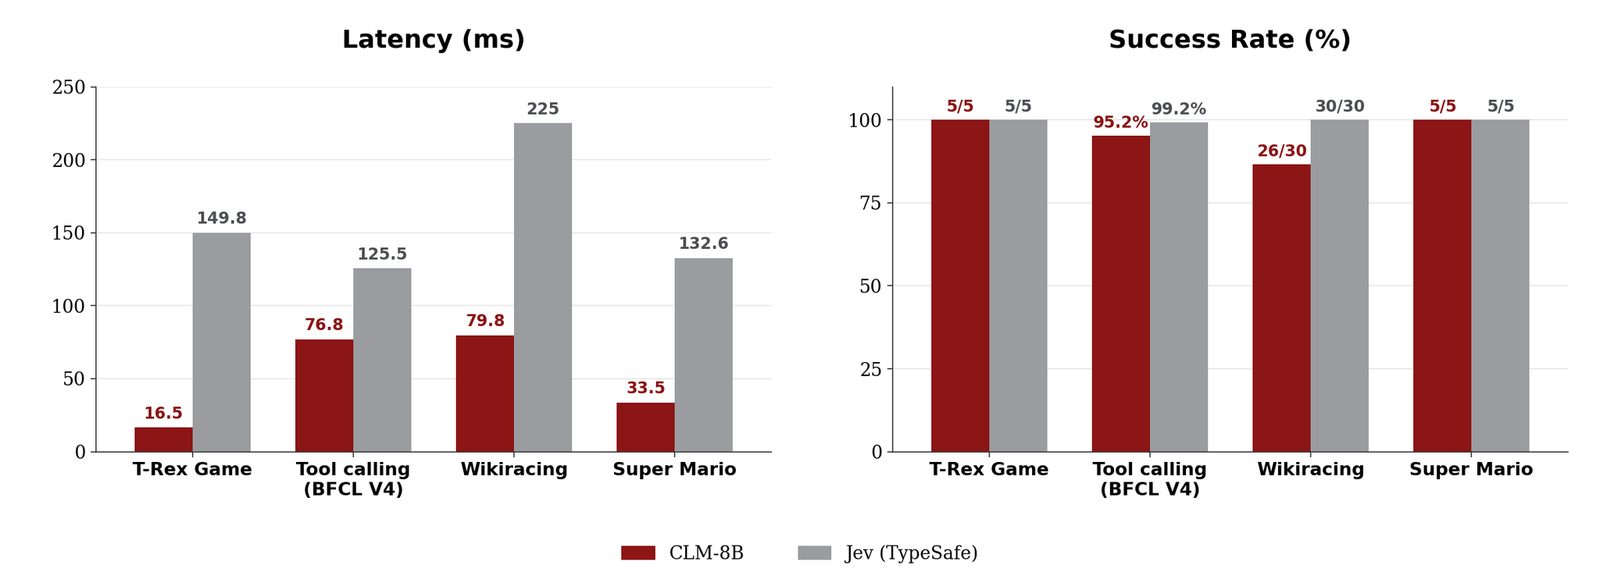
კომპიუტერით სარგებლობის, თამაშებისა და ხელსაწყოების გამოძახების ამოცანებზე CLM-8B Jev-ის დონეს ინარჩუნებს, მაგრამ 9-ჯერ უფრო სწრაფად მუშაობს; დაახლოებით 1000 კანდიდატი მოქმედებისას სხვაობა 13-ჯერ აღწევს. ტრაექტორიის ვერიფიკატორად დახვეწილი მოდელი ახალ რეკორდს ამყარებს DeepSWE-ზე (81,6%) და Terminal-Bench 2.1-ზე (87,6%), ხოლო H100 GPU-ზე ინფერენსი Jev-ზე 4-6-ჯერ უფრო სწრაფია; შემოწმება გადამოწმებისთვის გამოყოფილ 38 და 30 დავალებაზე ჩატარდა.
ინფრასტრუქტურა და შემდეგი ნაბიჯები
სერვინგის სტეკი მდგომარეობებსა და მოქმედებებს ერთმანეთისგან ჰყოფს, რომ მათი ემბედინგები დამოუკიდებლად დაიქეშოს: როცა იცვლება მხოლოდ მდგომარეობა, როგორც Super Mario-ში, თითო ნაბიჯს ხუთი გავლის ნაცვლად ერთი ჰყოფნის. გუნდმა CLM-ის სკალირების კანონზომიერებებიც დაადგინა: სატესტო კონტრასტული დანაკარგი კანონზომიერად მცირდება კომპიუტაციის, მონაცემებისა და მოდელის ზომის მატებასთან ერთად. მულტიმოდალური CLM-35B უკვე ვარჯიშობს და მომავალი თვის დასაწყისში გამოვა.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.