NVIDIA-მ ბიოლოგიური ფონდ-მოდელებისთვის MoE-ს ეფექტური წვრთნის გზა აღწერა
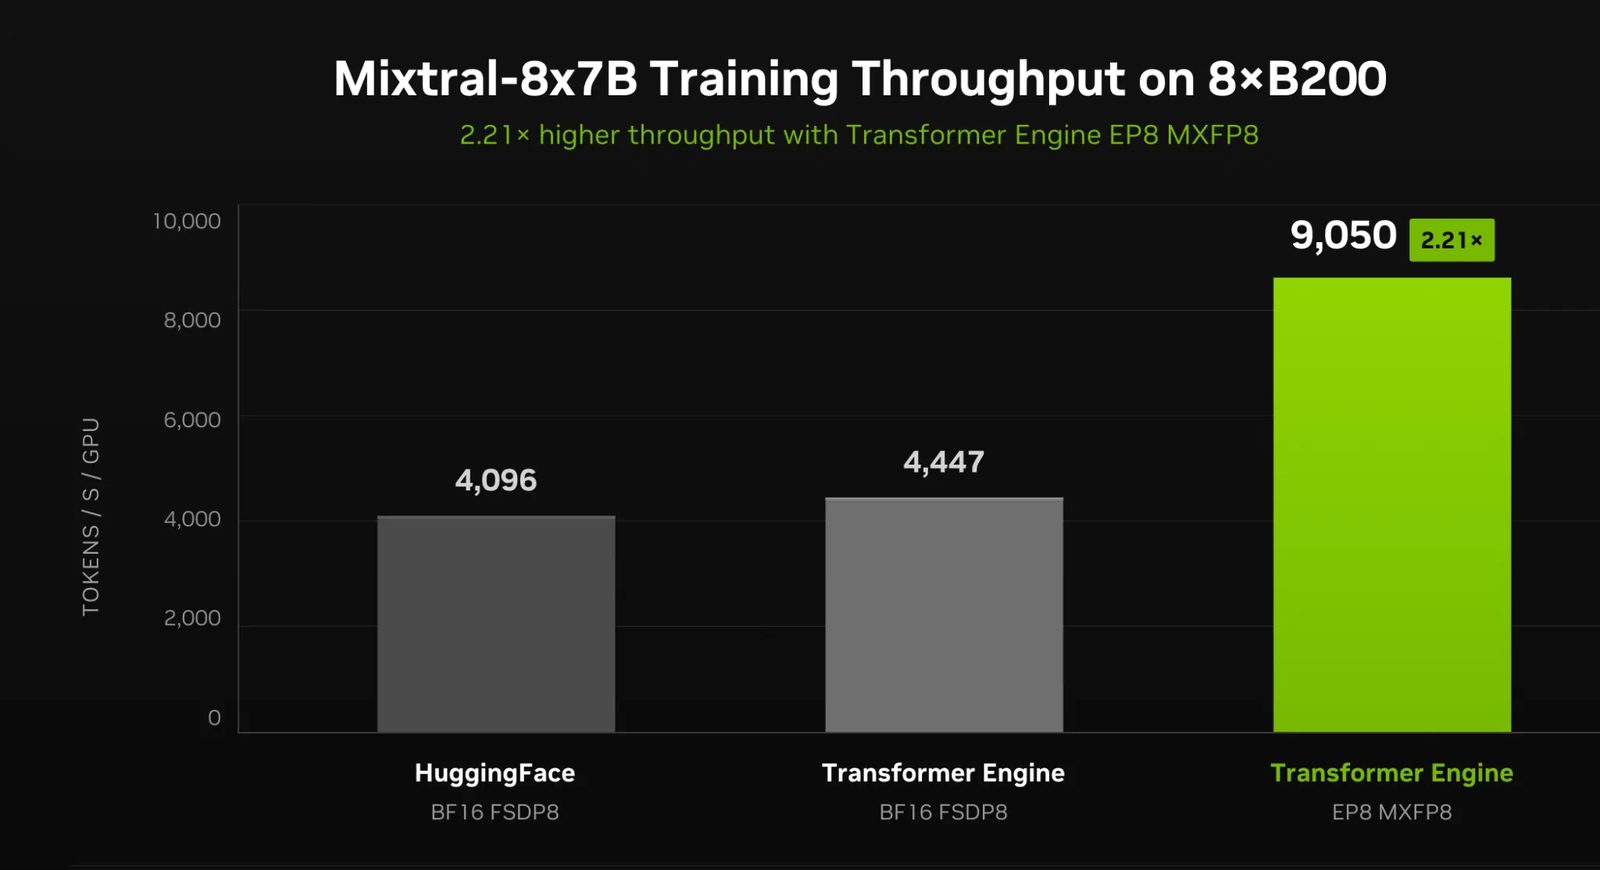
NVIDIA-ს ტექნიკური ბლოგის გზამკვლევი აღწერს, როგორ აჩქარებს Transformer Engine და BioNeMo-ს რეცეპტი ბიოლოგიური ფონდ-მოდელების MoE წვრთნას. რვა B200 GPU-ზე გაზომილი გამტარობა საბაზისო ვერსიას 2,21-ჯერ აღემატება.
NVIDIA-ს ტექნიკური ბლოგი აღწერს, როგორ შეიძლება ბიოლოგიური ფონდ-მოდელების წვრთნა შერეული ექსპერტების (MoE) არქიტექტურით უფრო ეფექტური გახდეს. გზამკვლევის ავტორები არიან Faradawn Yang, Peter St John, Kyle Tretina და Zoey Zhang.
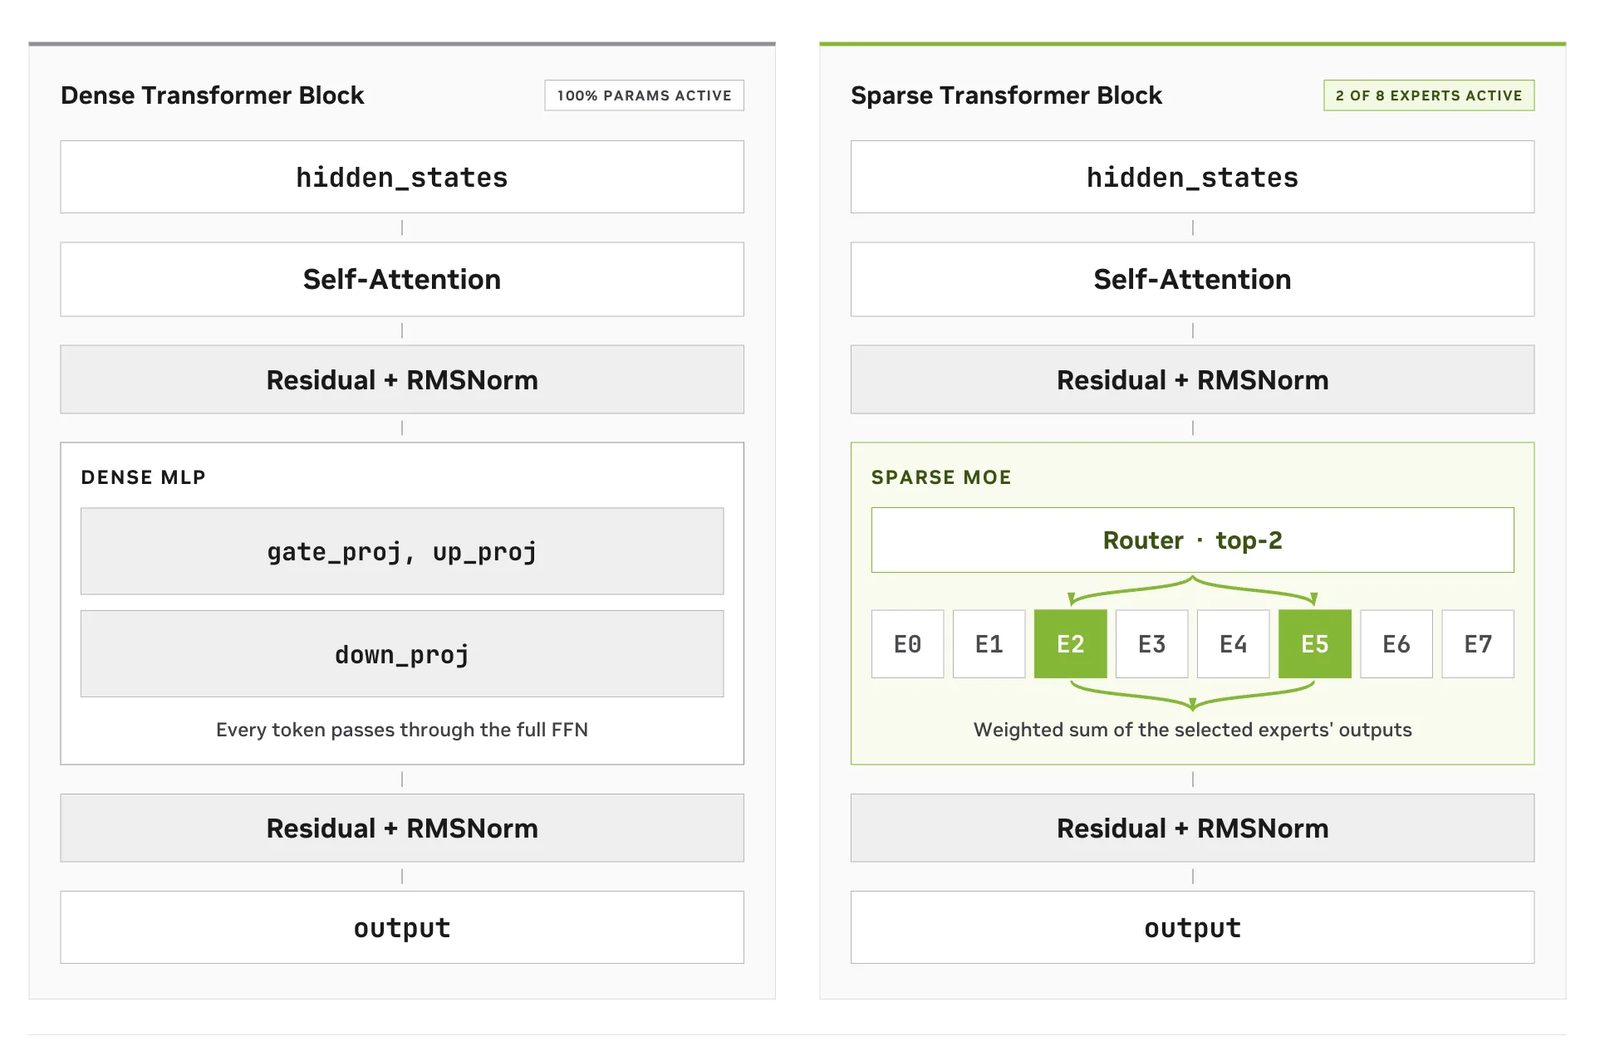
მკვრივ ტრანსფორმერებში ყოველი ტოკენი ყველა ფენაზე გადის, ამიტომ სიმძლავრის ზრდა წვრთნასაც და ინფერენსსაც აძვირებს. MoE არქიტექტურა feed-forward ბლოკს მრავალ ექსპერტად ყოფს და ტოკენზე მხოლოდ ნაწილს ააქტიურებს. შედეგი რეალიზაციაზეა დამოკიდებული: დანაწევრებული გამოთვლები GPU-ს გამოყენებას ამცირებს, როუტინგი კომუნიკაციის ხარჯს მატებს, პარამეტრების სიმრავლე კი მეხსიერებას ამძიმებს.
დაჯგუფებული ექსპერტები Python ციკლის ნაცვლად
პირველი სირთულე kernel-ების დანაწევრებაა: Hugging Face-ის საბაზისო ვარიანტში ექსპერტები Python ციკლში სათითაოდ მუშაობს და თითოეული ცალკე kernel-ს უშვებს. TE-ის GroupedLinear წონებსა და ტოკენებს აგროვებს და ყველა წრფივ გარდაქმნას ერთი დაჯგუფებული GEMM გამოძახებით ასრულებს, ექსპერტზე ტოკენების რაოდენობას კი split_sizes არგუმენტით იღებს. NVIDIA-ს სტეკს ეს პროექცია MXFP8 კვანტიზაციასთან ერთად GroupedMLP kernel-ში შერწყმა შეუძლია.
მეხსიერება და კვანტიზაციის ხარჯები
მეორე სირთულე მოდელის ზომაა: MoE მოდელებს მეტი პარამეტრი აქვთ, გენომიკური ამოცანები კი ხშირად გრძელ მიმდევრობებს იყენებს, რაც აქტივაციის მეხსიერებას ამძიმებს. BF16 მნიშვნელობას 16 ბიტში ინახავს, FP8 და MXFP8 კი 8 ბიტში. MXFP8 სკალირების კოეფიციენტს 32 მნიშვნელობის ყოველ ბლოკზე ანიჭებს, Blackwell GPU-ებზე კი ასეთი GEMM-ები სპეციალიზებულ Tensor Core ინსტრუქციებს იყენებს.
დაბალი სიზუსტით წვრთნისას მოდელი ძირითად წონებს მაინც 16 ბიტში ინახავს, ამიტომ კვანტიზაცია და დეკვანტიზაცია დამატებით სამუშაოს ქმნის. TE-ის Sequential API სამ ოპერაციას ერთ შერწყმულ ვარიანტად ცვლის: წინ გავლა გადადის ForwardGroupedMLP_CuTeGEMMSwiGLU_MXFP8-ზე.
რვა B200 GPU-ზე 2,21-ჯერ მეტი გამტარობა
Mixtral-8x7B მოდელის ტესტში რვა NVIDIA B200 Tensor Core GPU-ზე რეცეპტმა Hugging Face-ის საბაზისო ვერსიასთან შედარებით 2,21-ჯერ მეტ გამტარობას მიაღწია. შერწყმული MXFP8 GroupedMLP kernel-ები Blackwell-ის აპარატურას მოითხოვს, ექსპერტების პარალელიზმს კი მინიმუმ ორი GPU სჭირდება.
გზამკვლევში გაშვების ბრძანებებიცაა: ორ GPU-ზე L0_sanity კონფიგურაცია გარემოს შესამოწმებლად, შემდეგ L1_8x7B_ep ექსპერტების პარალელიზმითა (EP=8) და MXFP8 სიზუსტით რვა GPU-ზე. სრული კოდი BioNeMo Recipes რეპოზიტორიაშია.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.