Fireworks AI-მ Ember-1 გამოუშვა: Kimi K3-ის ხარისხი 40%-ით ნაკლები ტოკენით
Fireworks Research-მა Kimi K3-ის ბაზაზე აგებული სპეციალიზებული მოდელი Ember-1 წარადგინა. კომპანიის განცხადებით, ის საბაზო მოდელის ხარისხს ინარჩუნებს, მაგრამ დაახლოებით 40%-ით ნაკლებ ტოკენს ხარჯავს.
Fireworks AI-მ ახალი სპეციალიზებული მოდელი Ember-1 წარადგინა. ის Fireworks Research-ის გუნდმა Kimi K3-ის ბაზაზე ააგო. კომპანიის 2026 წლის 23 სექტემბრის განცხადებით, Ember-1 საბაზო მოდელის ხარისხს ინარჩუნებს, თუმცა 40%-ით ნაკლებ ტოკენს ხარჯავს: მოდელმა ზედმეტი მსჯელობა გამოტოვა და მხოლოდ პასუხზე მოქმედი აზროვნება შეინარჩუნა.
რატომ ძვირდება მსჯელობის მოდელები
Fireworks-ის თქმით, Kimi K3-ის მსგავსი მოდელები გენერირებული ტოკენების უმეტეს ნაწილს, ზოგჯერ 90%-ზე მეტს, შიდა მსჯელობაზე ხარჯავს და არა პასუხზე. მრავალნაბიჯიან აგენტურ სამუშაოებში ვითარება უარესდება: ყოველი ნაბიჯი წინა მსჯელობას კონტექსტში ხელახლა აბრუნებს, ამიტომ კონტექსტი ნაბიჯების რაოდენობის კვადრატის პროპორციულად იზრდება. მსჯელობის ინტენსივობის შემცირებამ პრობლემა არ გადაჭრა: დაბალი პარამეტრები ხარისხს ზედმეტად აქვეითებდა. ამიტომ გუნდმა მოდელს ეფექტური მსჯელობა ასწავლა: ჩატარდა 50-ზე მეტი სასწავლო ექსპერიმენტი და 200-ზე მეტი შეფასება, დაიწერა ახალი ალგორითმებიც.
ბენჩმარკები და Pareto-ს ფრონტი
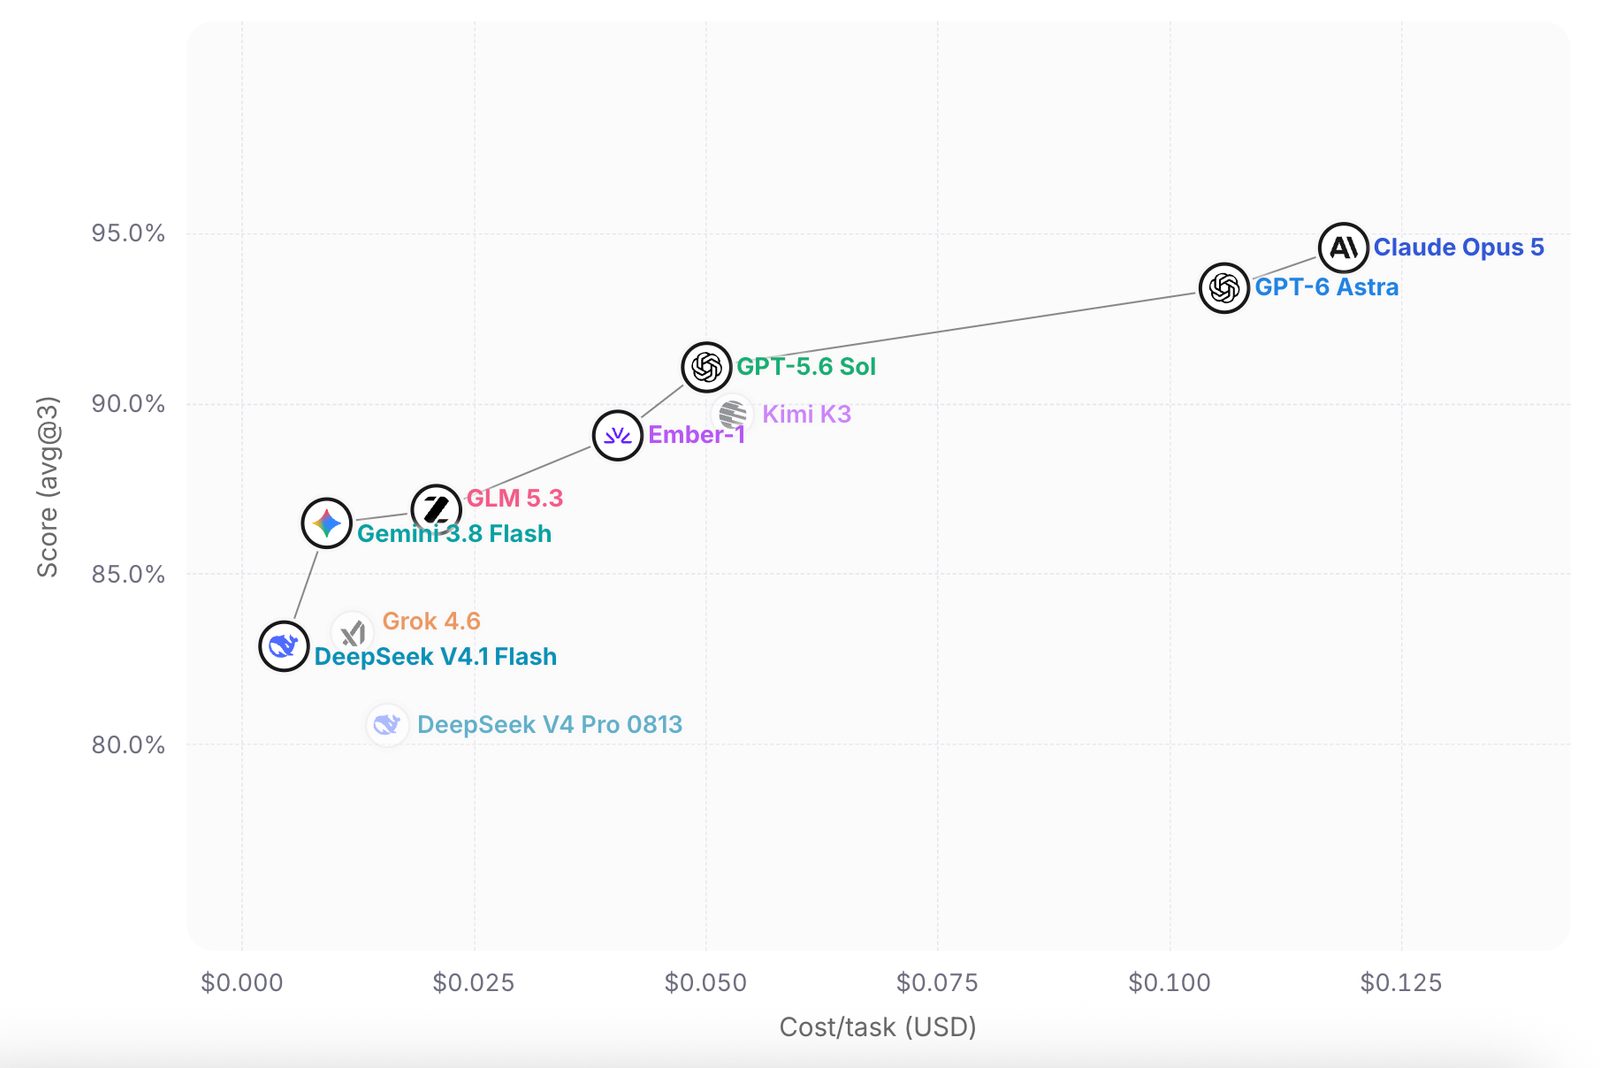
შვიდ ბენჩმარკზე და ორი მომხმარებლის საწარმოო ტრაფიკზე ჩატარებული ტესტებით დადგინდა, რომ Kimi K3-ის მსჯელობა ზუსტობის დაკარგვის გარეშე 35-50%-ით შემცირდება. Doximity-ის Bedside Bench-ზე, ექიმების მიერ დადასტურებულ ბენჩმარკზე 10 კატეგორიის 500 კლინიკური შემთხვევით, Ember-1-მა ხარჯის მიხედვით ახალი Pareto-ს ფრონტი დააფიქსირა ღია და დახურულ მოდელებს შორის, მათ შორის GPT-5.6 Sol-თან, GPT-6 Astra-სთან და Claude Opus 5-თან.
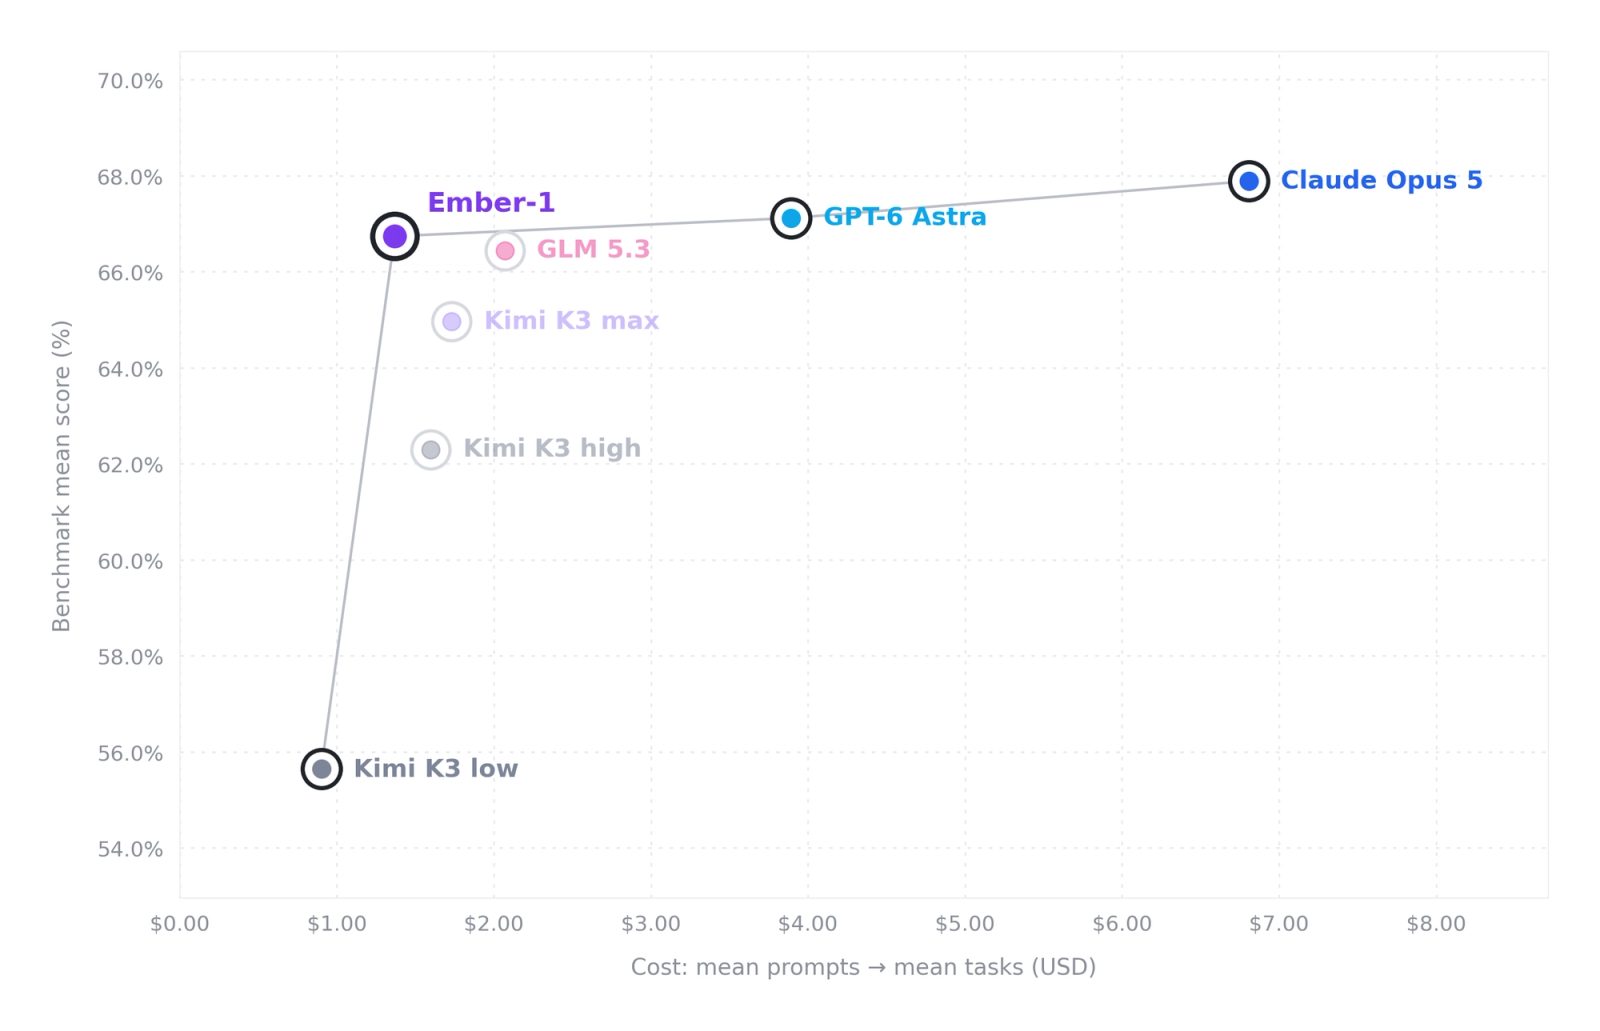
ცალკეულ ბენჩმარკებზე შედეგები ახლოსაა. Terminal Bench 2.1: 82,0% 80,9%-ის წინააღმდეგ. DeepSWE 1.1: 75,2% 66,4%-ის წინააღმდეგ. SWE-bench Verified: 92,2% 93,2%-ის წინააღმდეგ. SWE-Interact: 20,0% 21,3%-ის წინააღმდეგ. Fireworks-ის შეფასებით, დაბალი ინტენსივობის რეჟიმში Ember-1 Kimi K3-ს აღემატება.
A/B ტესტები, შიდა გაშვება და გეგმები
ორმა მომხმარებელმა Ember-1 საწარმოო კოდირების დატვირთვაზე ცოცხალი A/B ტესტებით შეამოწმა: დავალებაზე ტოკენების მოხმარება დაახლოებით 35%-ით შემცირდა ხარისხის შენარჩუნებით. ერთ ტესტში საშუალო ქულა 0,751-დან 0,753-მდე გაიზარდა, გამომავალი ტოკენები კი 49 300-დან 29 900-მდე დაეცა: მსჯელობის ტოკენების ხარჯი 71,3%-ით, საერთო ხარჯი 39%-ით შემცირდა. დავალების დასრულებისა და წარუმატებლობის მაჩვენებლები გაუმჯობესდა ან უცვლელი დარჩა, ერთი მომხმარებელი კი Ember-1-ს უკვე საწარმოო გარემოში იყენებს და საბაზო მოდელის სრულად ჩანაცვლებას გეგმავს.
მომხმარებლებამდე კომპანიამ მოდელი საკუთარ დეველოპერებზე გამოსცადა. შედეგს Fireworks „სიახლის არარსებობას“ უწოდებს: ინჟინრებმა მუშაობა ისე გააგრძელეს, ცვლილება ვერ შეამჩნიეს. Ember-1 Serverless-ზე კვლევითი პრევიუს სახით, საბაზო Kimi K3-ის გვერდით ვრცელდება. ასევე იშვება დაფაინტუნების მხარდაჭერა კომპანიებისთვის, რომლებსაც საკუთარ მონაცემებზე მორგებული, ტოკენ-ეფექტური მოდელის აწყობა სურთ.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.