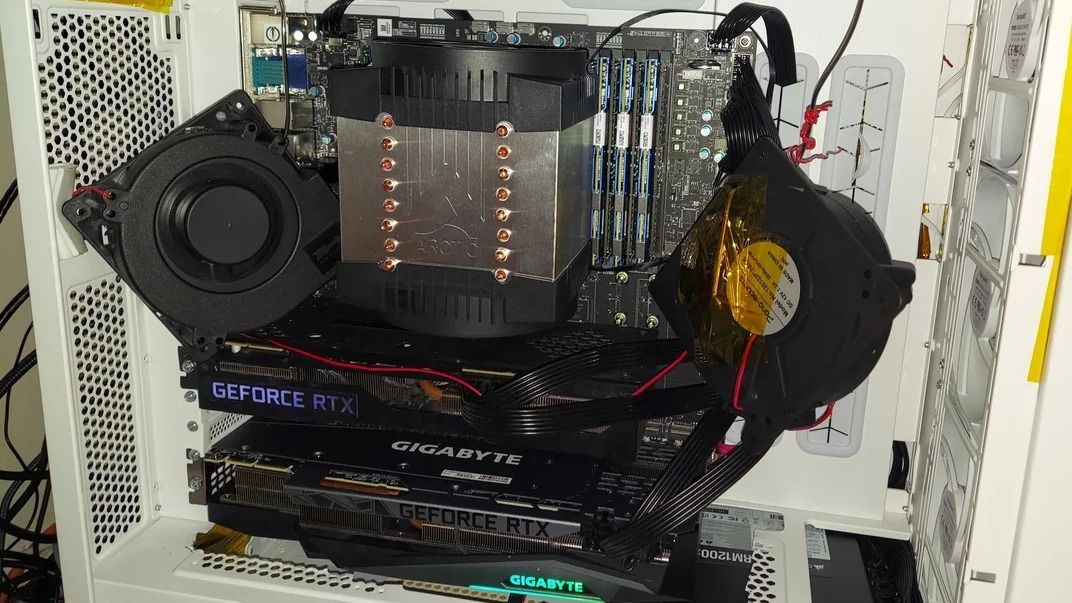
ჰომლებერი 2,8T Kimi K3 მოდელს ორი RTX 3090-ითა და Optane-ით 3,11 ტოკენ/წმ-ზე უშვებს
ჰომლებერის მეორე თაობის Optane სისტემას ორი RTX 3090 დაემატა და Moonshot-ის 2,8 ტრილიონი პარამეტრის Kimi K3 მოდელი წამში 3,11 ტოკენის სიჩქარით მუშაობს. მოდელის თითქმის ნახევრის RAM დისკზე გადატანამ გენერაცია დაახლოებით 41%-ით დააჩქარა.
სახლის ლაბორატორიის ენთუზიასტმა Reddit-ზე გამოქვეყნებულ შემდგომ პოსტში მეორე თაობის Optane-ზე დაფუძნებული AI სისტემის გაუმჯობესებები დეტალურად აღწერა და ორი RTX 3090 დაამატა, რათა Moonshot-ის 2,8 ტრილიონი პარამეტრის Kimi K3 მოდელი წამში 3,11 ტოკენის სიჩქარით მუშაობდეს. მოდელის თითქმის ნახევრის RAM დისკზე გადატანამ გენერაციის სიჩქარე დაახლოებით 41%-ით, ხოლო prompt-ის შეფასება დაახლოებით 26%-ით გაზარდა. სისტემას კვლავ დამატებითი ვენტილატორები სჭირდება, რადგან Optane მეხსიერება ძალიან ცხელდება.
წარმადობა RAM დისკის გამოყენებით და მის გარეშე
ორივე GPU-ს შემთხვევაში, RAM დისკის გარეშე, გენერაციის სიჩქარე წამში 2,20 ტოკენი იყო, prompt-ის შეფასების სიჩქარე კი წამში 13,3 ტოკენი. როცა 94 ნაწილიდან 45, ანუ 865 GB მოდელის 414 GB, tmpfs RAM დისკში იყო, დარჩენილი კი Optane-ში, გენერაციის სიჩქარემ წამში 3,11 ტოკენს მიაღწია, prompt-ის შეფასების სიჩქარემ კი წამში 16,8 ტოკენს. ავტორის გაზომვები llama.cpp-ით შესრულდა, Optane-ის ნაწილისთვის DAX ჩართული იყო.
ასეთი მიდგომა ახალი არ არის ენთუზიასტებისთვის, რომლებიც სისტემურ მეხსიერებას გამოყოფენ განსაკუთრებით სწრაფი მუშაობისთვის ფსევდო-არავოლატილური რეჟიმით, როცა ის დისკივით ჩანს, თუმცა დღეს ყველას არ აქვს ამდენი თავისუფალი RAM.
როგორ გამოიყენება GPU-ები და მეხსიერება
ორ RTX 3090-ს თითოეულს 24 GB VRAM აქვს, სულ 48 GB, რაც 865 GB მოდელის ფაილის დაახლოებით 5,5%-ია, ამიტომ ისინი მოდელს მთლიანად არ ინახავენ. მოდელი mixture-of-experts ტიპისაა და 896 ექსპერტს მოიცავს; თითო ტოკენზე აირჩევა 16 ექსპერტი, კიდევ ორი საერთო ექსპერტი, ხოლო 2,8 ტრილიონიდან 104 მილიარდი პარამეტრი აქტიურია. routed-expert ტენზორები CPU-ს მხარეს რჩება, Optane-სა და RAM დისკში, ხოლო RTX 3090-ები ამუშავებენ attention-ს, feed-forward ქსელის მკვრივ ფენას, საერთო ექსპერტებს, სხვა აქტიურ-მკვრივ კომპონენტებს, KV cache-ს, შენახულ საუბრის კონტექსტს და GPU-ს გამოთვლით ბუფერებს.
DRAM VRAM-ზე ნელია, თუმცა მაინც შეუძლია სოლიდური დაჩქარების მიცემა, და GPU-ებით მიღებული სიჩქარე იმ დიაპაზონში აღმოჩნდა, რასაც ავტორი ელოდა, მას შემდეგ, რაც საწყის თრედში წამში 2-დან 4 ტოკენამდე სიჩქარე ივარაუდა.
მოდელის ზომა და კვანტიზაცია
ყველა 2,8 ტრილიონი პარამეტრი 16-ბიტიანი სიზუსტით დაახლოებით 5,6 TB-ს დაიკავებდა. Moonshot-ის საკუთარი რელიზი 4-ბიტიან MXFP4 ფორმატს იყენებს და დაახლოებით 1,56 TB-ია, ხოლო აქ გამოყენებული Q2_K ფაილი მოდელს 865 GB-მდე ამცირებს, რაც პარამეტრზე საშუალოდ 3 ბიტზე ნაკლებია. მიმოხილვაში აღნიშნულია, რომ 865 GB მაჩვენებელი სავარაუდოდ გიბიბაიტებშია, თუმცა GB მნიშვნელობები ისეა გამოყენებული, როგორც ჰომლებერმა დაწერა.
გაგრილება და სამომავლო გეგმები
GPU-ების დაყენება ნაწილობრივ იმიტომ გადაიდო, რომ კორპუსის მოდიფიკაცია იყო საჭირო: მეტალის მოჭრა და კვების ბლოკის გადაადგილება, რათა GPU-ებისა და მათი გაგრილებისთვის ადგილი გამოთავისუფლებულიყო. გაგრილება კვლავ მთავარ პრობლემად რჩება, და Optane DIMM-ებისთვის განკუთვნილი ორი 12W გამწოვი ვენტილატორი ადგილზე რჩება მაშინაც კი, როცა ორი 350W კლასის GPU მუშაობს. ავტორი წინ კიდევ ბევრ ოპტიმიზაციას ხედავს, მათ შორის „customized quantization“-ს, რომელიც შესაძლოა ადვოკატ Nick Mermiges-ის მიერ გამოყენებული ტექნიკების მსგავსი იყოს, და აღნიშნავს, რომ მხოლოდ სიჩქარე საკმარისი არ არის, რადგან გამომავალი მონაცემების ხარისხიც უნდა გავითვალისწინოთ.
წყაროები: Tom's Hardware
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.