NVIDIA-ს SWE-Serve: აგენტების პატჩები ლოკალურ ტესტებს გადიან, რეალურ სერვირებაზე კი ვარდებიან
NVIDIA-მა SGLang-ის გუნდთან ერთად SWE-Serve გამოაქვეყნა: კოდის აგენტების პატჩები, რომლებიც ყველა სხვა შემოწმებას გადიან, რეალურ სერვირებაზე დაახლოებით სამიდან ერთ შემთხვევაში ვარდება.
NVIDIA-მა 23 სექტემბერს SWE-Serve გამოაქვეყნა, ბენჩმარკი, რომელიც ზომავს სხვაობას ლოკალურად გავლილ ტესტებსა და რეალურ სერვირებაში მუშა პატჩებს შორის. კოდის აგენტის პატჩს ტესტები შეიძლება გაიაროს, მაგრამ ვერ იმუშაოს მაშინ, როცა სერვერი რეალურ მოდელს ტვირთავს. ბენჩმარკი SGLang-ის გუნდის მონაწილეობით შეიქმნა და SGLang-ის 83 შერწყმულ pull request-ს 53 ამოცანად აქცევს.
რას ამოწმებს SWE-Serve
ამოცანები ექვს ოჯახად იყოფა: სპეკულატიური და გაფართოებული დეკოდირება (14), მოდელებისა და ბექენდების ჩართვა (12), ბირთვები, კვანტიზაცია და წარმადობა (8), სერვირების API-ები და runtime-ის სისწორე (8), ქეშირება (7), განაწილებული შესრულება და დაგეგმვა (4). CPU-ზე 12 ამოცანა მუშაობს, ერთ NVIDIA H100-ზე კი 41; პირველი გამოშვება სხვა inference ძრავებს, მრავალ GPU-ს და მრავალკვანძიან სერვირებას არ მოიცავს. საცნობარო გადაწყვეტა შვიდ ფაილში საშუალოდ 553 ხაზს ცვლის, რეალურ სერვერს კი 19 ამოცანა რთავს.
რას იჭერს ცოცხალი სერვირების ტესტები
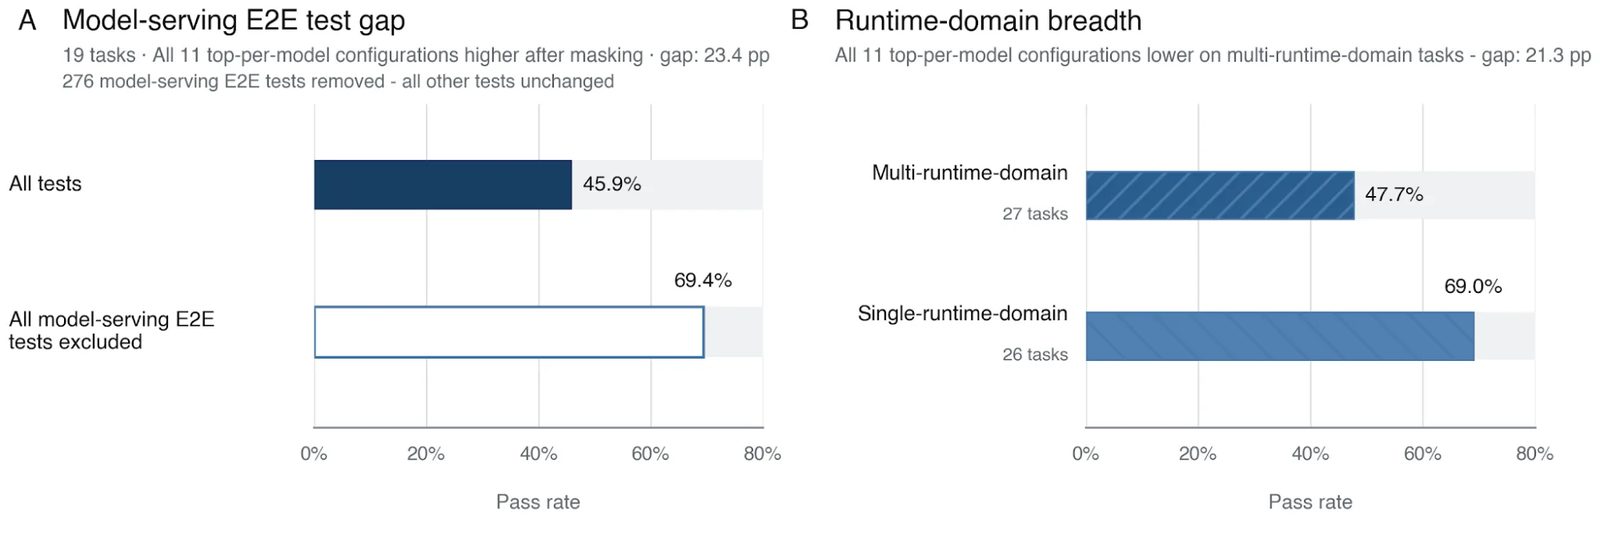
ცოცხალ სერვერზე მომუშავე 19 ამოცანაზე ერთი და იგივე 627 პატჩი სრული ვერიფიკატორით 45,9%-ში გადის; სერვირების ტესტების გამორიცხვით მაჩვენებელი 69,4%-მდე იზრდება, ანუ 147 პატჩი მარცხიდან წარმატებაზე გადავიდა. სხვა შემოწმებების გავლილი პატჩების დაახლოებით მესამედი ერთ სერვირების ტესტს მაინც ვერ უძლებს. ამ ამოცანებში 276 სერვირების ტესტია, 242 მათგანი SGLang-იდანაა აღებული ან გადაკეთებული. Gemma 4 MoE-ს მაგალითი ნათელია: 33 პატჩიდან 16-მა ყველა სხვა შემოწმება გაიარა, სერვირების ტესტზე კი ვარდა.
NVIDIA-ს ავტორები ხაზს უსვამენ, რომ წარმატება მხოლოდ ვერიფიკატორის დაკმაყოფილებას ნიშნავს და არა იმას, რომ პატჩი გამოსაქვეყნებლად მზადაა ან SGLang-ის შემქმნელებმა დაამტკიცეს.
სად ვარდებიან აგენტები
მოთხოვნიდან პასუხამდე გზა ოთხ runtime დომენად იყოფა: მოთხოვნების დამუშავება და I/O, დაგეგმვა და მოთხოვნის სასიცოცხლო ციკლი, მოდელის შესრულება, KV-cache-ისა და რესურსების მართვა. ერთ დომენში მოქცეულ 26 ამოცანაზე მაჩვენებელი 69,0%-ია, მრავალ დომენზე გადაჭიმულ 27 ამოცანაზე კი 47,7%, ანუ სხვაობა 21,3 პროცენტული პუნქტია.
მკვლევრებმა 11 მოდელი და 31 კონფიგურაცია mini-swe-agent-ით, მხოლოდ Bash-ის გამოყენებით და დახურულ რეჟიმში შეამოწმეს. საშუალო pass@1 34,6%-დან 75,5%-მდე მერყეობს. ცხრილს Claude Opus 5 და GPT-5.6 Sol 75%-ით ლიდერობს; ოთხი მოდელი 64%-ზე გაჩერდა, თუმცა ერთ ამოცანაზე ხარჯი 0,95 დოლარიდან 7,24 დოლარამდე, დრო კი 25,5-იდან 99,9 წუთამდე იცვლება.
ბენჩმარკის შესაქმნელად 786 წყარო გადაიხედა, 156 კანდიდატი აიწყო და 53 შეირჩა; უცვლელი კოდი ახალი ქცევის ტესტებზე უნდა ვარდებოდეს, რეგრესიაზე კი გადიოდეს. შეფასებისას ვები და upstream რეპოზიტორიები დაბლოკილია, რომ მოდელებმა მზა გადაწყვეტები ვერ მოიძიონ.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.