Ai2-მ Olmo-core 3 გამოუშვა ტრილიონ პარამეტრამდე მასშტაბირებადი MoE მოდელების გასაწვრთნელად
Ai2-მ ღია სისტემა Olmo-core 3 გამოუშვა, რომელიც MoE მოდელების გაწვრთნას ტრილიონ პარამეტრამდე ზრდის. ერთ ბენჩმარკში ექსპერტების აუზი 8-დან 128-მდე გაიზარდა, გაწვრთნის გამტარუნარიანობა კი 5%-ზე ნაკლებად შემცირდა.
Ai2-მ (Allen Institute for AI) 1 ოქტომბერს Olmo-core 3 გამოუშვა. ეს მისი ღია ჩარჩოს განახლებაა გადაკეთებული MoE (ექსპერტთა ნარევის) გაწვრთნის სისტემით. ინსტიტუტის განცხადებით, ის ტრილიონ პარამეტრამდე მასშტაბირებაზეა გათვლილი და შემდეგი თაობის Olmo-ს ერთ-ერთი ძირითადი სისტემაა.
MoE მოდელი თითოეული მონაცემისთვის მხოლოდ ნაწილს იყენებს, თუმცა მთლიანი მოდელის შენახვა და მონაცემების სწორ ექსპერტებთან გადამისამართება ხარჯებს ქმნის, რომლებიც ზომასთან ერთად იზრდება.
რას ცვლის Olmo-core 3
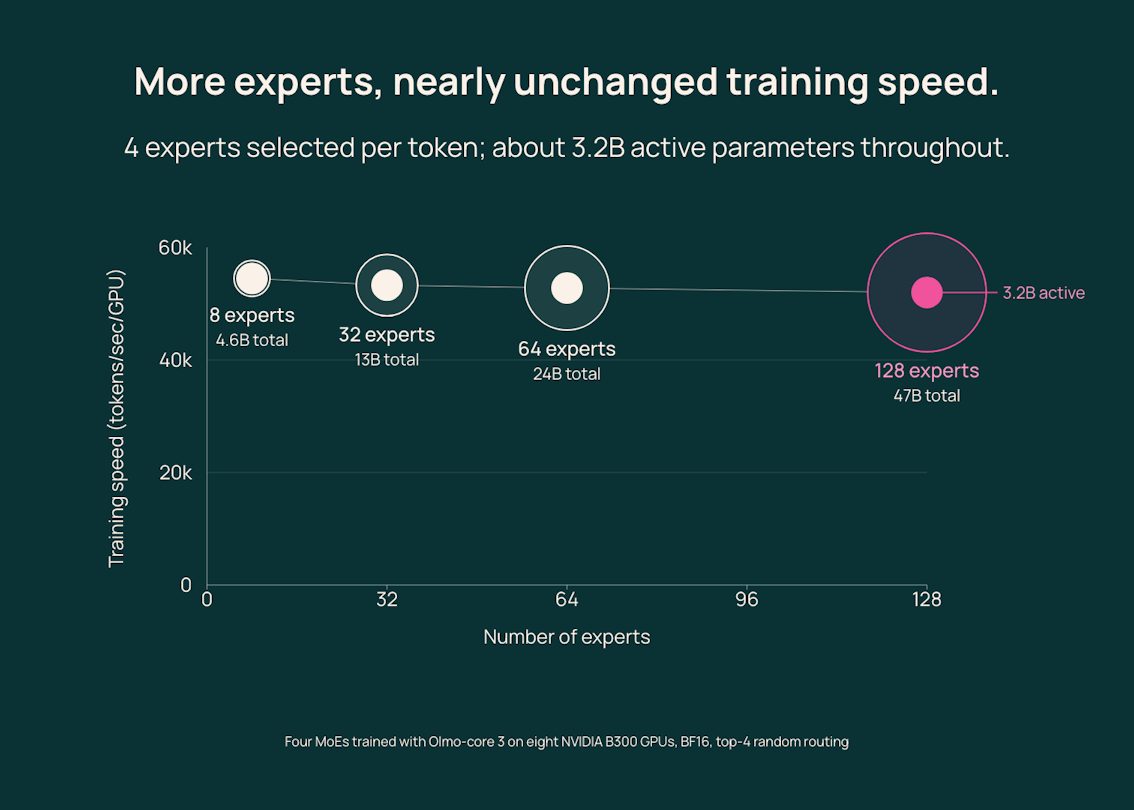
ერთ ბენჩმარკში ექსპერტების აუზი 8-დან 128-მდე გაიზარდა, ყოველ ტოკენზე კი კვლავ ოთხი ექსპერტი ირჩეოდა, აქტიური პარამეტრების რაოდენობა ტოკენზე დაახლოებით 3,2 მილიარდის დონეზე შენარჩუნდა. პარამეტრების ჯამური ტევადობა 4,6 მილიარდიდან 47 მილიარდამდე გაიზარდა, გამტარუნარიანობა კი 5%-ზე ნაკლებად შემცირდა.
ძველი ვერსია სრულად შარდირებულ მონაცემთა პარალელიზმს (FSDP) იყენებდა, Olmo-core 3 კი განაწილებული მონაცემთა პარალელიზმის (DDP) სქემაზე გადავიდა: ექსპერტები GPU-ებზე რჩება, მონაცემები მათკენ მიემართება.
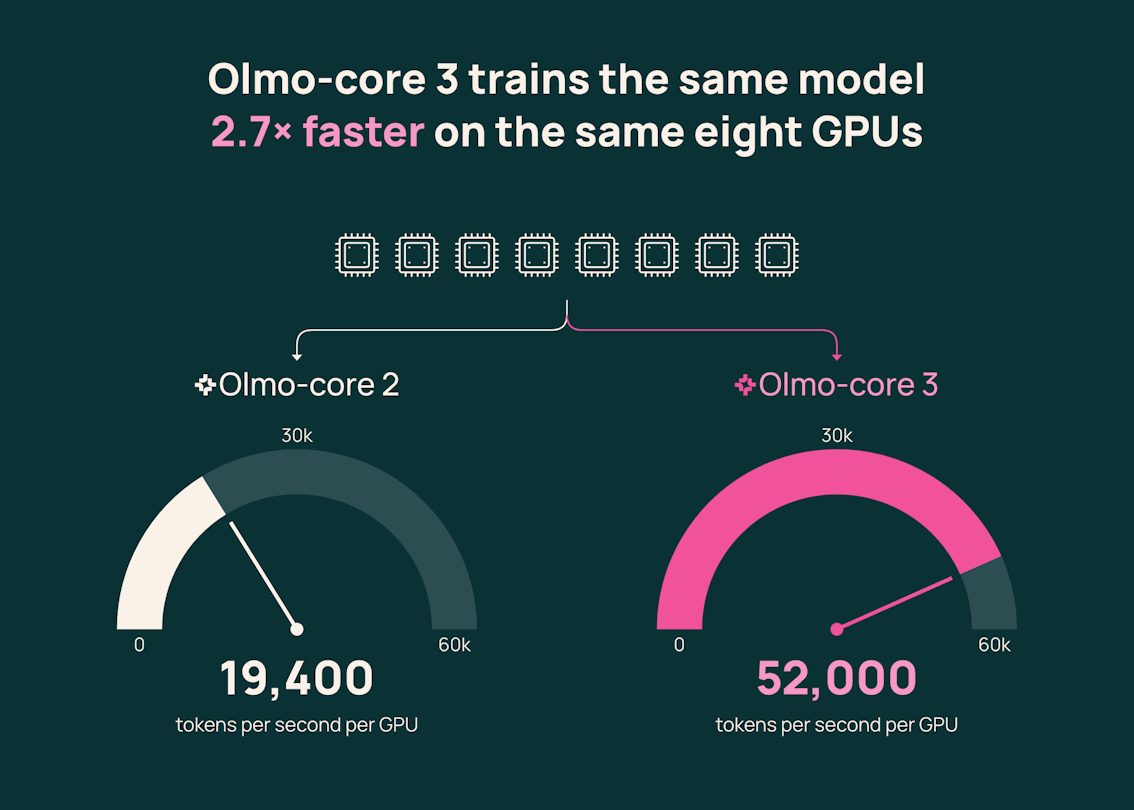
NVIDIA-ს რვა B300 GPU-ზე 47 მილიარდი პარამეტრის მქონე MoE მოდელმა ახალი სისტემით ერთ GPU-ზე წამში 52 000 ტოკენი დაამუშავა, ძველი ვერსიით კი 19 400, ანუ დაახლოებით 2,7-ჯერ მეტი.
ტრილიონ პარამეტრამდე მასშტაბირება
Olmo-core 3 მოდელებს აპარატურაზე ექსპერტების და პაიპლაინის პარალელიზმითა და განაწილებული ოპტიმიზატორით ანაწილებს. მეტამონაცემები GPU-ებზე რჩება, მარშრუტირებული მონაცემები პირდაპირ ექსპერტის ბუფერში ხვდება, დაჯგუფებული GEMM კი მცირე გამოთვლებს აერთიანებს.
სისტემა ასევე უჭერს მხარს MXFP8-ს, დაბალი სიზუსტის ფორმატს: ოთხ B300 GPU-ზე მან BF16-თან შედარებით დაახლოებით 21% მეტი გამტარუნარიანობა აჩვენა, პიკური აქტიური მეხსიერება კი 103 GiB-დან 95 GiB-მდე დაეცა.
Ai2-მ ასევე გატესტა 1,2 ტრილიონი პარამეტრის მოდელი 512 GPU-ზე, სადაც ერთ ტოკენზე 58,36 მილიარდი პარამეტრია აქტიური; მაქსიმალური გამტარუნარიანობა ერთ GPU-ზე 858 TFLOP/s იყო. ტესტებმა შემთხვევითი მარშრუტიზაციით სისტემის მუშაობა გაზომა და არა მოდელის ხარისხი; DeepEP v2-ის ექსპერიმენტმა 2,38 ტრილიონ პარამეტრს მიაღწია მოკლე ტესტში.
ღია ინფრასტრუქტურა
შემდეგი თაობის Olmo MoE არქიტექტურას გამოიყენებს და ყველაზე ძლიერი Olmo უნდა გახდეს, უდიდეს მონაცემთა კრებულზე გაწვრთნილი და ყველაზე გრძელი კონტექსტით. სისტემა სრულად ღიაა: მკვლევრებს შეუძლიათ მასზე საკუთარი MoE მოდელების გაწვრთნა და სხვა აპარატურაზე ადაპტაცია; ტექნიკური ანგარიში, კოდი და ინტერაქტიული დემოც უკვე ხელმისაწვდომია.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.