NVIDIA-მ ცხრილისებრი პროგნოზირებისთვის ღია მოდელი Kumo Tabular გამოუშვა
NVIDIA-მ Kumo Tabular გამოუშვა, ღია საბაზისო მოდელი, რომელიც ახალი მწკრივების წარწერებს ვარჯიშისა და მახასიათებლების მომზადების გარეშე, ერთი წინ გავლით პროგნოზირებს და ოთხ ბენჩმარკზე პირველ ადგილზეა.
NVIDIA-მ 29 სექტემბერს Kumo Tabular გამოუშვა. ეს ღია საბაზისო მოდელი ცხრილისებრი მონაცემებისთვისაა და NVIDIA Kumo Structured კოლექციაში შედის. წონები Hugging Face-ზეა, კოდი კი კომპანიის ღია ბიბლიოთეკაში (structured-data-models). მოდელი OpenMDW-1.1 ლიცენზიით ვრცელდება, რაც კომერციულ გამოყენებას იძლევა.
მოდელს წარწერებიანი მწკრივების ცხრილი ეძლევა, ის კი ახალი მწკრივების წარწერებს ერთი წინ გავლით აბრუნებს: ვარჯიშის, დახვეწისა და მახასიათებლების მომზადების გარეშე, როგორც კლასიფიკაციის, ისე რეგრესიისთვის. მოდელი სამ ზომაშია, 28 მილიონიდან 215 მილიონ პარამეტრამდე, და მხოლოდ ხელოვნურ ცხრილებზე გაწვრთნეს.
როგორ მუშაობს
Kumo Tabular ტრანსფორმერია, რომელიც ცხრილის სტრუქტურაზეა აწყობილი: იყენებს სვეტის, მწკრივისა და კონტექსტურ ყურადღებას, TabICL-ისა და TabPFN-ის მიდგომის მსგავსად. თითოეული მნიშვნელობა საკუთარი სვეტის განაწილებაში ფასდება, მწკრივის შიგნით მახასიათებლების ურთიერთქმედება ფიქსირდება, ხოლო ცნობილი წარწერების მქონე მწკრივები ახალ მწკრივებს უკავშირდება. კონტექსტი მოთხოვნებს არასდროს უყურებს, ამიტომ მისი გასაღებები ერთხელ გამოითვლება და შემდგომი პროგნოზებისთვის მრავალჯერ გამოიყენება. რიცხვითი და კატეგორიული მონაცემები Fourier-ის მახასიათებლებს გადის, გამოტოვებული მნიშვნელობები კი შევსებას არ საჭიროებს. ყურადღების ტემპერატურა გასაღებების რიცხვის ლოგარითმთან ერთად იზრდება, რომ გაზრდილ ცხრილებზე მკვეთრი დარჩეს.
ვარჯიში ხელოვნურ მონაცემებზე
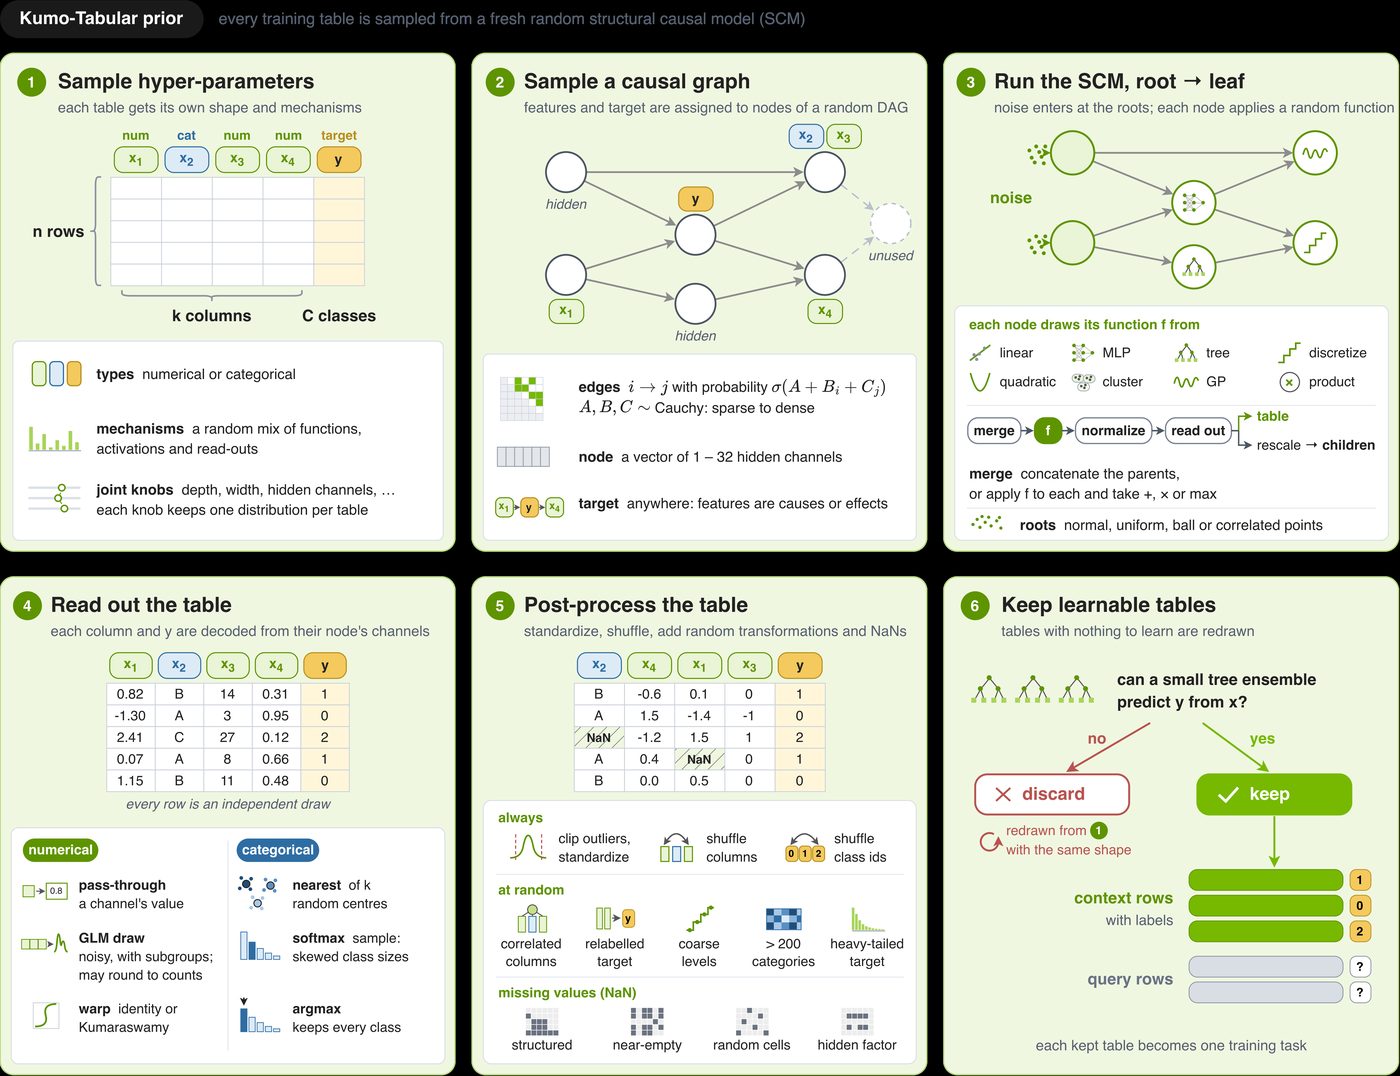
ყოველი სავარჯიშო ცხრილი სტრუქტურული მიზეზობრიობის მოდელიდან (Structural Causal Model) გენერირდება და შემდეგ მუშავდება: სვეტების ჯგუფები ერთმანეთთან სცდება, კიდური მნიშვნელობები იჭრება, ცხრილში გამოტოვებული მონაცემები ხელოვნურად ემატება, ხოლო tree-ensemble შემოწმება კანონზომიერების გარეშე დარჩენილ ცხრილებს ყრის. ვარჯიში სამ ეტაპად წარიმართა: 1 024 მწკრივიანი და 100 სვეტამდე ცხრილებიდან 400-10 240 მწკრივიან კონტექსტამდე, ბოლოს კი 60 000 მწკრივამდე. Small, Medium და Large ვერსიებმა დაახლოებით 35, 71 და 137 მილიონი ხელოვნური ცხრილი ნახა. კლასიფიკაცია და რეგრესია ცალკე მოდელებად ვარჯიშობს.
შედეგები
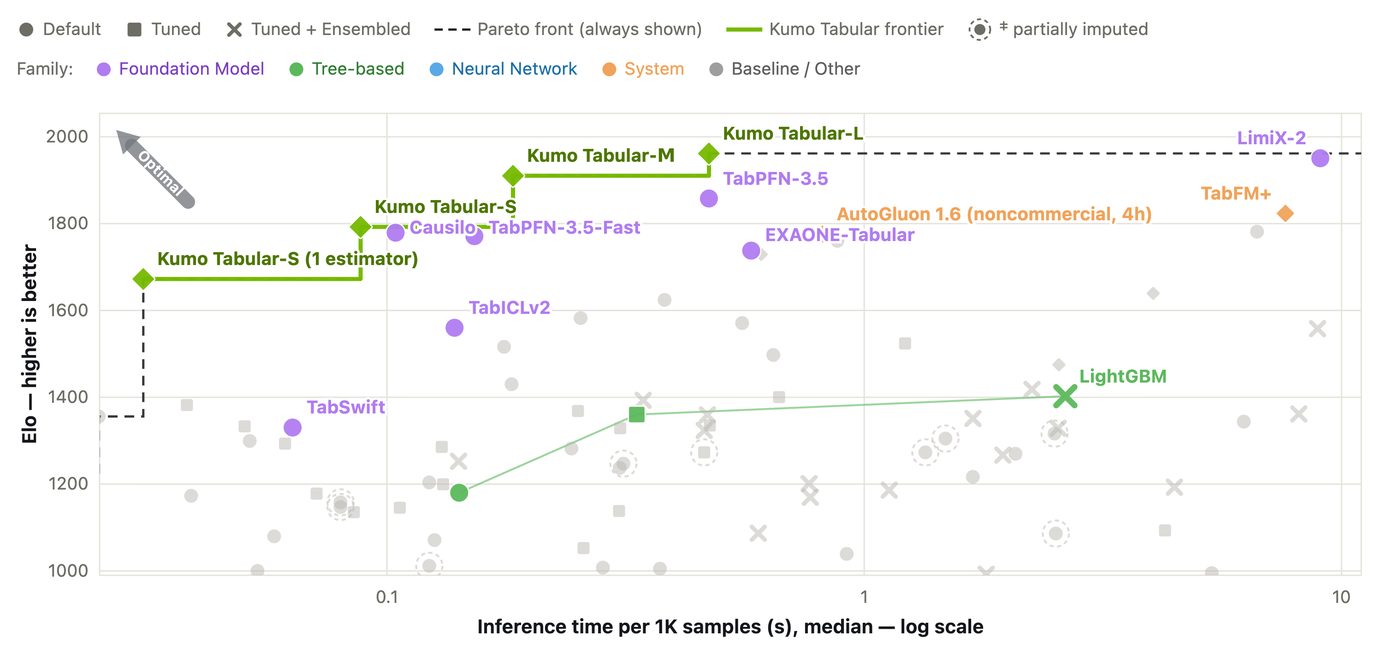
TabArena-ზე Kumo Tabular 1950 ELO-ით პირველ ადგილზეა და, NVIDIA-ს განცხადებით, ერთი RTX 6000 Pro-ს პირობებში LimiX-2-ზე 17-ჯერ უფრო სწრაფად მუშაობს. BeyondArena-ზე მოდელმა 1418 ELO და 7,78% Improvability შეფასება მიიღო და კვლავ პირველია. TALENT-ზე ის საერთო რანჟირებაში პირველია კლასიფიკაციის სიზუსტით, log-loss-ითა და რეგრესიის RMSE-ით; საშუალო რანგები 6,67; 3,98 და 4,22-ია. ScoringBench-ზე Kumo Tabular-Large და Medium საშუალო რანგით პირველ და მეორე ადგილზე არიან.
შეზღუდვები
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.