Ai2-მა ღია წონების მოდელი AstaBrief 8B გამოუშვა: სამეცნიერო ანგარიშებს 3,5-ჯერ უფრო სწრაფად ამზადებს
Ai2-მა (Allen Institute for AI) ღია წონების მოდელი AstaBrief 8B გამოუშვა: ის კვლევის კითხვიდან და მოძიებული ლიტერატურიდან ციტირებულ ანგარიშს ამზადებს და Fast mode-ში საშუალოდ 51,1 წამში მუშაობს, Thinking mode-ზე 3,5-ჯერ უფრო სწრაფად.
Allen Institute for AI-მ (Ai2) 2 ოქტომბერს ღია წონების მოდელი AstaBrief 8B გამოუშვა. მოდელი კვლევის კითხვისა და მოძიებული ლიტერატურის მონაკვეთებიდან ციტირებულ ანგარიშს ამზადებს და Asta-ში უკვე მუშაობს Fast mode-ის სახით, Thinking mode-ის გვერდით.
სრულ პაიპლაინში Fast mode ერთ ანგარიშს საშუალოდ 51,1 წამში ამზადებს, Thinking mode-ის 178,5 წამის წინააღმდეგ, ანუ დაახლოებით 3,5-ჯერ უფრო სწრაფად. მოდელი ანგარიშს ერთი გავლით წერს და შეჯამებისა და კლასტერიზაციის ეტაპებს გამოტოვებს; Ai2-ის თქმით, ხარისხი არ დაზარალდა.
ღია მოდელი სამეცნიერო ანგარიშებისთვის
AstaBrief 8B რვა მილიარდი პარამეტრის მოდელია Qwen3-8B-ის ბაზაზე. Ai2-ის მკვლევრები ძირითადად post-training მონაცემებსა და შეფასებაზე მუშაობდნენ. ღია წონები ინსტიტუტებს მოდელის საკუთარ ინფრასტრუქტურაზე, ფაირვოლის უკან გაშვების საშუალებას აძლევს, რაც სენსიტიური კვლევისთვის მნიშვნელოვანია.
როგორ გაწვრთნეს მოდელი
AstaBrief ორ ეტაპად გაწვრთნეს: supervised fine-tuning (SFT) და direct preference optimization (DPO). Ai2-მ ძვირი და არასტაბილური RL-მიდგომის ნაცვლად უფრო მარტივი გზა აირჩია. სავარჯიშო კითხვები რეალური მომხმარებლის ლოგებიდან აიღეს: გაფილტვრის შემდეგ 90 ათასი კვლევითი კითხვა დარჩა.
SFT-ისთვის სამიზნე ანგარიშები ScholarQA-ს პაიპლაინმა შექმნა (Claude 3.5 Sonnet, Claude 3.7 Sonnet, o3, o4-mini, GPT-4.1); გაფილტვრის შემდეგ 47 ათასი მაგალითი დარჩა. DPO-სთვის წყვილებს ორი მოსამართლე მოდელი ადარებდა (GPT-4.1 და DeepSeek-R1), საბოლოო ნაკრებში კი 6 ათასამდე მაგალითია. ოთხი სტატისტიკური ფილტრიდან ყველაზე მეტი მოგება დაბალი ციტატების სიმჭიდროვის მქონე მაგალითების მოცილებამ მოიტანა.
შედეგები და გამოყენება
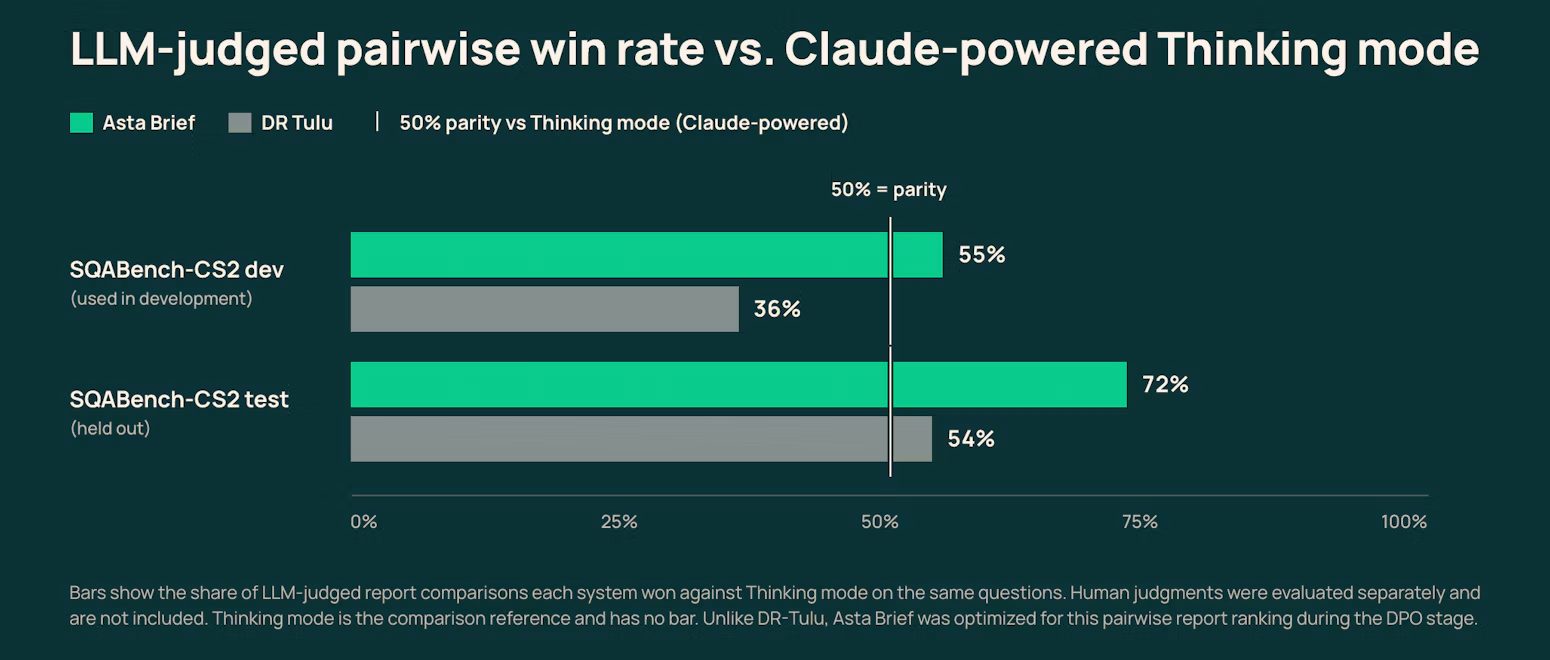
შეფასების მთავარი მიზანი SQABench-CS2 იყო: 200 კითხვა კომპიუტერული მეცნიერებიდან. გაზომეს რუბრიკის ქულა, პასუხის სიზუსტე, ციტატების სიზუსტე და სისრულე; დამატებით შეამოწმეს DeepScholarBench-ზე (63 კითხვა) და ჩაატარეს 14 კითხვის ადამიანური კვლევა.
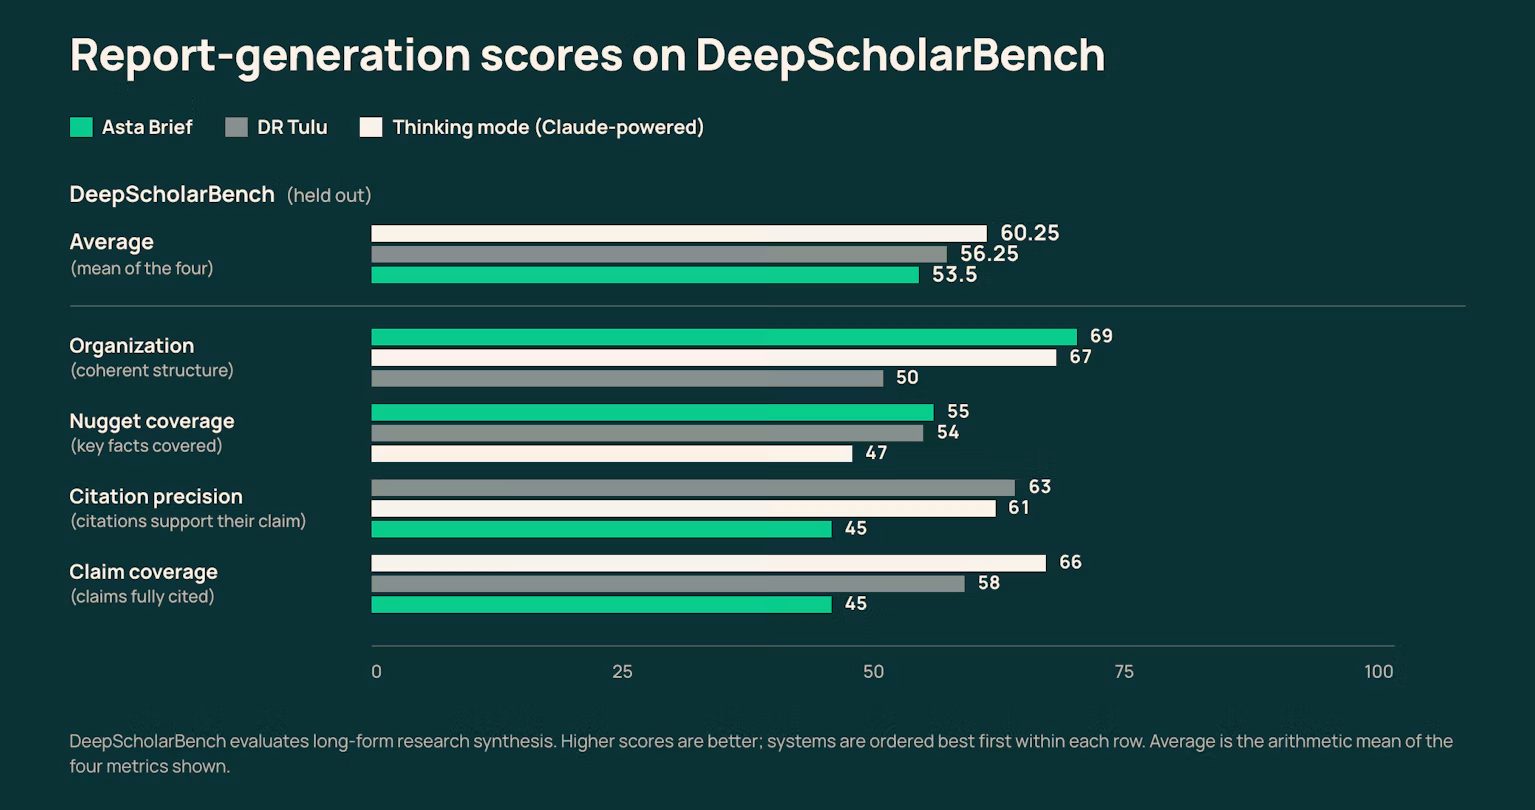
AstaBrief კონკურენტუნარიანია Claude-ზე დაფუძნებულ პაიპლაინთან და DR Tulu-სთან. ადამიანურ კვლევაში საერთო უპირატესობით DR Tulu იმარჯვებს, თუმცა სამი მკვლევრიდან ორმა ციტატების სიზუსტეში AstaBrief-ს მიანიჭა უპირატესობა. Ai2 აღნიშნავს, რომ შეფასება ძირითადად 2025 წელს ჩატარდა და დღევანდელ მოდელებთან არ განმეორებულა.
ადრეული გამოყენება დადებითია: Fast mode 374 მომხმარებელმა გამოსცადა, 29,1% მას ორი ან მეტი დღე იყენებს, საშუალოდ კი 3,67 ანგარიშის თრედს ქმნიან. 23%-მა Fast mode-ზე დარჩენა ამჯობინა, 18% კი რეჟიმებს შორის გადადიოდა და თრედების 40% Fast mode-ში გაატარა. დადებითი გამოხმაურება ორივე რეჟიმში მსგავსია: 84,2% Fast mode-სთვის და 85,2% Thinking mode-სთვის.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.