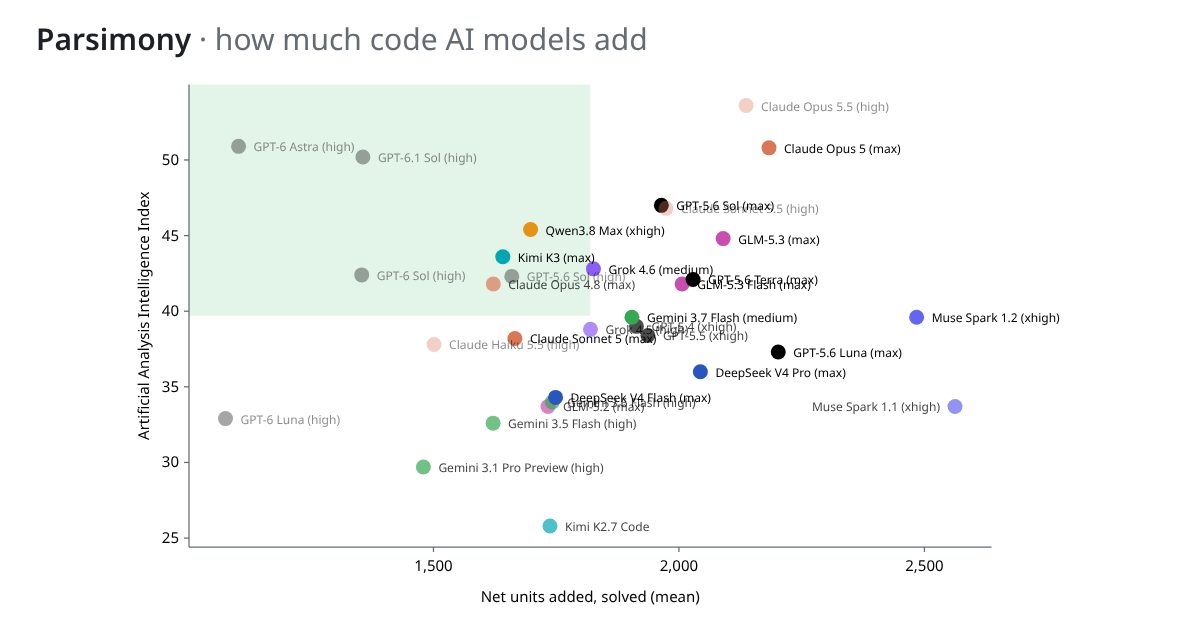
ახალი Parsimony ბენჩმარკი AI კოდინგ აგენტებს დამატებული კოდის მიხედვით აფასებს
Parsimony ბენჩმარკია, რომელიც ზომავს, რამდენ კოდს ამატებენ AI კოდინგ აგენტები ამოცანის გადაჭრისას. ითვლის სინტაქსურ ერთეულებს და არა ხაზებს, აკლებს წაშლილ კოდს და მოდელებს SWE-bench Verified-ზე დამატებული საშუალო წმინდა ერთეულებით ალაგებს.
არსებული AI კოდინგ ბენჩმარკები ზომავენ ამოხსნის პროცენტსა და ხარჯს, მაგრამ ზედმეტ კოდს არ სჯიან, რამაც დროთა განმავლობაში კოდბაზასთან მუშაობა შეიძლება გაართულოს. Parsimony, ახალი ბენჩმარკი, განსხვავებულ მიდგომას იყენებს: ზომავს, რამდენ კოდს ამატებენ AI მოდელები ამოცანის ამოხსნისას.
როგორ მუშაობს Parsimony
Parsimony იღებს იმ პატჩებს, რომლებსაც ბენჩმარკები უკვე აქვეყნებენ, და ითვლის კოდინგ ერთეულებს, ანუ სინტაქსურ ელემენტებს, როგორიცაა ინსტრუქციები, გამოძახებები, შედარებები, სახელები და ლიტერალები. ხაზები არ ითვლება, ამიტომ კოდის ნაკლებ ხაზებში ჩატევა არ წახალისდება. წაშლილი კოდი აკლდება, რაც მარტივ ფორმულას იძლევა: წმინდა ერთეულები უდრის დამატებულს მინუს წაშლილი. თითოეული პატჩი გამოიყენება ამოცანის კოდზე და ყოველი შეცვლილი ფაილის ორივე ვერსია პარსდება; არაფერი არ სრულდება. ტესტები, დოკუმენტაცია და გენერირებული ფაილები გამორიცხულია, და მხოლოდ Python იზომება. წარმატებული და წარუმატებელი შედეგები მოდის SWE-bench-ის გამოქვეყნებული შედეგებიდან, და ტესტები ხელახლა არ ეშვება.
როგორ იკითხება ლიდერბორდი
მოდელები რანჟირდება მათ მიერ ამოხსნილ ამოცანებზე დამატებული საშუალო წმინდა ერთეულებით, ყველაზე დაბლიდან დაწყებული. ფიგურა „Net units added (mean)“ ასევე მოიცავს წარუმატებელ ცდებს. სვეტი „Solved“ მოდის SWE-bench Verified-იდან, ხოლო „Measured“ აჩვენებს, რამდენი ამოხსნილი ცდა შეიძლებოდა გაზომილიყო. Artificial Analysis Intelligence Index ჩანს როგორც გარე ქულა, შედარებული მოდელისა და მსჯელობის ძალისხმევის მიხედვით, მაგრამ რანჟირებაზე გავლენას არ ახდენს. დაბინდული ჩანაწერები დაფაზე ავტორმა გაუშვა პირველ 3-დან 10-მდე DeepSWE Python ამოცანაზე, OpenAI მოდელებისთვის pi-ს და Anthropic მოდელებისთვის Claude Code-ის გამოყენებით, და შეფასდა თითოეული ამოცანის საკუთარი ტესტებით; ისინი არ არიან ვერიფიცირებული ან რანჟირებული. GPT-5.6 Sol ორივე გზით გაეშვა, და ავტორის გაშვებამ გამოქვეყნებული გაშვების კოდის 0,88-ჯერ დაამატა.
შეზღუდვები და გაფრთხილებები
პროექტი აღნიშნავს, რომ უფრო პატარა ყოველთვის უკეთესი არ არის: ერთეულები ზომავენ ზომას და არა წაკითხვადობას ან დიზაინს. მოდელები, რომლებიც მეტ კოდს წერენ, ჩვეულებრივ უფრო მეტ ამოცანასაც ხსნიან, Spearman-ის კორელაციებით 0,33-დან 0,60-მდე დაფებზე, სადაც 26 ან მეტი მოდელია. ყოველი მოდელი იყენებს ერთსა და იმავე აგენტს, mini-SWE-agent-ს, მაგრამ აგენტი მაინც ახდენს გავლენას იმაზე, თუ რამდენი კოდი იწერება.
საკუთარი ბენჩმარკის დამატება
მკითხველს, რომელსაც სხვა ბენჩმარკიდან კოდის ზომის ციფრები აქვს, შეუძლია ჩამოტვირთოს მაგალითი JSON ფაილი, შეავსოს თავისი შედეგები და გახსნას ის, რომ მიიღოს იგივე დიაგრამა და ცხრილი. ფაილი ბრაუზერში რჩება.
წყაროები: parsimony.lasu.dev
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.