NVIDIA-მ და IIT Madras-მა 22 ინდური ენისთვის 2,8 ტრილიონი ტოკენის წინასწარი გაწვრთნის კორპუსი გამოუშვეს
NVIDIA-მ, IIT Madras-მა და AI4Bharat-მა გამოაქვეყნეს Nemotron-pretraining-Indic-v1: დაახლოებით 2,8 ტრილიონი ტოკენის კორპუსი 22 ინდურ ენაზე და მის შესაქმნელად გამოყენებული ღია, GPU-აჩქარებული პაიპლაინი.
კორპუსი 22 ინდური ენისთვის
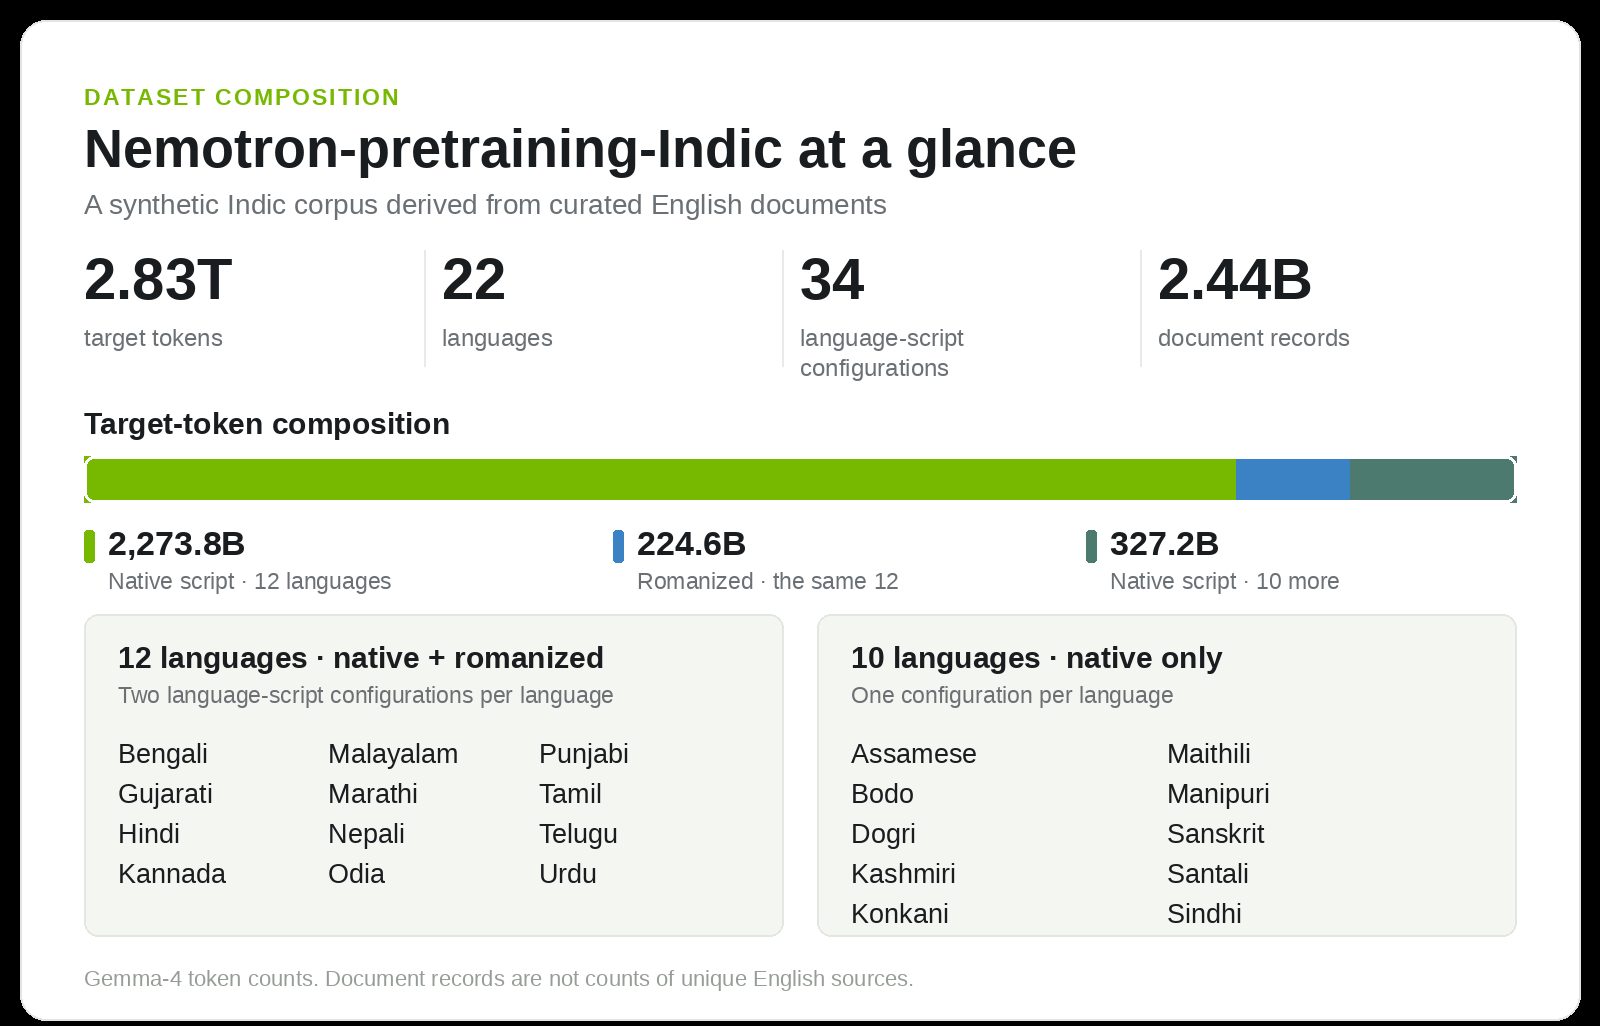
NVIDIA-მ IIT Madras-თან და მის AI4Bharat-ის ლაბორატორიასთან ერთად წარმოადგინა Nemotron-pretraining-Indic-v1, წინასწარი გაწვრთნის კორპუსი, რომელიც დაახლოებით 2,8 ტრილიონ ტოკენს მოიცავს ინდოეთის კონსტიტუციაში ჩამოთვლილ 22 ენაზე. გამოშვება ასევე მოიცავს ღია, GPU-აჩქარებულ მონაცემთა გენერაციის პაიპლაინს, რომელიც მის შესაქმნელად გამოიყენეს და რომელიც მოიცავს თარგმნას, ხარისხის შეფასებასა და გამოსწორებას.
კორპუსი შეიცავს 2 601,0 მილიარდ ტოკენს მშობლიურ დამწერლობაში და 224,6 მილიარდ რომანიზებულ ტოკენს, დათვლილს Gemma-4 ტოკენაიზერით. ის მოიცავს 34 ენა-დამწერლობის კონფიგურაციას: მშობლიური დამწერლობის მონაცემები ყველა 22 ენისთვის და რომანიზებული ტექსტი მათგან თორმეტისთვის. ყოველი ჩანაწერი უკავშირდება კურირებულ წყარო დოკუმენტს და თითოეული გამოსავალი შემოწმდება მის შეყვანასთან, რათა სინთეზური ტექსტი რეალურ ინფორმაციას დაეყრდნოს.
ინგლისური წყაროებიდან ინდურ სასწავლო მონაცემებამდე
პაიპლაინი იწყება 15 Nemotron-CC-v2 ქვეჯგუფის დოკუმენტებიდან, რომლებიც მოიცავს ვებ ტექსტს, კითხვა-პასუხის მასალას, მათემატიკას, კოდსა და სხვა სპეციალიზებულ კონტენტს. NVIDIA-ს ღია კოდის NeMo Data Designer ჩარჩო ასრულებს თარგმნას, ხარისხის შემოწმებებსა და მიზანმიმართულ გამოსწორებას, ინარჩუნებს წყაროს იდენტიფიკატორებს, რათა გამოსავლები მათ თავდაპირველ დოკუმენტებამდე მიკვლევადი იყოს.
თორმეტი ენისთვის დოკუმენტები სრულად ითარგმნება Gemma-4-31B-it-ის გამოყენებით, რომელიც მოდელების სრულ დოკუმენტებზე შედარების შემდეგ შეირჩა. Multidimensional Quality Metrics-ით შთაგონებული რუბრიკა მოიცავს მნიშვნელობას, გამართულობას, ტერმინოლოგიას, სტილსა და ფორმატირებას, და მხოლოდ ის გამოსავლები ინარჩუნება, რომლებიც 100-დან მინიმუმ 75 ქულას აგროვებს. დაბალი ქულის მქონე გამოსავლები შეფასების უკუკავშირის გამოყენებით გამოსწორდება და ხელახლა შეფასდება, რამაც 438,4 მილიარდი ტოკენი დაიბრუნა. მიღებული მშობლიური დამწერლობის თარგმანები ასევე გარდაიქმნება ლათინურ დამწერლობაში რომანიზებული ნაწილისთვის.
დანარჩენი ათი ენა იყენებს ცალკე სამუშაო პროცესს, რომელიც Indic Translate-ზეა აგებული, Bodhan AI-ის დოკუმენტის დონის თარგმნის მოდელზე. უფრო გრძელი Santali-ს დოკუმენტებისთვის გადაფარებული ფანჯრები ითარგმნება და რეკონსტრუირდება; Manipuri-სთვის ტექსტი ბენგალურ დამწერლობაში ითარგმნება, შემდეგ კი Meitei Mayek-ზე გარდაიქმნება.
გავლენა Nemotron მოდელებზე
Nemotron 3.5 Super VL-ის გაგრძელებულმა წინასწარმა გაწვრთნამ დაამატა 10 მილიარდი ინდური ტოკენი, აღებული კორპუსის თორმეტენოვანი ქვეჯგუფიდან და ბუნებრივი ინდური ტექსტიდან. ქულები გაიზარდა ხუთივე მოხსენებულ ინდური ცოდნისა და მსჯელობის ბენჩმარკზე, ზრდა 4,98-დან 9,82 პროცენტულ პუნქტამდე მერყეობს. გამოშვებული მოდელი ასევე უფრო მაღალ ქულას აგროვებს Nemotron 3 Super-თან შედარებით ექვსი ინდური დავალების ბენჩმარკიდან ხუთზე და უმჯობესდება IndiVibe-ის ოთხივე განზომილებაში, თუმცა IFEval 1.5-ზე ინსტრუქციის დაცვა 2,04 პუნქტით დაეცა.
გუნდი გეგმავს ამ კორპუსზე დაშენებას მომავალ Nemotron მოდელებში და რეკომენდაციას იძლევა მისი ბუნებრივად დაწერილ ინდურ ტექსტთან შერწყმას ადგილობრივი ცოდნისა და კულტურული კონტექსტისთვის.
წყაროები: Hugging Face Blog
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.