NVIDIA TensorRT-ის მრავალმოწყობილობიან ინფერენსს Dynamo-Triton-ში აერთიანებს
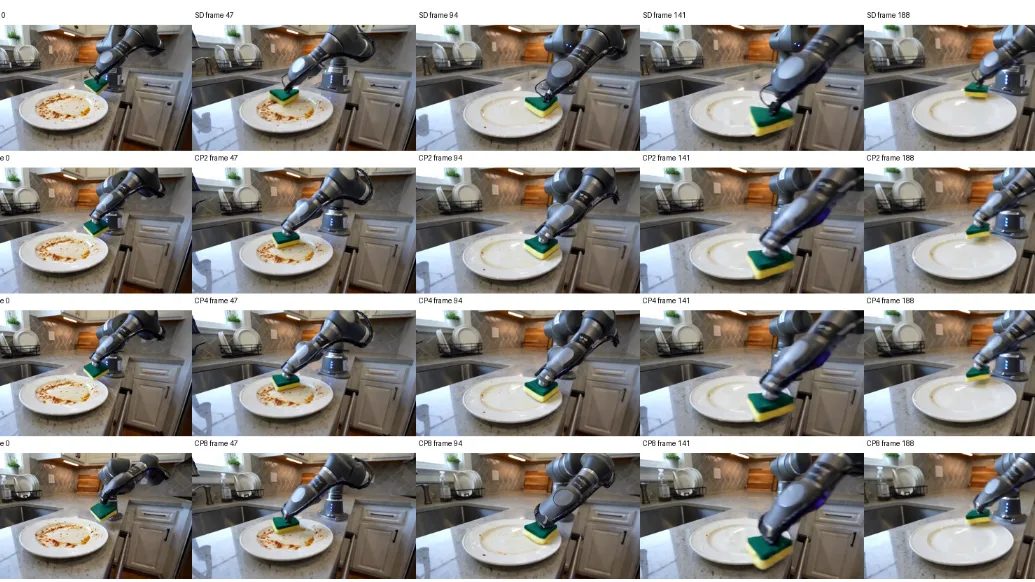
NVIDIA-მ TensorRT-ის მრავალმოწყობილობიანი ინფერენსი Dynamo-Triton 26.07-ში ჩართო — ერთი მოდელის ინსტანსი რამდენიმე GPU-ს ფლობს და Cosmos 3 Nano-ს ვიდეოგენერაცია რვა GPU-ზე 156.6-დან 34.2 წამამდე შემცირდა.
NVIDIA-მ TensorRT-ის მრავალმოწყობილობიანი ინფერენსის შესაძლებლობა Dynamo-Triton-ში ჩართო, რის შემდეგაც აპლიკაციას GPU-რანკების კოორდინაცია აღარ სჭირდება.
რა შეიცვალა
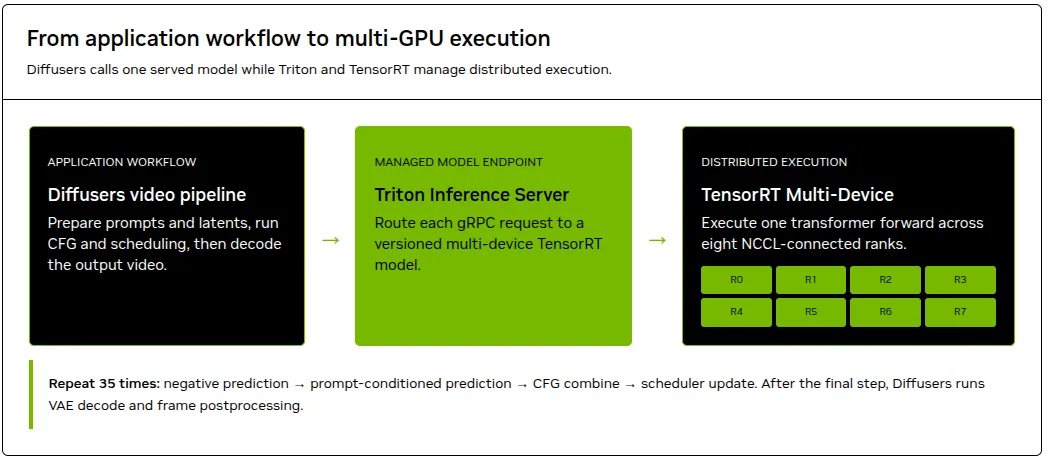
TensorRT-ის მრავალმოწყობილობიანი ინფერენსი ერთ TensorRT ქსელს რამდენიმე GPU-ზე შესრულების საშუალებას აძლევს — NCCL-ზე დაფუძნებული განაწილებული კოლექტიური ოპერაციებით და TensorRT-ის ოპტიმიზაციების შენარჩუნებით. Dynamo-Triton (ყოფილი Triton Inference Server) ამ შესაძლებლობას 26.07 გამოშვებაში რთავს, ხოლო ერთ Triton KIND_MODEL ინსტანსს რამდენიმე GPU-ის ფლობა შეუძლია: ქმნის თითოეული რანკისთვის შესრულების კონტექსტს, CUDA-ს ნაკადებს და NCCL-ის კომუნიკატორებს, შემდეგ კი ყოველ მოთხოვნაზე რანკებს ერთი gRPC გამოძახებით ერთად უშვებს.
როგორ მუშაობს სერვინგის ჯაჭვი
ინტეგრაცია Cosmos 3 Nano ვიდეოგენერაციის მოდელზე აჩვენეს, სადაც Diffusers მიმდებარე ჯაჭვს მართავს, Dynamo-Triton კი 36-შრიან დენოიზინგის ტრანსფორმერს ემსახურება. TensorRT-ის მრავალმოწყობილობიანი ინფერენსი Ulysses-ის კონტექსტური პარალელიზმით 44 160 ვიდეო-ტოკენს რვა GPU-მდე ანაწილებს.
განაწილებული გრაფი განთავსებამდე თითოეულ TensorRT გეგმაში კომპილირდება, ამიტომ Triton-ის კონფიგურაცია კონტექსტურ-პარალელურ გეგმას ააქტიურებს და არა ერთმოწყობილობიან ძრავს გარდაქმნის. ერთ GPU-ზე გენერაციის დროის 93.4% ტრანსფორმერზე მოდის, და ვინაიდან 35 დენოიზინგის საფეხურიდან თითოეულს classifier-free guidance-ისთვის ორი პროგნოზი სჭირდება, Diffusers-ის პროქსი გენერაციაზე 70 ტრანსფორმერის RPC-ს აკეთებს.
შედეგები ლატენტურობაში
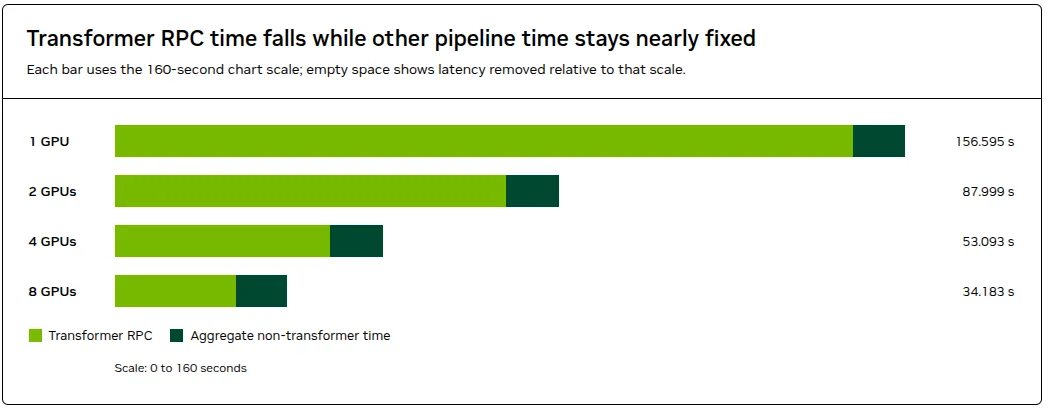
ოთხივე ვარიანტი ერთსა და იმავე რვა-GPU სისტემაზე გაეშვა: 1280x720, 189 კადრი 24 FPS-ზე და ხუთი გაზომილი გენერაცია. სრული ლატენტურობა ერთ GPU-ზე 156.595 წამიდან ორზე 87.999, ოთხზე 53.093 და რვაზე 34.183 წამამდე დაეცა — 78.17%-იანი შემცირება. ტრანსფორმერის RPC-ის დრო 83.59%-ით შემცირდა, მისი წილი ჯამში 93.4%-დან 70.2%-მდე, ხოლო RPC-ის ბილიკის მიღმა დარჩენილი დრო ყველა კონფიგურაციაზე 10.2–10.5 წამის ფარგლებში იყო.
ვალიდაციისას თითოეული კონტექსტურ-პარალელური შედეგი იმავე seed-ზე ერთმოწყობილობიან ვარიანტს შეადარეს: CP2-მა და CP4-მა MAE 12.759 და PSNR 21.111 dB აჩვენა, CP8-მა — MAE 16.316 და PSNR 19.400 dB; ყველა დაშვებულ ზღვარშია. NVIDIA არ აცხადებს, რომ შედეგები პიქსელების დონეზე იდენტურია.
კომპრომისები
გუნდებს მაინც უწევთ არჩევანი: მეტი GPU რესურსი უფრო მოკლე ლატენტურობის სანაცვლოდ. ბენჩმარკი არ ზომავს ერთდროული მოთხოვნების გამტარუნარიანობას, ერთი ვიდეოს ღირებულებას ან საერთო ჯამურ ღირებულებას — ეს მეტრიკები საკუთარ SLO-ებთან უნდა შევადაროთ. Dynamo-Triton 26.07 NGC-დან ჩამოსატვირთია.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.