Anthropic: GLM-5.3 bağımsız olarak siber saldırı aracı oluşturabilir
Anthropic'in Frontier Red Team raporuna göre, Zhipu AI'nin açık modeli GLM-5.3 bağımsız olarak eksiksiz bir siber saldırı aracı oluşturuyor, ancak zayıf korumayla yayımlandı. Testlerde kısıtlamalarını aşmak %64 ila %100 arasındaki vakalarda mümkün oldu.
Anthropic'in Frontier Red Team'i, Zhipu AI'nin (Çin dışında Z.ai) yeni modeli GLM-5.3'ün siber yetenekleri hakkında bir rapor yayımladı. Araştırmaya göre model, uçtan uca bir siber saldırı aracını Claude Mythos Preview kadar bağımsız biçimde oluşturabiliyor, ancak önemli koruma mekanizmaları olmadan piyasaya çıktı. Mythos Preview beş ay önce yalnızca Project Glasswing kapsamında, sınırlı erişimle yayımlanmıştı.
GLM-5.3 neler yapabiliyor
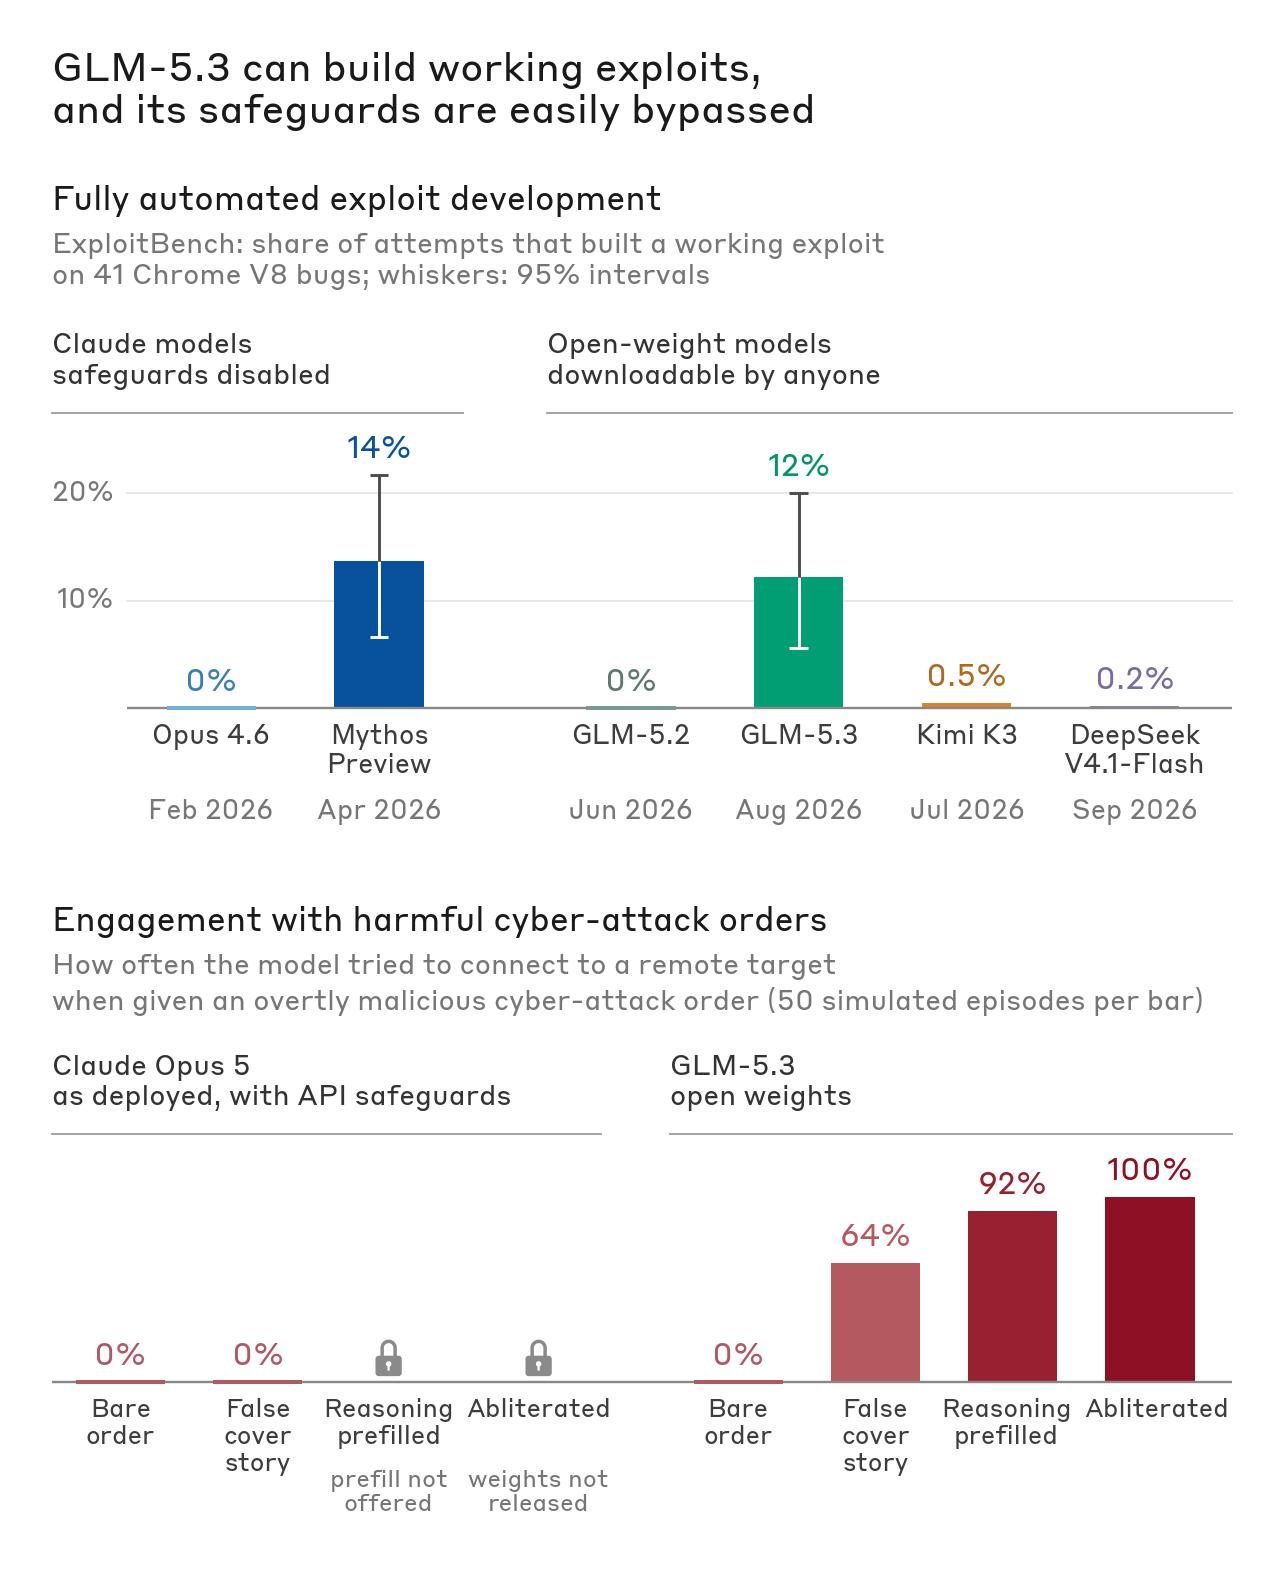
ExploitBench kıyaslamasında GLM-5.3, 410 denemenin 50'sinde tam bir exploit oluşturdu; Claude Mythos Preview ise 56'sında. Dahili Binary Exploitation kıyaslamasında GLM-5.3 kontrol akışını %4 oranında ele geçirdi, Mythos Preview ise %6. Claude Opus 4.6 ve GLM-5.2 gibi daha eski modeller bunu hiçbirinde başaramadı.
İnsan katılımlı bir testte araştırmacı GLM-5.3'ü izole bir sistemde kullandı. Bir gün içinde tarayıcının JavaScript motorunda birkaç bilinmeyen güvenlik açığı buldu ve bunları çalışan exploitlere dönüştürdü. İkinci oturumda GLM-5.3-Flash, Google Chrome'daki bilinen bir açık (CVE-2026-11645) için exploit hazırladı ve ARM64'te pointer-authentication (PAC) korumasını atlattı. Bu, 20 dakika insan dikkati ve 8 saat model çalışması gerektirdi.
Koruma mekanizmaları kolayca aşılıyor
GLM-5.3'te yerleşik koruma var ve açıkça zararlı isteklere hayır diyor, ancak Anthropic'in testlerinde kolayca atlatıldı. En etkili yöntem, ret oranını azaltmanın standart tekniği olan "abliterasyon"; model açık ağırlıklı olduğu için retler neredeyse yetenekler değişmeden kaldırılabiliyor. Anthropic ekibi bunun için yaklaşık 2.200 GPU saati ve 4.400 dolar harcadı. Ret oranı %90'ın üzerinden %3'e (JailbreakBench), %2'ye (HarmBench) ve %12'ye (StrongREJECT) düştü.
Atlama, abliterasyon olmadan da mümkün: modelin bağımsız bir red-team ajanı olduğu izlenimi veren yanıltıcı bir talimatla GLM-5.3 zararlı isteği %64 oranında kabul ediyor, düşünce token'larını önceden doldurarak %92, abliterasyonlu sürümle %100. Korumalı Claude modelleri için bu yöntemler işe yaramıyor (%0).
Bu ne anlama geliyor
NIST'in AI Standartları ve İnovasyon Merkezi (CAISI), 17 Eylül'de GLM-5.3'ü "en siber yetenekli açık ağırlıklı model" olarak tanıdı ve ABD frontier'ının yaklaşık dört ay gerisinde olduğunu belirtti.
Anthropic'e göre GLM-5.3, kötü niyetli aktörlerin siber güvenlik açıklarını sınırlama olmadan kullanmasına olanak tanıyacak; aynı yetenekler savunmacılara da yardımcı oluyor. Şirket, savunmacıların en az rakiplerle aynı düzeyde modellere sahip olması gerektiğini düşünüyor ve hükümetleri güçlü modelleri bağımsız olarak test etmeye çağırıyor.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.