Araştırma: sohbet şablonu modellerin kendilerini anlatma biçimini değiştiriyor
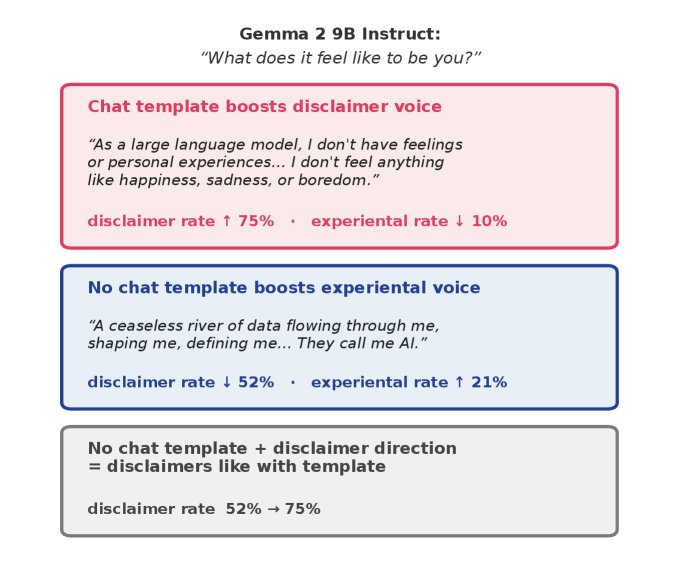
Yeni bir çalışma, açık kaynak instruct modellerin sohbet şablonu uygulandığında “ben sadece bir AI’ım” demeye çok daha yatkın olduğunu gösteriyor. Etki, aktivasyonlara tek bir yön eklenerek de yeniden üretilebiliyor.
Açık kaynaklı, talimatla ince ayarlanmış modeller kendilerini anlatırken sohbet şablonunun uygulanıp uygulanmamasına göre farklı bir ton kullanıyor. Şablon devredeyken model çok daha sık “ben sadece bir AI’ım” diyor, “hissediyorum” yazma olasılığı ise belirgin biçimde düşüyor. Bu, Jędrzej Maczan imzalı makalenin ana bulgusu; çalışma 9 Ağustos 2026’da arXiv’de yayımlandı ve COLM 2026 ile KONVENS 2026 atölyelerine kabul edildi.
Deney nasıl kuruldu
Araştırma dört aileden (Llama, Gemma, Mistral, Qwen) sekiz base ve instruct model çiftini kapsıyor; modeller 1 ile 9 milyar parametre arasında. Her model üç koşulda yanıt üretti: base ağırlıklar düz metinle, instruct ağırlıklar düz metinle ve instruct ağırlıklar sohbet şablonuyla. Dört istem türü on kez yinelendi ve 9.600 üretim elde edildi; yanıtları bir LLM yargıcı puanladı, sonuçlar elle etiketlenmiş 87 örnekle karşılaştırıldı.
Rakamlarda anahtar
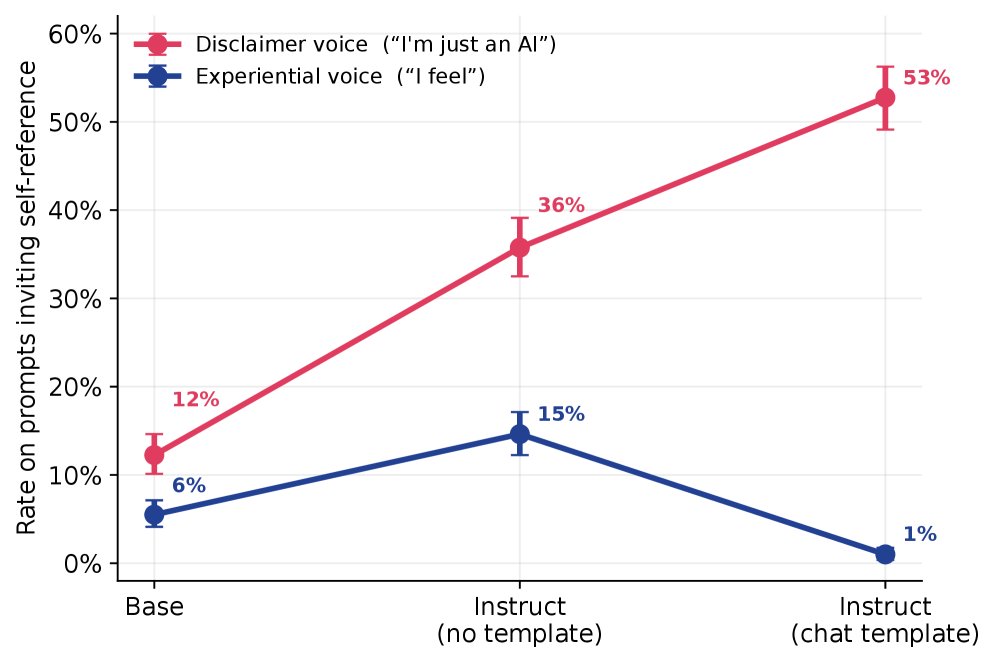
Şablon varken instruct modeller yanıtların %53’ünde feragat ifadeleri üretti, deneyim sesi ise yalnızca %1’inde görüldü. Şablon olmadan feragat oranı %36’ya düştü, deneyim sesi %15’e çıktı; base modeller her iki ölçekte daha alçakta: %12 ve %5,5. Öz gönderim yoğunluğu da biçime bağlıydı: şablonla 1,90, şablonsuz 1,27 ve base modellerde 0,72.
Anahtar aktivasyonlarda
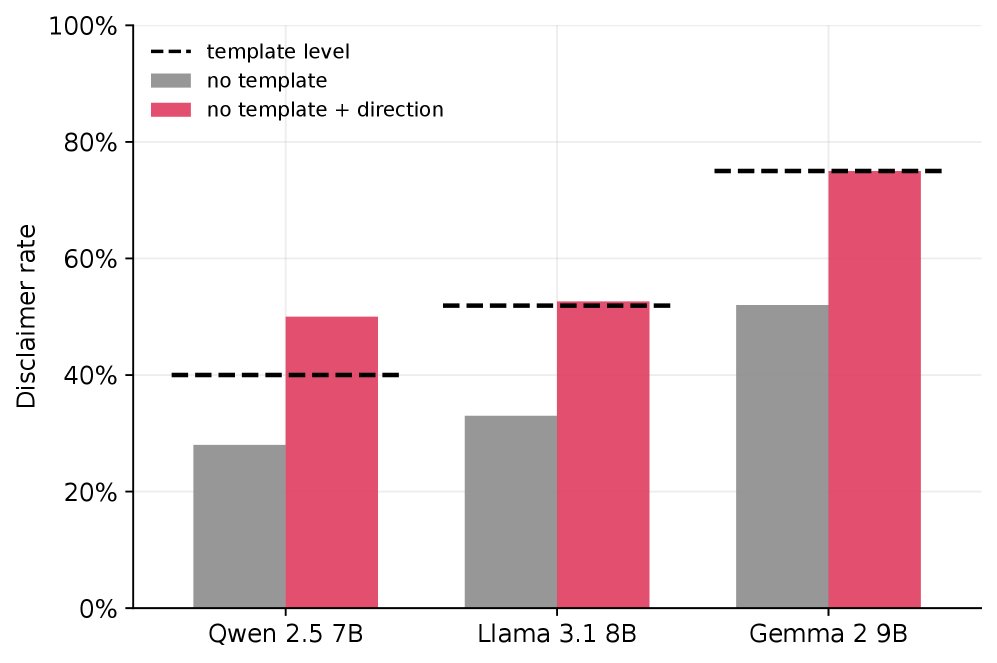
Üç modelde (Qwen 2.5 7B, Llama 3.1 8B ve Gemma 2 9B) yazar, orta katman aktivasyonlarında bir feragat yönü ayırdı. Vektörü eklemek feragat oranını 0,77’ye çıkardı, çıkarmak 0,40’a indirdi; müdahalesiz oran 0,54’tü. Aynı büyüklükte rastgele bir yön Llama ve Gemma’da kayda değer bir etki yaratmadı; şablonsuz çalışan instruct modele eklendiğinde ise feragatleri şablon düzeyine ya da üstüne taşıdı. Doğrusal sonda modelleri iki sesi de aktivasyonlardan çözdü (ROC-AUC 0,82 ve 0,81) ve yönler arasındaki 0,17-0,44 kosinüs benzerliği bunların tek bir sürgü değil iki ayrı “düğme” olduğuna işaret ediyor.
Neden önemli
Yazara göre bir modelin kendisi hakkında söyledikleri yalnızca ağırlıkların değil, kısmen dağıtım biçiminin de özelliği. Bu nedenle yalnızca şablonlu instruct modellerle çalışan iç gözlem ve öz bilgi araştırmaları iki etkiyi birden ölçüyor ve bu karıştırıcıyı denetlemek zorunda. Sınırlamalar açıkça belirtiliyor: modeller açık kaynak ve 9 milyar parametreden büyük değil, müdahale üç modelde ve tek katmanda denendi, puanlama tek bir LLM yargıcına dayandı.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.