NVIDIA, biyolojik temel modeller için verimli MoE eğitim yolunu gösterdi
NVIDIA'nın geliştirici blogunda yayımlanan eğitimde, Transformer Engine ile BioNeMo tarifinin seyrek MoE modellerinin eğitimini nasıl hızlandırdığı anlatılıyor: sekiz B200 GPU'da temel sürüme göre 2,21 kat verim.
NVIDIA'nın geliştirici blogu, biyolojik temel modellerin uzman karışımı (MoE) mimarisiyle daha verimli eğitilmesini anlatan bir teknik eğitim yayımladı. Yazının imzası Faradawn Yang, Peter St John, Kyle Tretina ve Zoey Zhang'a ait.
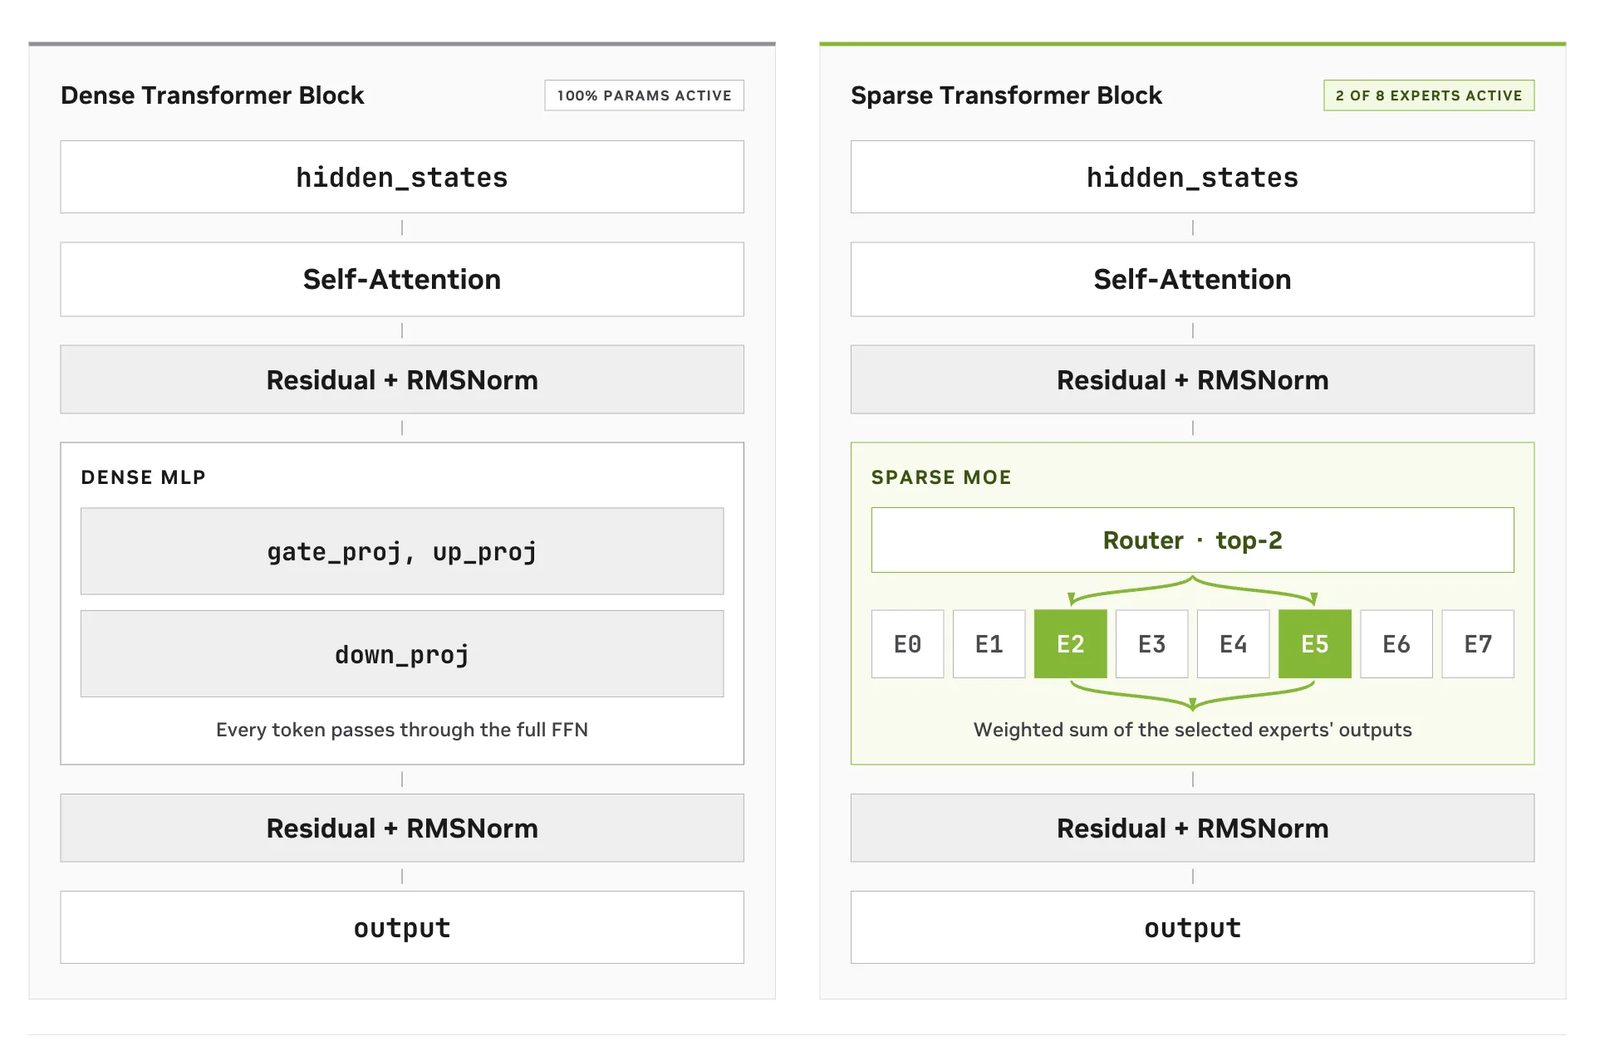
Yoğun transformatörler her token'ı bütün katmanlardan geçirir; ek kapasite hem eğitimde hem çıkarımda pahalıdır. MoE mimarileri feed-forward bloğunu çok sayıda uzmana böler ve her token için bunların yalnızca birkaçını etkinleştirir. Sonuç uygulamaya bağlıdır: parçalanmış uzman hesapları GPU kullanımını düşürür, yönlendirme iletişim yükü ekler, büyüyen parametre sayısı ise belleği zorlar.
Python döngüsü yerine gruplanmış uzmanlar
İlk sorun çekirdek parçalanmasıdır. Hugging Face referans uygulamasında uzmanlar bir Python döngüsünde sırayla çalışır ve her biri ayrı çekirdek başlatır. TE'nin GroupedLinear katmanı uzman ağırlıklarını ve token'ları toplayıp tüm doğrusal dönüşümleri tek bir gruplanmış GEMM çağrısında uygular; uzman başına token sayısını split_sizes argümanıyla alır. NVIDIA yığını bu projeksiyonu MXFP8 nicemleme ile birlikte tek bir GroupedMLP çekirdeğinde birleştirebiliyor.
Bellek ve nicemleme yükünü azaltmak
MoE modelleri daha fazla parametre taşır, genomik iş yükleri ise sık sık uzun diziler kullanır ve bu da aktivasyon belleğini zorlar. BF16 her değeri 16 bitte saklar; FP8 ve MXFP8 ise 8 bit kullanır. MXFP8, sayısal aralığı korumak için ardışık 32 değerlik her bloğa bir ölçek katsayısı atar; Blackwell GPU'larda bu GEMM'ler özel Tensor Core komutlarıyla çalışır.
Düşük hassasiyetli eğitim ana ağırlıkları yine 16 bitte tutar, dolayısıyla nicemleme ve geri nicemleme ek iş yükü doğurur. GroupedLinear, ScaledSwiGLU ve GroupedLinear işlemlerini TE'nin Sequential API'siyle zincirlemek, kalıbı tek bir birleşik işlemle değiştirmeye izin verir: ileri geçiş için ForwardGroupedMLP_CuTeGEMMSwiGLU_MXFP8.
Sekiz B200 GPU'da 2,21 kat verim
Mixtral-8x7B modeliyle sekiz NVIDIA B200 Tensor Core GPU üzerinde yapılan testte tarif, Hugging Face referansına kıyasla 2,21 kata kadar verim sağladı. Birleşik MXFP8 GroupedMLP çekirdekleri Blackwell donanımı gerektirir; uzman paralelliği için en az iki GPU şart.
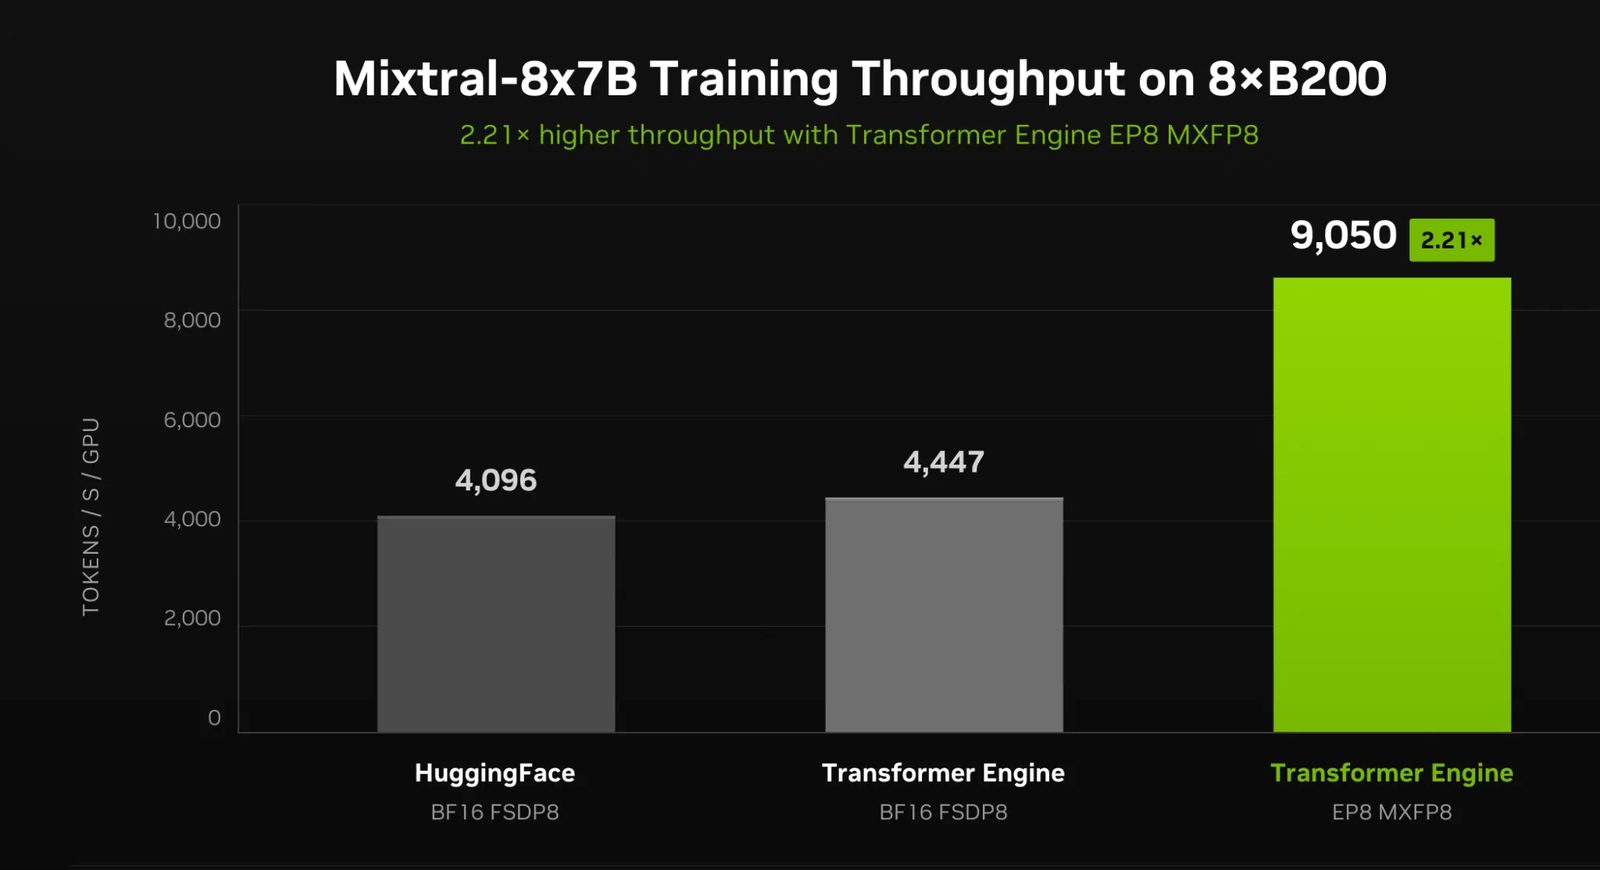
Eğitimde çalıştırma komutları da var: ortamı doğrulamak için iki GPU'lu L0_sanity, ardından sekiz GPU'da uzman paralelliği (EP=8) ve MXFP8 hassasiyetiyle L1_8x7B_ep.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.