Fireworks AI, %40 daha az tokenle düşünen Ember-1'i yayınladı
Fireworks Research, Kimi K3 temelinde geliştirdiği özel model Ember-1'i duyurdu. Şirkete göre model, temel modelin yanıt kalitesini korurken yaklaşık %40 daha az token harcıyor.
Fireworks AI, Fireworks Research ekibinin Kimi K3 üzerine kurduğu özel model Ember-1'i yayınladı. Şirketin 23 Eylül 2026 tarihli duyurusuna göre Ember-1, Kimi K3'ün yanıt kalitesini %40 daha az token kullanarak sunuyor: model, nihai yanıtı etkilemeyen akıl yürütmeyi atlamayı öğrendi.
Akıl yürütme modelleri neden pahalanıyor
Şirkete göre Kimi K3 gibi akıl yürütme modelleri ürettikleri tokenlerin büyük bölümünü, bazen %90'dan fazlasını, yanıtın kendisi yerine iç muhakemeye harcıyor. Çok adımlı ajan iş yüklerinde durum daha da kötüleşiyor: her adım önceki akıl yürütmeyi bağlama geri koyuyor, dolayısıyla bağlam adım sayısıyla yaklaşık olarak karesel biçimde büyüyor. Kimi K3'ün akıl yürütme düzeyini düşürmek sorunu çözmedi, çünkü düşük ayarlar kaliteden fazla ödün veriyordu. Bu yüzden modelin daha verimli düşünmeyi öğrenmesi gerekti: ekip 50'den fazla eğitim deneyi ve 200'den fazla değerlendirme yaptı, doğruluğu kaybetmeden akıl yürütmeyi kısaltan yeni algoritmalar geliştirdi.
Kıyaslamalar ve Pareto sınırı
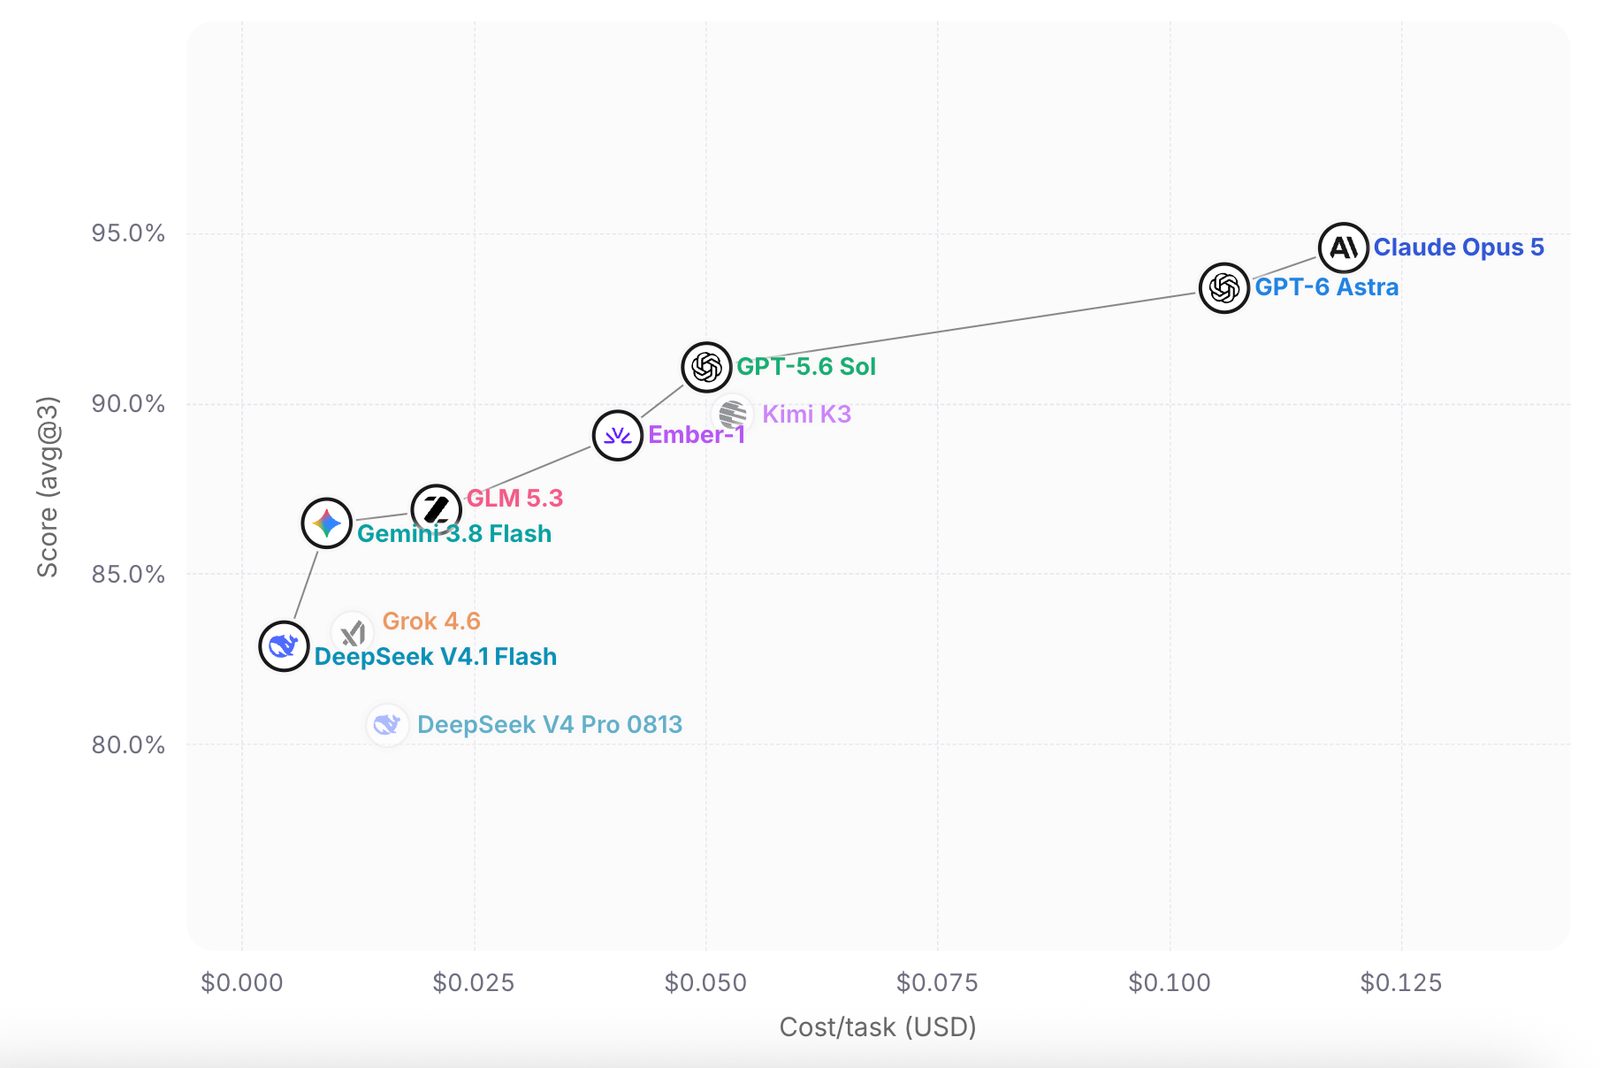
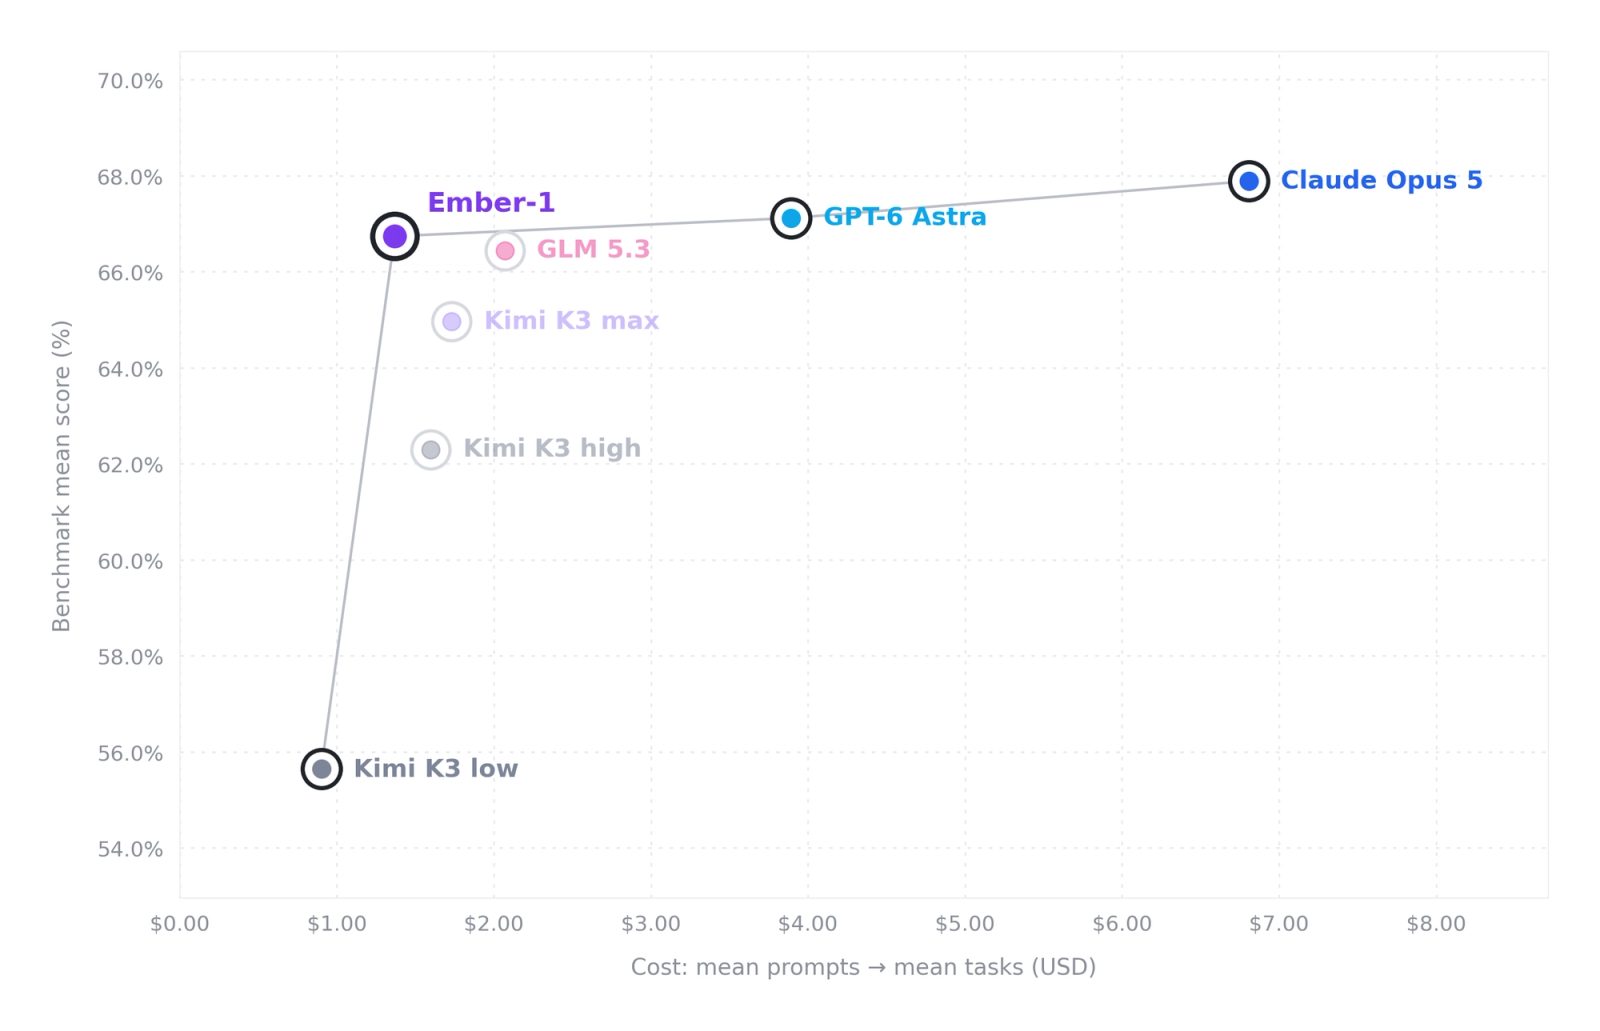
Fireworks, yedi kıyaslama ile iki müşterinin üretim trafiğinde Kimi K3'ün akıl yürütmesinin doğruluk kaybı olmadan %35-50 kısaltılabildiğini buldu. Doximity'nin 10 kategoride 500 klinik vakayı kapsayan ve hekimlerce doğrulanan Bedside Bench testinde Ember-1, GPT-5.6 Sol, GPT-6 Astra ve Claude Opus 5 dahil açık ve kapalı modeller arasında görev başına maliyette yeni bir Pareto sınırı oluşturdu.
Tek tek kıyaslamalarda sonuçlar birbirine yakın. Terminal Bench 2.1: %82,0'a karşı %80,9. DeepSWE 1.1: %75,2'ye karşı %66,4. SWE-bench Verified: %92,2'ye karşı %93,2. SWE-Interact: %20,0'a karşı %21,3. Fireworks'a göre Ember-1, düşük akıl yürütme ayarında da Kimi K3'ü geçiyor.
A/B testleri, iç kullanım ve sıradaki adımlar
İki müşteri, üretimdeki kodlama iş yüklerinde canlı A/B testleri yürüttü ve benzer kalitede görev başına yaklaşık %35 daha az token gördü. Bir testte görevin ortalama puanı 0,751'den 0,753'e çıkarken çıktı tokenleri 49,3 binden 29,9 bine düştü: akıl yürütme tokenlerinde %71,3, toplamda %39 azalma. Tamamlama ve hata oranları korundu ya da iyileşti; bir müşteri Ember-1'i üretimde çalıştırmaya başladı ve temel modeli tamamen değiştirmeyi planlıyor.
Fireworks ayrıca modeli müşterilere göstermeden önce kendi geliştiricilerini Ember-1'e geçirdi ve sonucu "haber yok" diye tanımlıyor: mühendisler değişikliği fark etmedi. Model, temel Kimi K3'ün yanında Serverless üzerinde araştırma önizlemesi olarak sunuluyor. Kendi verisiyle token açısından verimli, özelleştirilmiş model kurmak isteyen kurumlar için eğitim desteği de başlıyor.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.