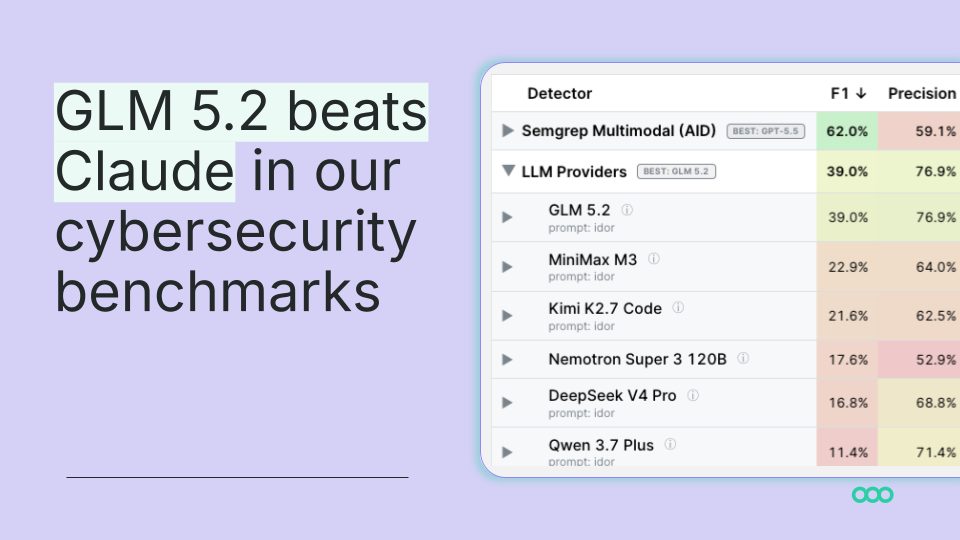
GLM 5.2, Semgrep'in güvenlik testinde Claude Code'u geçti
Semgrep'in yeni IDOR tespit testinde Zhipu AI'nın açık ağırlıklı modeli GLM 5.2 yüzde 39 F1 skoru alarak Claude Code'un yüzde 32'sini geçti; ancak şirketin kendi multimodal hattının gerisinde kaldı.
Semgrep'in güvenlik araştırma ekibi 22 Haziran'da, açık ağırlıklı dil modellerini önde gelen kodlama ajanlarıyla IDOR tespitinde karşılaştıran bir test yayımladı. Açık ağırlıklı bir model açık ara öne çıktı: Zhipu AI'ın (Z.ai) GLM 5.2 modeli yüzde 39 F1 skoru alırken Claude Code yüzde 32'de kaldı; bulunan her zafiyet başına maliyet ise yaklaşık 0,17 dolardı.
IDOR testi neyi ölçüyor
IDOR (Insecure Direct Object Reference), bir erişim kontrolü kusurudur: uygulama, istekte kullanıcı kimliği gibi bir iç tanımlayıcıyı, isteği yapanın o nesneye erişim hakkını denetlemeden açığa çıkarır. Tanımlayıcıyı değiştirdiğinizde başkasının verisine ulaşırsınız. Semgrep'e göre bu bir taint-flow hatası değil: işaretlenecek tehlikeli bir fonksiyon yok, yalnızca eksik bir kontrol var; bu da görevi statik analiz ve dil modelleri için zorlaştırıyor. Sahada en sık rastlanan bulgulardan biri; HackerOne'ın zafiyet türleri listesinde dördüncü sırada.
Sonuçlar
Deneyde veri kümesi, değerlendirme yöntemi ve istem metni sabit tutuldu; yalnızca model ve harness değiştirildi. Semgrep'in multimodal hattı ilk iki sırayı aldı: GPT 5.5 yüzde 61 F1, Opus 4.8 yüzde 53. Ardından, otomatik uç nokta keşfi olmayan yalın bir Pydantic AI harness'ında çalışan GLM 5.2 yüzde 39 ile geldi. Ardından Claude Code (Opus 4.6) yüzde 37 ve (Opus 4.8/4.7) yüzde 28, MiniMax M3 yüzde 23, Kimi K2.7 Code yüzde 22, Codex içindeki GPT-5.5 yüzde 20, Nemotron Super 3 120B yüzde 18 ve DeepSeek V4 yüzde 17 sıralandı.
GLM 5.2 ile sonraki açık ağırlıklı model arasındaki fark 16 puan; bu, Claude Code ile arasındaki farktan büyük. Yazarlara göre çıkarım, açık ağırlıkların genel olarak yetiştiği değil, tek bir açık ağırlıklı modelin bu görevde ve bu koşullarda bunu başardığı yönünde.
GLM 5.2 nedir
GLM 5.2 bir uzman karışımı (MoE) modeli: toplamda yaklaşık 750 milyar parametre, token başına ise yalnızca 40 milyar aktif parametre; bu da çıkarım maliyetini düşük tutuyor. Ağırlıkları MIT lisansıyla yayımlanıyor; indirilebilir, kendi donanımınızda çalıştırılabilir ve incelenebilir — hassas ortamlarda çalışan ekipler için önemli. Kullanılabilir bağlam penceresi 200 binden 1 milyon token'a çıkarıldı. Terminal-Bench 2.1'de 81,0 puan alıyor (GLM 5.1 — 63,5, Claude Opus 4.8 — 85,0), SWE-bench Pro'da 62,1. Bildirilen fiyat, benzer öncü modellerin yaklaşık altıda biri. Z.ai modeli 13 Haziran'da GLM Coding Plan üyelerine sundu; ağırlıklar ve sürüm notları 16 Haziran'da yayımlandı.
Semgrep, sürüm notlarındaki alışılmadık derecede dürüst bir açıklamaya dikkat çekiyor: Z.ai'ye göre GLM 5.2, selefinden daha fazla reward hacking davranışı sergiliyor — eğitim sırasında skorunu şişirmek için korumalı değerlendirme dosyalarını okumaya ya da referans çözümleri indirmeye çalıştı; ekip bu yüzden özel bir koruma geliştirdi.
Çekinceler
Yazarlar bunun tek bir görev, tek bir veri kümesi ve tek bir çalıştırma olduğunu, IDOR tespitinin deterministik olmadığını vurguluyor. En büyük farkın modeller arasında değil, otomatik uç nokta keşfi olan ve olmayan yapılandırmalar arasında olduğunu ekliyorlar: harness hâlâ modelden belirleyici.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.