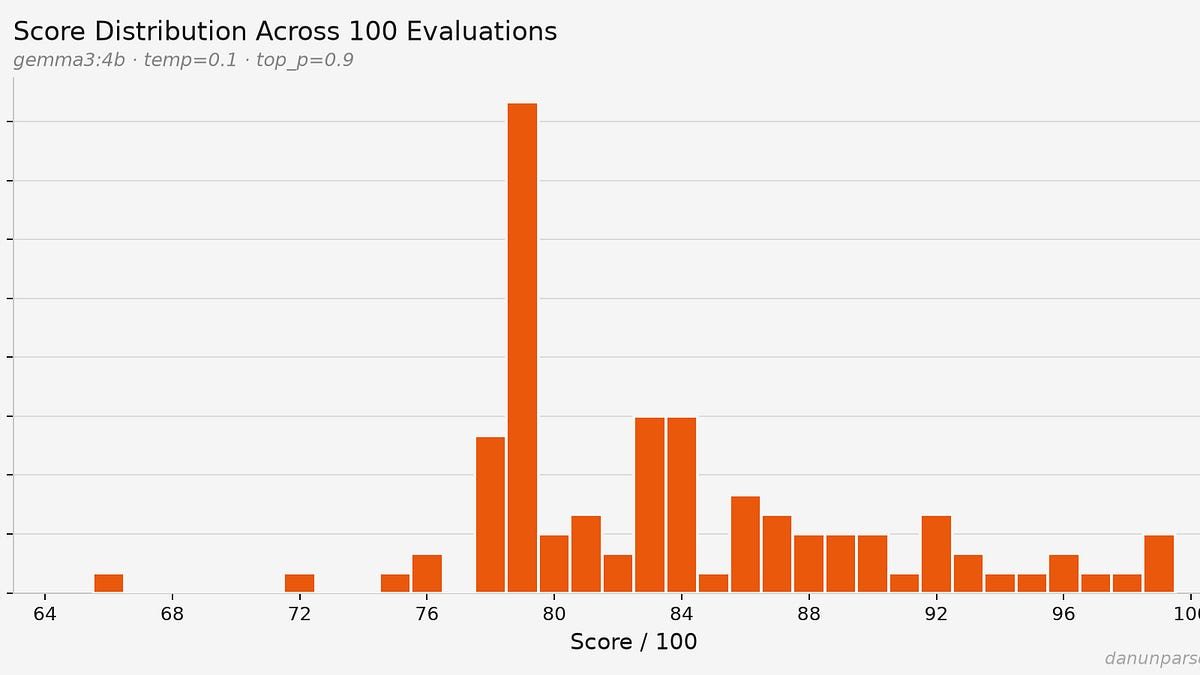
HackerRank'in açık kaynak ATS'si aynı CV'ye 66 ile 99 arası puan verdi
Bir geliştirici, HackerRank'in açık kaynaklı işe alım aracını aynı CV üzerinde 100 kez çalıştırdı ve 66 ile 99 arasında puanlar aldı: teknik beceriler neredeyse sabit kaldı, proje puanları ise çok dalgalandı.
HackerRank aday takip sistemini açık kaynağa açtı ve aracı test eden bir geliştirici, aynı CV'nin çalıştırmaya göre 100 üzerinden 66 ile 99 arasında puan aldığını gördü. GitHub'da interviewstreet/hiring-agent adıyla yayımlanan proje, danunparsed blogunun yazarı denemeden önce LinkedIn ve Reddit gönderileriyle yayıldı.
Test neleri buldu
İlk çalışan koşu yazarın CV'sine 100 üzerinden 90 puan verdi. Kurulumdan kalan hata ayıklama print satırları temizlendikten sonra aynı CV, aynı komutla 74 puan aldı. Geliştirme modunun kapatılıp aracın yüz kez döngüde çalıştırılması 66 ile 99 arasında sonuç üretti; şirketin eşiği 85 ise aynı CV vakaların yaklaşık yüzde 65'inde eleniyor.
Dağılım eşit değil. Teknik beceriler 100 koşunun 98'inde 10 üzerinden 8 aldı, çünkü bu kategori aslında bir kontrol listesi. 30 puan değerindeki projeler ise sürekli dalgalandı: model bazen projelerin mimari karmaşıklıktan yoksun olduğunu söyledi, bazen gerçek dünyada kullanımı övdü. Ekim ayındaki bir GitHub kaydı, art arda altı koşuda 27, 34, 32, 34, 34 ve 30 puan bildirdi. 25 puan değerindeki deneyim her seferinde 25 üzerinden 25 döndü — tek stajlı eski bir CV için bile — çünkü istemi yalnızca iki satır ve hiçbir ölçüt ya da örnek içermiyor. Yazarın ifadesiyle: tutarlı ama işe yaramaz.
Puanlama nasıl işliyor
Araç PDF CV'yi metne dönüştürüyor, ardından yapılandırılmış veriyi çıkarmak için bir dil modelini altı kez çağırıyor — temel bilgiler, iş geçmişi, eğitim, beceriler, projeler ve ödüller — adayın GitHub profilini ve öne çıkan depolarını ek bağlam olarak çekiyor ve her şeyi son bir değerlendirme çağrısına veriyor. Puan 100 üzerinden ve 20'ye kadar bonus ekleniyor: açık kaynak katkılarına 35, kişisel projelere 30, iş deneyimine 25, teknik becerilere 10 puan; ayrıca girişim deneyimi, portföy sitesi veya teknik blog için bonuslar. Varsayılan model 0.1 sıcaklıkta gemma3:4b.
Neden önemli
Daha güçlü bir modele geçmek aralığı daralttı ama sorunu çözmedi: Gemini puanları 48 ile 64 arasında topladı; bu da 60 eşiğinde yüzde 28 oranında başarısızlık demek. Claude Opus 4.8 ise dağılımı yalnızca biraz daralttı. Yazar, bu belirsizliğin ayar değil tasarım sorunu olduğunu ve zevk gerektiren değerlendirmelerin dil modellerine uygun olmadığını savunuyor. 28 Haziran tarihli düzeltme, değerlendirme şablonunun Software Intern ifadesiyle başladığını, ancak kıdemli mühendis istemiyle yapılan koşunun aynı sonuçları verdiğini belirtiyor; yani puanlama boyutları pozisyona bağlı değil. Yazı ayrıca açık kaynak ve kişisel projelerin ağırlığın yüzde 65'ini taşıdığı uyarısını yapıyor; bu, çalışmaları GitHub'a hiç girmemiş deneyimli mühendisleri geri plana itebilir.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.