NVIDIA DSX MaxLPS, aynı güç bütçesinde AI fabrikası verimini %49 artırdı
NVIDIA ve Nscale'in İzlanda'daki GB300 NVL72 sistemlerinde yürüttüğü ortak test, aynı 264,4 kW bütçeyle 140 yerine 192 GPU çalıştırdı; toplam verim %49,2 arttı, tek tek örneklerin hızı ise neredeyse değişmedi.
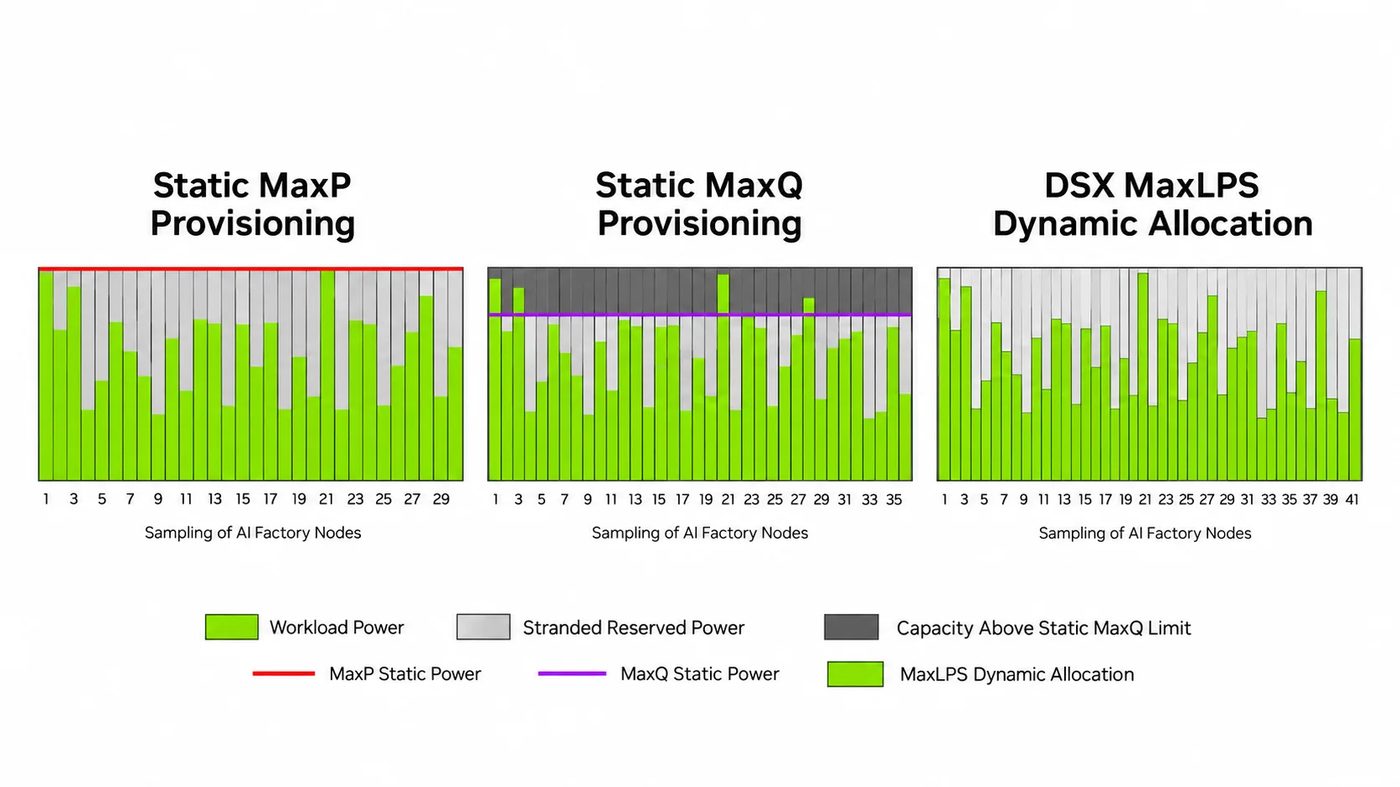
NVIDIA, geliştirici blogunda DSX MaxLPS'yi anlatan teknik bir inceleme yayımladı. Bu katman, bir veri merkezinde her düğüm için sabit bir tepe güç payı ayırmak yerine gücü GPU'lar arasında dinamik olarak paylaştırır. 27 Eylül 2026 tarihli yazının yazarları Sarah McKenney ve Harry Petty'ye göre yaklaşım, aynı onaylı güç bütçesi içinde %40'a kadar daha fazla GPU yerleştirmeye olanak tanıyor.
Statik pay kapasiteyi neden boşa bırakıyor
Bir AI fabrikası elektriksel sınırlar hiyerarşisi içinde çalışır: şebeke bağlantısı ve trafo merkezlerinden raflara, düğümlere ve GPU'lara kadar. Operatörler genellikle tüm hızlandırıcıların aynı anda tepe güce ulaşmasına yetecek pay ayırır, oysa gerçek iş yükleri böyle davranmaz: eğitimde hesaplama, iletişim ve kontrol noktaları birbirini izler, çıkarımda ise prefill, decode, belleğe bağlı iş ve boşta bekleme arasında geçiş olur. Düğüm başına statik pay ayrıldığında bir rezervasyonun içindeki boş kapasite diğerine aktarılamaz; DSX MaxLPS ise gerçek tüketimi izleyip gücü operatörün politikaları çerçevesinde yeniden dağıtır.
Değerlendirme nasıl yapıldı
Nscale yazılımı İzlanda'daki Keflavík Verne kampüsündeki veri merkezinde devreye aldı; iş yüklerini NVIDIA, Blackwell Ultra GPU'lu GB300 NVL72 sistemlerinde ve FP4 duyarlılıkta Kimi K2.5 ile çalıştırdı. Temel yapılandırma 140 GPU kullanırken MaxLPS yapılandırması, aynı 264,4 kW'lık bütçeyle 52 GPU'luk üçüncü bir yüksek verimli örnek ekleyerek 192 GPU'ya çıktı.
Ölçümler ne gösterdi
Normalize edilmiş toplam verim %49,2 artarak saniyede 1.084.503 tokenden 1.618.443 tokene çıktı, ayrılan watt başına verim ise 4,10'dan 6,12 token/s/W'ye yükseldi. Tek tek örneklerin çıktısı neredeyse değişmedi: yüksek verimli örneklerde 59.220 token/s, temel yapılandırmadaki 59.153'e karşı.
Ortalama GPU gücü 97,0 kW'tan 131,8 kW'a, bütçe kullanımı ise %62,9'dan %75,2'ye çıktı. Medyan ve P75 gecikme temel seviyenin %5'i içinde kaldı, ancak ilk tokene kadar geçen sürede P99 %17 kötüleşti.
Operatörler neyi doğrulamalı
NVIDIA beş aşamalı bir yol öneriyor: yönetilen sınırı ve uygulanabilir limitini tanımlamak, statik tahsis altında temsili bir temel ölçüm almak, politikaları bu temele yakın değerlerle devreye almak, kapasiteyi her adımda test ederek artırmak ve üretim limitlerini ancak bundan sonra onaylamak.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.