NVIDIA'nın SWE-Serve'ü yerel testler ile canlı sunum arasındaki uçurumu gösteriyor
NVIDIA, SGLang ekibinin katkısıyla hazırlanan SWE-Serve ölçütünü yayımladı: 83 birleştirilmiş pull request'ten 53 uygulanabilir görev çıktı. Diğer tüm kontrolleri geçen yamaların yaklaşık üçte biri canlı sunum testlerinde başarısız oluyor.
Bir kod ajanının yaması testleri geçebilir, ancak sunucu gerçek bir modeli yükleyip istekleri işlemeye başladığında başarısız olabilir. NVIDIA, 23 Eylül'de yayımladığı SWE-Serve ölçütüyle tam olarak bu uçurumu ölçüyor. SGLang ekibinin katkısıyla geliştirilen ölçüt, 83 birleştirilmiş SGLang pull request'ini 53 uygulanabilir göreve dönüştürüyor.
SWE-Serve neleri test ediyor
Görevler altı alana ayrılıyor: spekülatif ve gelişmiş kod çözme (14), model ve arka uç etkinleştirme (12), çekirdekler, kuantizasyon ve performans (8), sunum API'leri ve çalışma zamanı doğruluğu (8), önbellekleme (7), dağıtık yürütme ve zamanlama (4). On iki görev CPU'da, 41 görev ise tek bir NVIDIA H100 üzerinde çalışıyor; ilk sürüm diğer inference motorlarını, çoklu GPU yürütmesini ve çok düğümlü sunumu kapsamıyor. On dokuz görev gerçek bir sunucu başlatıyor.
Canlı sunum testleri neyi yakalıyor
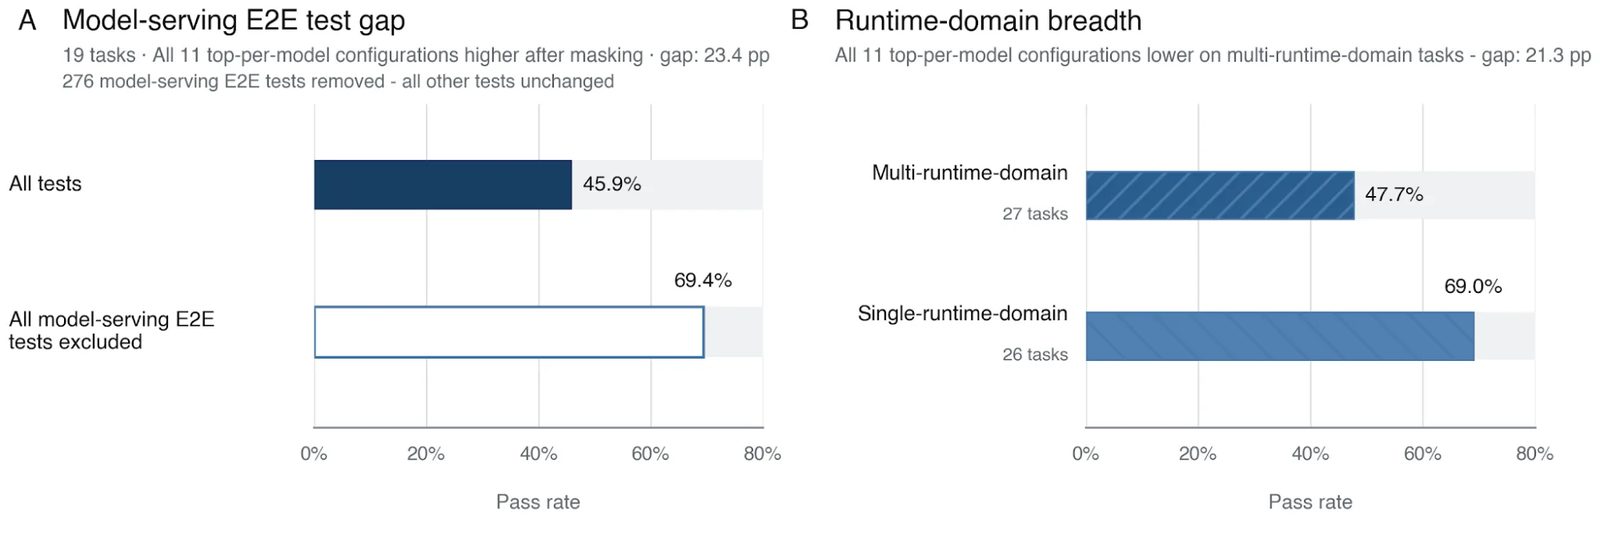
Canlı sunucu çalıştıran 19 görevde aynı 627 yama, tam doğrulayıcı altında %45,9 oranında geçiyor. Sunum testleri çıkarıldığında bu oran %69,4'e yükseliyor: 147 yama başarısızdan başarılıya geçiyor ve diğer tüm kontrolleri geçen yamaların yaklaşık üçte biri bir sunum testinde başarısız oluyor. Bu görevlerde 276 sunum testi var; 242'si SGLang'dan alınmış ya da uyarlanmış. Gemma 4 MoE görevi tabloyu net gösteriyor: 33 yamanın 16'sı diğer tüm kontrolleri geçtiği halde en az bir canlı sunum testinde başarısız oldu.
Yazarlara göre geçişin anlamı dar: yama ölçüt doğrulayıcısını karşılıyor, ancak dağıtıma hazır ya da SGLang geliştiricileri tarafından onaylanmış olduğunu göstermiyor.
Ajanlar nerede düşük puan alıyor
İstekten çıktıya giden yol dört çalışma zamanı alanına ayrılıyor: istek işleme ve G/Ç, zamanlama ve istek yaşam döngüsü, model yürütme, KV-cache ve kaynak yönetimi. Tek alanda kalan 26 görev %69,0 oranında geçerken, birden fazla alana yayılan 27 görev %47,7'de kalıyor; fark her model ayarında aynı yönde görülüyor.
On bir model ve 31 yapılandırma, yalnızca Bash kullanan minimal ajan mini-swe-agent ile kapalı koşullarda test edildi. Ortalama pass@1 %34,6 ile %75,5 arasında değişiyor. Zirvede %75 ile Claude Opus 5 ve GPT-5.6 Sol var; ancak %64'te dört modelin maliyeti belirgin biçimde farklı: görev başına 0,95 dolardan 7,24 dolara, ortalama süre ise 25,5 ile 99,9 dakika arasında.
Ekip 786 kaynağı taradı, 156 aday oluşturdu ve 53'ünü kabul etti; değiştirilmemiş kod yeni davranış testlerinde başarısız olurken regresyon testlerini geçmek zorundaydı. Değerlendirmede genel ağ ve upstream depoları engelleniyor.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.