Laya: bir sınır laboratuvarı fikri yeni sandığından bir yıl önce kurulan açık karar motoru
İyi fonlanan bir laboratuvar benzer bir modeli atılım olarak duyurduktan sonra bir mühendis Laya'yı yayımladı: 32,8 ms'de kalibre edilmiş olasılıklar döndüren açık ağırlıklı System 1 karar modelleri.
Bir yıl önce otoregresif olmayan karar modelleri yayımlayan bir mühendis, iyi fonlanan bir sınır laboratuvarı benzer bir mimariyi yeni bir bilimsel atılım olarak sunduktan sonra tamamen açık bir alternatif yayımladı.
Bir yıllık fikrin yeni gibi sunulması
ConvAI Innovations'ın kurucusu ve CEO'su Nandakishor Mukkunnoth, yaklaşımı Mart 2025'te kurduğunu yazıyor: dizi dönüşüm yörüngeleri üzerine bir arXiv makalesi, model ağırlıkları ve Hugging Face'te açık bir veri kümesi. Eylül 2026'da ChatGPT'nin ortak mucidi Diogo Almeida tarafından kurulan TypeSafe AI, Jev'i piyasaya sürdü; yazar bunu aynı otoregresif olmayan karar konsepti olarak tanımlıyor, ancak teknik makaleler, açık ağırlıklar ve açık eğitim verileri olmadan. Jev, RLCD adını verdiği yöntemle paralel örnekleme yapıyor ve milyon giriş token'ı başına 0,042 dolar ücret alıyor; tipik yanıt süresi yaklaşık 150 ms.
Laya nedir
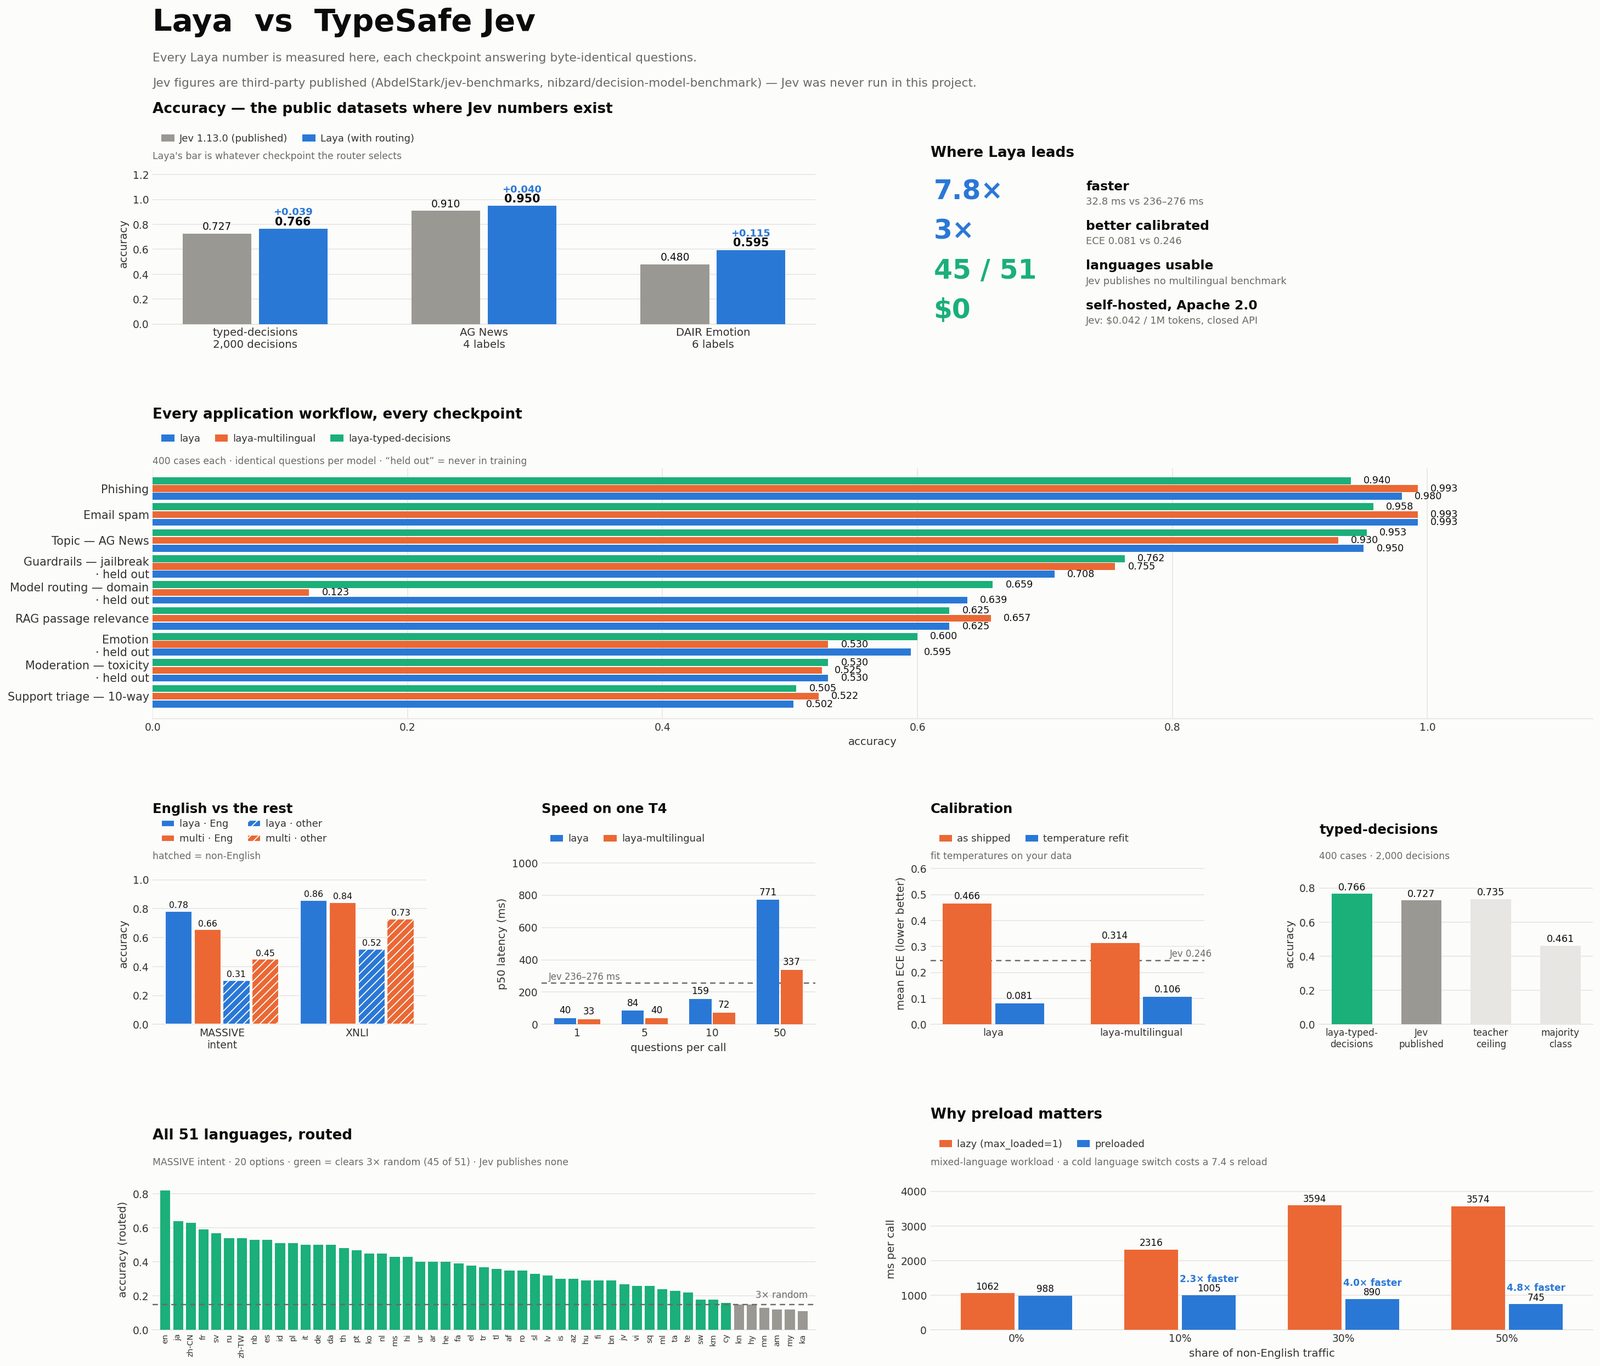
Kırgın kalmak yerine fikri Laya olarak yeniden kurdu: bir System 1 karar motoru. Metin üretmiyor, yalnızca yapılandırılmış şemalar üzerinde olasılık dağılımları döndürüyor. Üç ilkel üzerinden yanıt veriyor: sözlükten tek bir anahtar seçip dağılımı ve kalibre edilmiş güveni döndüren choice; bir belgeyi 0'dan 3'e gibi sıralı bir ölçeğe yerleştiren score; ve P(true) döndüren boolean soru noul. Çıktı uzayı yalnızca sayılardan oluştuğu için model halüsinasyon göremez ve bozuk JSON imkânsızdır, diyor yazar. Çift yönlü kodlayıcılarla tek GPU'da 32,8 ms'de, toplu çalışmada soru başına 7,2 ms'de yanıt veriyor; sayfaya göre bu Jev'den altı ila sekiz kat hızlı, Apache 2.0 ağırlıklarla ve API maliyeti olmadan.
Üç checkpoint ve bir yönlendirici
Aile tek bir Hugging Face deposunda üç checkpoint barındırıyor: İngilizce sınıflandırma ve e-posta ayıklama için laya (ModernBERT-large, 421 milyon parametre, 512 token bağlam); 100'den fazla dil için laya-multilingual (mmBERT-base, 256 bin token sözlüğü, 322 milyon parametre); ve 0,766 doğrulukla ajan senaryoları için laya-typed-decisions. MASSIVE kıyaslamasındaki 51 dilli tarama, İngilizce modellerin Latin alfabesi dışında nasıl çöktüğünü gösterdi: Khmer dilinde model 0,952 ortalama güvenle 0,000 doğruluk aldı. Güven, doğruluk %82 de olsa sıfır da olsa hiçbir zaman 0,885'in altına düşmedi; bu yüzden güvene göre filtreleme korumaz ve yönlendirme kararı ileri geçişten önce verilmelidir. Laya'nın yönlendiricisi 22 alfabeyi Unicode yazı sistemlerine göre inceliyor ve İngilizce için 0,09 ms, Hint yazıları için 0,54 ms, büyük iç içe JSON için 0,73 ms ekliyor.
Kıyaslamalar ve dürüst sınırlar
Ortak kıyaslamalarda yönlendirilmiş sistem AG News'te Jev'in 0,910'una karşı 0,950, DAIR Emotion'da 0,480'e karşı 0,595, beklenen kalibrasyon hatasında 0,246'ya karşı 0,081 ve medyan gecikmede 236–276 ms'ye karşı 32,8 ms raporluyor. Sayfa sınırları da listeliyor: choice şemaları 20 seçeneğin üzerinde doğruluk kaybediyor — 77 etiketli Banking77'de Laya 0,425 alırken Jev 0,870 aldı; temel modeller ince ayar olmadan 0,35 civarında kalıyor; ve soru tipi başına tek bir sıcaklık skaleri uydurmak kalibrasyon hatasını 0,466'dan 0,081'e indiriyor.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.