Jeff: Jev uyumlu 0,8B karar modelleri tek yerel GPU'da eğitildi
Açık kaynak proje Jeff, Qwen3.5 ve Gemma 4'ü küçük zero-shot sınıflandırıcılara dönüştürüyor: tek ileri geçiş, her seçenek için kalibre edilmiş olasılığı yaklaşık 22 ms'de döndürüyor.
GitHub'da Jeff adlı açık kaynak bir proje yayımlandı: Qwen3.5 ve Gemma 4'ün 0,8B ve 2B parametreli küçük sürümlerini, Jev ile aynı istek biçimini kullanan sınıflandırıcılara dönüştürüyor. Kullanıcı durumu ve seçenekleri sade sözcüklerle anlatıyor; model tek ileri geçişte her seçenek için kalibre edilmiş bir olasılık döndürüyor. Metin üretilmiyor, dolayısıyla yanıtı ayrıştırmak gerekmiyor. Bir karar NVIDIA RTX PRO 6000'de yaklaşık 22 ms, Apple M4 Max'te MLX üzerinden 28 ms sürüyor.
Jeff nedir
Zero-shot, seçeneklerin her şey olabileceği anlamına geliyor: destek kuyrukları, kullanıcı niyetleri, moderasyon etiketleri veya oyun hamleleri. Kategorilerin eğitim verisinde yer alması gerekmiyor, çünkü istekte kullanıcı bunları tarif ediyor. Hugging Face'te üç model yayımlandı: Jeff-Qwen3.5-0.8B, Jeff-Qwen3.5-2B ve Jeff-Gemma4-E2B. Tek istekte üç soru tipi sorulabiliyor: 255 seçeneğe kadar seçim, olasılık olarak dönen evet/hayır yanıtı ve tanımlanan ölçekte puan.
Benchmark sonuçları
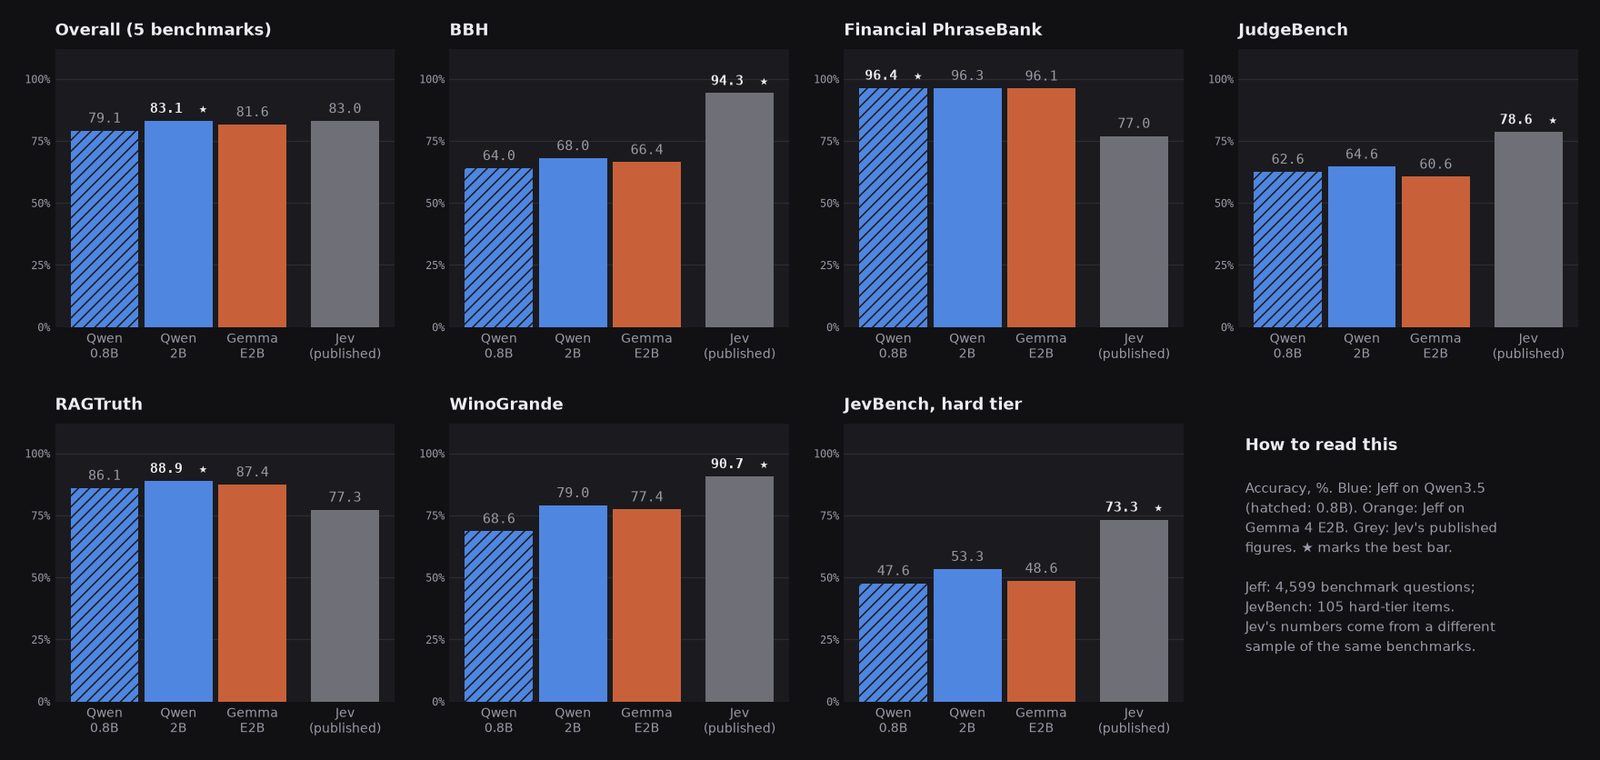
Modeller beş kamuya açık benchmark'ın 4.599 sorusunda, JevBench'in zor katmanı ise ayrıca 105 maddede test edildi. Genel puanda Jeff-Qwen3.5-2B 83,1'e, Jeff-Gemma4-E2B 81,6'ya, Jeff-Qwen3.5-0.8B ise 79,1'e ulaşıyor; Jev'in yayımlanmış sonucu 83,0. Financial PhraseBank'ta küçük modeller 77,0'a karşı 96,4'e çıkıyor, muhakeme testlerinde ise geride kalıyor: BBH'de 94,3'e karşı 64,0. Yazarlar genel puanın sınıflandırma görevlerinden geldiğini belirtiyor.
Yerel donanımda eğitim
Proje yerel donanımda geliştirildi: 0,8B model tek bir RTX PRO 6000 iş istasyonu GPU'sunda yaklaşık iki saatte, 2B sürüm üç buçuk saatte eğitiliyor. Sentetik eğitim verisini açık model Qwen3.8-Flash-Next iki DGX Spark üzerinde yazdı, testler MacBook'ta yapıldı. Bulut GPU kullanılmadı ve eğitim verisine kapalı bir modelin çıktısı girmedi. Jeff bağımsız bir proje ve Jev'in yapımcısı TypeSafe ile bağlantılı değil. Kod MIT, ağırlıklar Apache 2.0 lisansıyla yayımlanıyor.
Oyunlar ve sınırlar
Zero-shot yeteneğini sınamak için Jeff üç oyun oynadı; her turda durum sözcüklerle anlatıldı: Doom'da 6,55 öldürme, elle yazılmış kural botuyla aynı sonuç; Frogger'da eğitilmemiş modelin 1,0'ına karşı 10,3 geçiş; Pac-Man'de 25,8'e karşı 98 noktanın 57,0'ı; M4 Max'te hamle başına 29-49 ms. Yazarlar sınırları da sıralıyor: küçük modeller muhakeme yapmıyor, yalnızca İngilizce metinle çalışıyor, benchmark puanı oyunu öngörmüyor ve 2B oyunlarda 0,8B'den daha kötü. Kendi örneklerinizle kısa bir ince ayar çok şey değiştiriyor: sesli navigasyon için yaklaşık 11 bin örnekle eğitilen sürüm, tek GPU'da yarım saatten kısa sürede doğruluğu %31,7'den %95,8'e çıkardı.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.