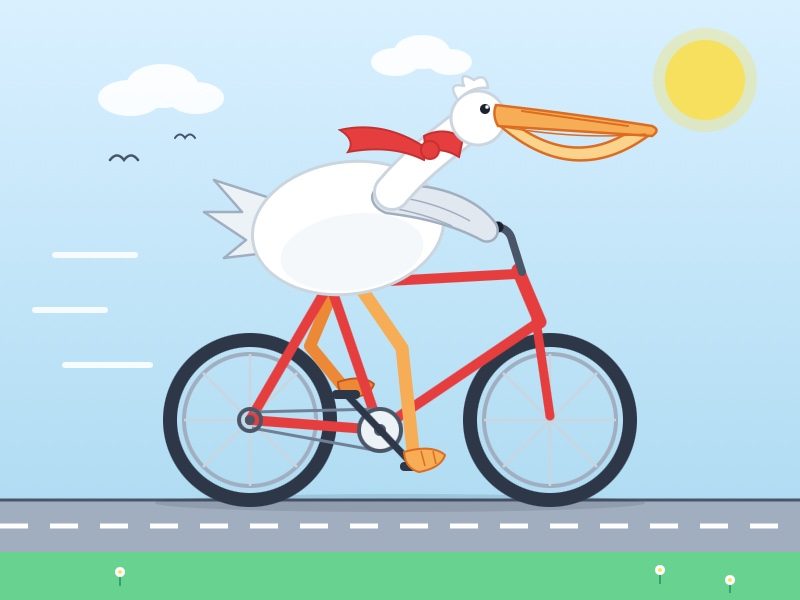
Kimi K3: 2,8 trilyon parametre ve 25 sentlik bir pelikan
Moonshot AI, 2,8 trilyon parametreli Kimi K3’ü duyurdu; şirket onu ilk “açık 3T sınıfı” model olarak tanımlıyor ve açık ağırlıkları 27 Temmuz’a kadar söz veriyor.
Çinli yapay zekâ laboratuvarı Moonshot AI, perşembe günü Kimi K3’ü duyurdu ve modeli “bugüne kadarki en yetenekli modeli, 2,8 trilyon parametreyle” diye tanımladı. Model şirketin web sitesi ve API’si üzerinden kullanılabiliyor; açık ağırlıklı sürüm ise “27 Temmuz 2026’ya kadar” sözü verildi.
Konumlandırma ve fiyat
Moonshot, K3’ü ilk “açık 3T sınıfı model” olarak adlandırıyor: 2,8 trilyonu üç trilyona yuvarlıyor ve bu unvanı DeepSeek 1.6T v4 Pro’dan alıyor. Şirketin kendi yayımladığı benchmarklara göre K3, karşılaştırmaların çoğunda Claude Opus 4.8 max ile GPT-5.5 high’ı geçiyor, ancak Claude Fable 5 ve GPT-5.6 Sol’un gerisinde kalıyor. Bağımsız değerlendirici Artificial Analysis, kendi uzun ufuklu bilgi işi testinde 1547 Elo ölçtü — Kimi K2.6’nın 732 puan üzerinde ve yalnızca Claude Fable 5’in ardında — görev başına 0,94 dolarla; bu, GPT-5.6 Sol için 1,04, Opus 4.8 için 1,80 dolar. Intelligence Index’teki token kullanımı K2.6’ya kıyasla %21 azaldı. Model ayrıca Arena.ai’nin Frontend Code arenasında Claude Fable 5’in önünde lider.
En dikkat çekici değişiklik fiyat: milyon giriş token’ı için 3 dolar, milyon çıkış token’ı için 15 dolar — Anthropic’in Claude Sonnet serisiyle aynı seviyede ve bir Çin laboratuvarının bugüne kadarki en pahalı modeli; Kimi K2.6’nın 0,95/4 dolarına kıyasla keskin bir artış.
Bisikletli pelikanı nasıl çiziyor
“Bisiklet üstünde pelikan” SVG istemini 21 aydır yeni modellerde deneyen Simon Willison, K3 ile OpenRouter üzerinden bir görsel üretti. Çalıştırma 95 giriş ve 16.658 çıkış token’ı tüketti; bunların 13.241’i akıl yürütme token’ıydı ve toplam maliyet 25 sent oldu. Üretilen görsel girdi olarak verildiğinde model onu yaklaşık 0,6 sent karşılığında doğru biçimde tanımladı. İstem ayrıca K3’ün şu anda yalnızca tek bir akıl yürütme düzeyi sunduğunu — “max” — ve tek başına “hi” yazmanın 86 token olarak faturalandığını gösterdi; bu, modelin açıklamayı reddettiği yaklaşık 85 token’lık gizli bir sistem istemine işaret ediyor.
Test bugün ne anlatıyor
Willison, pelikanın kötü bir benchmark olduğunu ve modelleri sıralamak için kullanılmaması gerektiğini açıkça söylüyor: ajan araç çağırma ya da uzun sohbetlerde güvenilirlik hakkında hiçbir şey söylemiyor ve model kalitesiyle olan eski korelasyonu bozuldu — GPT-5.6 ile Claude Fable 5’in pelikanları GLM-5.2’ninkinin gerisinde. Değeri daha dar: kişiyi modeli gerçekten çalıştırmaya zorluyor, maliyet ve akıl yürütme yükü için kaba bir tahmin veriyor, geçerli SVG çıktısını ve temel uzamsal algıyı doğruluyor, ayrıca aynı model ailesi içinde karşılaştırma sağlıyor — K3’ün kuşu Kimi 2.5’inkinden belirgin biçimde iyi.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.