Qwen 3.8 27B: 17 GB'da mükemmel, ancak varsayılan olarak fazla düşünüyor
Alibaba'nın Qwen laboratuvarı, Apache 2.0 lisansıyla görsel yetenekli 27 milyar parametreli bir model yayınladı. Model sıradan donanımda çalışıyor, fakat varsayılan akıl yürütme ayarı gereğinden çok kaynak tüketiyor.
14 Ağustos'ta Alibaba'nın Qwen araştırma laboratuvarı, Apache 2.0 lisansıyla yayınlanan 27 milyar parametreli ve görüntü tanıma yeteneğine sahip Qwen 3.8 27B modelini duyurdu. Ağırlıklar Hugging Face üzerinde mevcut; model LM Studio veya llama.cpp ile yerel olarak çalıştırılabiliyor.
Sonuçlar ve ilk izlenimler
Qwen'in kendi yayınladığı sonuçlar yeni modeli, selefi Qwen 3.6 27B'nin ve hatta mayıs ayı itibarıyla Qwen'in boyuttan bağımsız en güçlü modellerinden sayılan kapalı ağırlıklı Qwen 3.7-Plus'ın belirgin biçimde önüne koyuyor. Bağımsız değerlendirmeler henüz yayınlanmadı. Modeli 128 GB belleğe sahip bir M5 Max MacBook Pro'da ve bir NVIDIA DGX Spark üzerinde test eden geliştirici Simon Willison, 27B boyutunu güçlü bir modeli normal bir dizüstü bilgisayarda çalıştırmak için mükemmel bir boyut olarak nitelendirdi.
Varsayılan olarak aşırı düşünme
Modelde varsayılan değeri "xhigh" olan bir reasoning_effort parametresi var ve LM Studio'daki GGUF sürümü bu ayarı koruyor. Pratikte bu, en basit isteklerin bile binlerce akıl yürütme tokeni harcaması anlamına geliyor: LM Studio'nun varsayılan 8.192 tokenlik bağlam penceresi hızla doluyor ve sorun ancak 262.144 tokenlik tam bağlam yüklendiğinde ortadan kalkıyor.
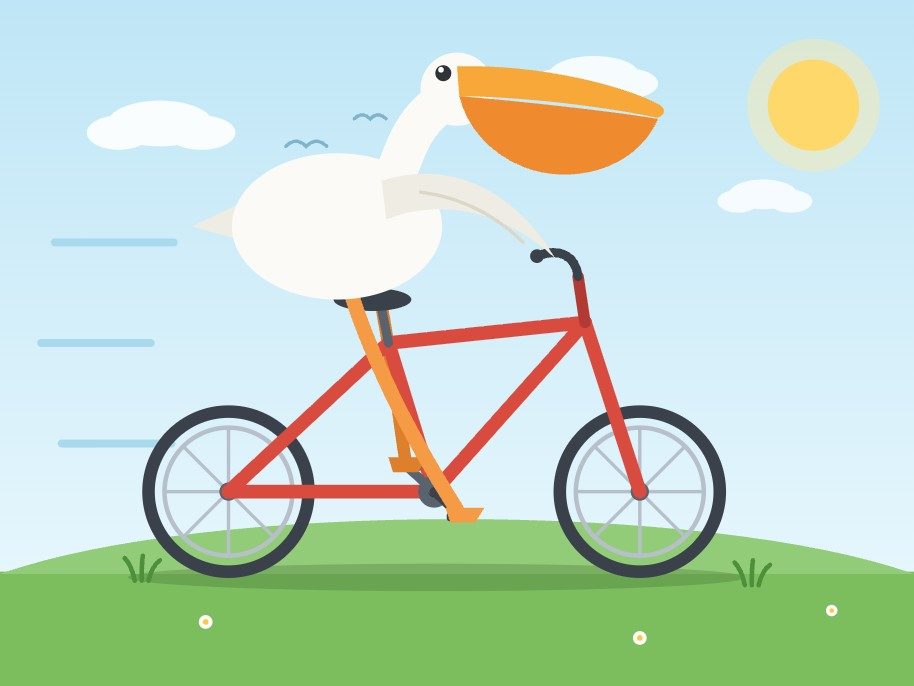
Bir testte model, 3.223 tokenlik bir SVG çıktısı — bisiklete binen bir pelikan — üretmek için 21 dakika ve 22.276 akıl yürütme tokeni harcadı. Akıl yürütme kapatıldığında aynı istek 137 saniyede ve 3.715 tokende tamamlandı. Yalnızca "bir dairenin SVG'sini çiz" isteğine ise model karmaşık, animasyonlu bir kompozisyonla yanıt verdi. Yazarın pratik önerisi, modeli en azından başlangıçta düşük seviyede ya da akıl yürütme kapalıyken çalıştırmak.
Görü, araç kullanımı ve hız
Model görsel algıda güçlü çıktı: bir fotoğraftaki pelikanlar için 0–1000 ölçeğinde JSON sınırlayıcı kutular istendiğinde nesneleri yakından eşleştiren koordinatlar döndürdü. Tek bir istemle, görsel üzerine bu tür kutular çizen ve tamamen çevrimdışı çalışan küçük bir HTML aracı da geliştirdi; sonuç gereğinden fazla karmaşık ama işlevseldi.
En büyük dezavantaj hız. LM Studio saniyede yaklaşık 15–30 token verdi; Artificial Analysis ölçümlerine göre OpenAI'ın barındırılan 5.6 Sol ve 5.6 Luna modelleri saniyede 74 ve 184 tokene ulaşıyor. Topluluk kaynaklı bir iyileştirme de var: Qwen Multi-Token Prediction desteği sunuyor ve draft-mtp spekülatif kod çözme seçeneğiyle başlatılan bir llama.cpp sunucusu, DGX Spark üzerinde yapılan bir ölçümde LM Studio'nun varsayılan sürümünü yaklaşık %72 geride bıraktı.
Asıl sonuç, 17 GB'lık bir dosyanın artık neyi gösterdiğiyle ilgili: uzun bağlam, araç çağırma, görü ve yetkin kod üretimi — hepsi geliştiricinin zaten sahip olduğu donanımda. Açık kalan soru, çıkarım hızının bu yeteneklere yetişip yetişemeyeceği.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.