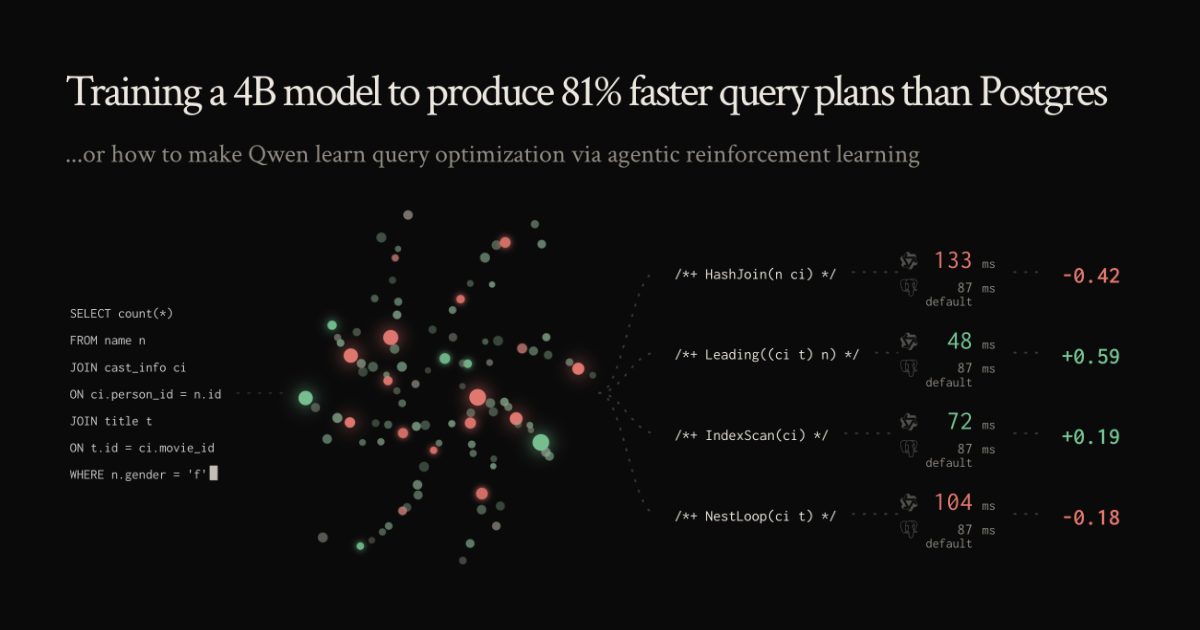
RL ile eğitilen 4B model, Postgres'ten %81 daha hızlı sorgu planları üretiyor
Rohan Bansal, 4 milyar parametreli açık ağırlıklı bir modeli pg_hint_plan ipuçlarıyla PostgreSQL planlayıcısını yönlendirecek şekilde eğitti. 113 birleştirme ağırlıklı sorguda toplam gecikme %44,7 azaldı.
Küçük bir model Postgres planlayıcısına karşı
Rohan Bansal, küçük ve açık ağırlıklı bir dil modelinin, PostgreSQL için veritabanının kendisinden daha iyi sorgu planları üretecek biçimde sonradan eğitilebileceğini gösteren bir deney yayımladı. IMDb veri kümesi üzerinde birleştirme ağırlıklı 113 SQL sorgusundan oluşan Join Order Benchmark'ta (JOB) eğitilmiş 4B model, en iyi adayın seçilmesiyle geometrik ortalamada 1,81 kat hızlanma sağladı; tüm iş yükünün toplam gecikmesi ise %44,7 düştü. Aynı kontrol noktası 68 kazanç ve hiç gerileme kaydetti.
Başlangıç noktası hiç iç açıcı değildi: eğitilmemiş model 113 sorgunun 99'u için kullanılabilir bir plan üretemedi ve yalnızca 14 denemesi geçerli bir aday verdi. Yazarın çerçevesine göre sorgu iyileştiricileri zordur — birleştirme sırası NP-zor bir problemdir ve planlayıcı satırları saymak yerine istatistiklerden kardinalite tahmin eder — ama bir planı doğrulamak kolaydır, çünkü tek ölçüt çalışma süresidir. Pekiştirmeli öğrenmeyi bu problem için uygun kılan da tam olarak bu asimetridir.
İpuçları, bir ajan ortamı ve damıtma
Model planlayıcının yerini almıyor, onu yönlendiriyor. Bansal, SQL yorumları içinde yapılandırılmış ipuçları kabul eden üçüncü taraf eklentisi pg_hint_plan'ı kullandı ve qo-agent adlı altı araçlı bir ajan ortamı kurdu. Ajan tabloları ve sütun istatistiklerini inceliyor, varsayılan planı okuyor ve aday plan eylemleri gönderiyor; her aday ipucuna dönüştürülüp çalıştırılıyor ve varsayılan plana karşı süreyle ölçülüyor.
Eğitim iki aşamada ilerledi. Önce, 500 adet GPT-6 Astra ajan izinden off-policy damıtma yoluyla gözetimli ince ayar yapıldı; 4,66 milyar parametreli bir Qwen türev modelinin üzerine yalnızca 42,5 MB boyutunda ve 21,2 milyon eğitilebilir parametreli bir LoRA adaptörü güncellendi. İki epoch sonuçları iyileştirdi, üçüncüsü ise doğrulama kaybı hiç değişmediği hâlde kötüleştirdi.
Gürültülü bir ortamda ödüller
İkinci aşama, özelleştirilmiş bir GRPO varyantıyla ajan tabanlı pekiştirmeli öğrenmeydi. Hızlanma, üç varsayılan plan ölçümünün medyanının üç aday ölçümünün medyanına bölünmesiyle hesaplandı ve ölçüm düzeneğinin özellikle dikkatli kurulması gerekti: tek makinede çalışan dört PostgreSQL konteyneri, zamanlamaları bozan Linux sayfa önbelleği rekabeti yaratıyor. Eğitim iki konuma bölündü — vLLM ve eğitici kiralık bir 2x H100 düğümünde, veritabanı konteynerleri yazarın masasında. İlk ödül formülü modeli sürekli Postgres'in varsayılan planını döndürmeye itti; çözüm, rollout'ları mutlak puanlamak yerine birbirleriyle karşılaştırmak oldu.
Model ne öğrendi
1.200 güncellemeden sonraki son kontrol noktasında, aramaların çoğu önce bir tabloyu, sütun istatistiğini ya da varsayılan planı inceledi. Proje yaklaşık 1.200 dolara mal oldu: Lambda'da kabaca 95 saatlik 2x H100 düğümü ve gösterim izleri için 400 dolar OpenAI API ücreti. Bansal'ın vardığı sonuç büyük modellerin modasının geçtiği değil — küçük modelin çalışmasının nedeni tam da Astra'dan yapılan damıtma — küçük modellerin dar ve kolay doğrulanabilir görevlerde ciddiye alınmayı hak ettiğidir.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.