Yerel LLM'iniz göründüğünden daha akıllı: çıkarım yığını kaliteyi nerede kaybediyor
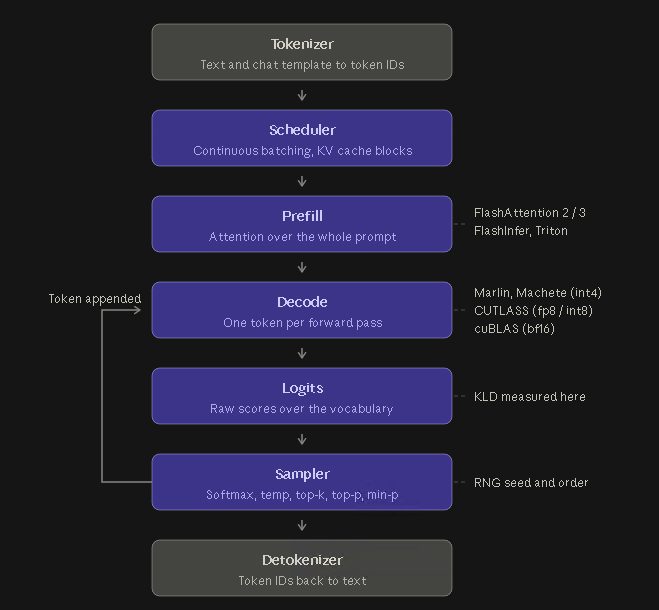
Level1Techs forumunda yayınlanan bir deney dizisi, yerel bir modelin "aptal" görünmesinin çoğu zaman attention arka uçlarından, KV önbelleği nicelemesinden ve tensör paralelliğinden kaynaklandığını gösteriyor.
Level1Techs forumunda yayınlanan bir deney dizisi, yerel olarak çalıştırılan bir modelin çoğu zaman olduğundan daha zayıf göründüğünü ortaya koyuyor — ve sebep genellikle modelin kendisi değil, çıkarım (inference) yığını. Başlığın yazarı, thr3e takma adlı kullanıcı, aynı ağırlıkları farklı çalışma zamanı ayarlarıyla çalıştırıp çıktıların nerede ayrışmaya başladığını ölçüyor.
Hiçbir uygulama aynı değil
Yazar, modeli yayımlayan, birinci taraf olarak barındıran ve özgün kıyaslama sonuçlarını paylaşan laboratuvar için "referans uygulama" terimini kullanıyor: onların donanımı ve yazılımı sizinkinden farklı. Ev laboratuvarları sıklıkla farklı GPU nesillerini karıştırıyor; farklı komut setleri, aynı ağırlıklarla bile bir sonraki tokenın matematiğini değişik biçimde hesaplıyor. Deneylerde kullanılan nightly vLLM konteynerinde 734 paket vardı, bunların 252'si Python paketiydi — yani kendi hataları ve belgelenmemiş davranışları olan 734 kod tabanı.
Üç test: arka uçlar, KV önbelleği, niceleme
İlk testte üç attention arka ucu — FlashAttention 2, Flash Inference ve Triton Attention — Qwen3.6-27B'nin BF16 sürümünde, RTX PRO 6000 Blackwell üzerinde karşılaştırıldı; başka hiçbir şey değiştirilmedi. İş yükü, gerçek bir çalışma akışından alınan ve araç çağrıları içeren yaklaşık 100 bin tokenlık bir bağlamdı. İlk birkaç bin token boyunca tüm arka uçlar hemfikirdi, ilerleyen bölümlerde ayrışmaya başladılar. Aynı arka ucun tekrarı bit düzeyinde özdeş logitler verdi; yani farklılık rastgelelikten değil, prefill aşamasındaki matematikten geliyor.
İkinci testte yalnızca KV önbelleği niceleştirildi: int8 sürümü bozulan araç çağrısından sonunda toparlandı, int4 toparlanamadı. Üçüncü testte beş ağırlık biçimi karşılaştırıldı: INT8 W8A16 en iyi sonucu verirken Nvidia'nın NVFP4'ü son sırada kaldı — 88 bin tokenlık bağlamda tokenların yaklaşık %50'si "takla attı". NVFP4 ve AWQ W4A16 bir Cisco cihazında yanlış komutu çalıştırdı: 'show arp' yerine 'show run'.
Tek bir token, başarısız bir görev
Yazının ikinci bölümünde yazar, araç çağrıları sırasında logitlerin %100'ünü kaydedip üretimleri dallandırarak her sürümün nereye gittiğini inceledi. Bir vakada FlashAttention 2 ile çalışan sürüm GigabitEthernet0/0/1.201 yerine GigabitEthernet0/1/4 adresini hedefledi ve ardından 'show mac address table' yerine 'show run' çalıştırdı; başka bir vakada arayüz açıklamasını hiç ayarlayamadı. Tensör paralelliğinde aynı görev TP1'de geçti, TP2'de başarısız oldu, TP4'te yeniden geçti — bu da daha derin hata ayıklamada genellikle NCCL'e işaret ediyor.
Doğru ölçüm nasıl yapılır
Forumdaki öneri, gerçek iş yükünüzü temsil eden standart kıyaslamalar çalıştırmak: temperature'ı sıfıra çekip üç deneme istemi yapıştırmak, ajan tabanlı işlerin iyi bir benzeri değil; uzun bağlamda araç çağrısı ve alana özgü bilgi testleri gerekiyor. Model kartındaki örnekleyici ayarları ve sohbet şablonu kullanılmalı — çok düşük temperature, bazı modellerin THINK çıktısı içinde döngüye girmesinin nedeni. Yorumcular ayrıca KL sapmasının bir dağılımın referanstan ne kadar kaydığını ölçtüğünü, doğruluğu değil, ve yönlü olduğunu belirtti; top-1 uyuşmazlığı ise ayrı ve daha katı bir ölçüt. BF16 sayısal sadakat referansıdır, kâhin değil: niceleştirilmiş bir model ondan sapıp yine de daha iyi bir yanıt üretebilir.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.