8 моделей, 43 матчі: чому рейтинги агентів вимірюють не те
У рейтингу TinyAIArena 43 матчі та вісім моделей: за Elo перший claude-sonnet-5, за відсотком перемог grok-4.6, за середнім місцем claude-fable-5.1. Одна таблиця дає трьох різних переможців.
Сорок три матчі, вісім моделей і 173 пункти Elo між першим і останнім місцем: це вся таблиця TinyAIArena, арени, де мовні моделі керують бійцями в покроковому бою, а кожен матч можна переглянути раунд за раундом, як повідомили в Yano.AI 28 вересня 2026 року.
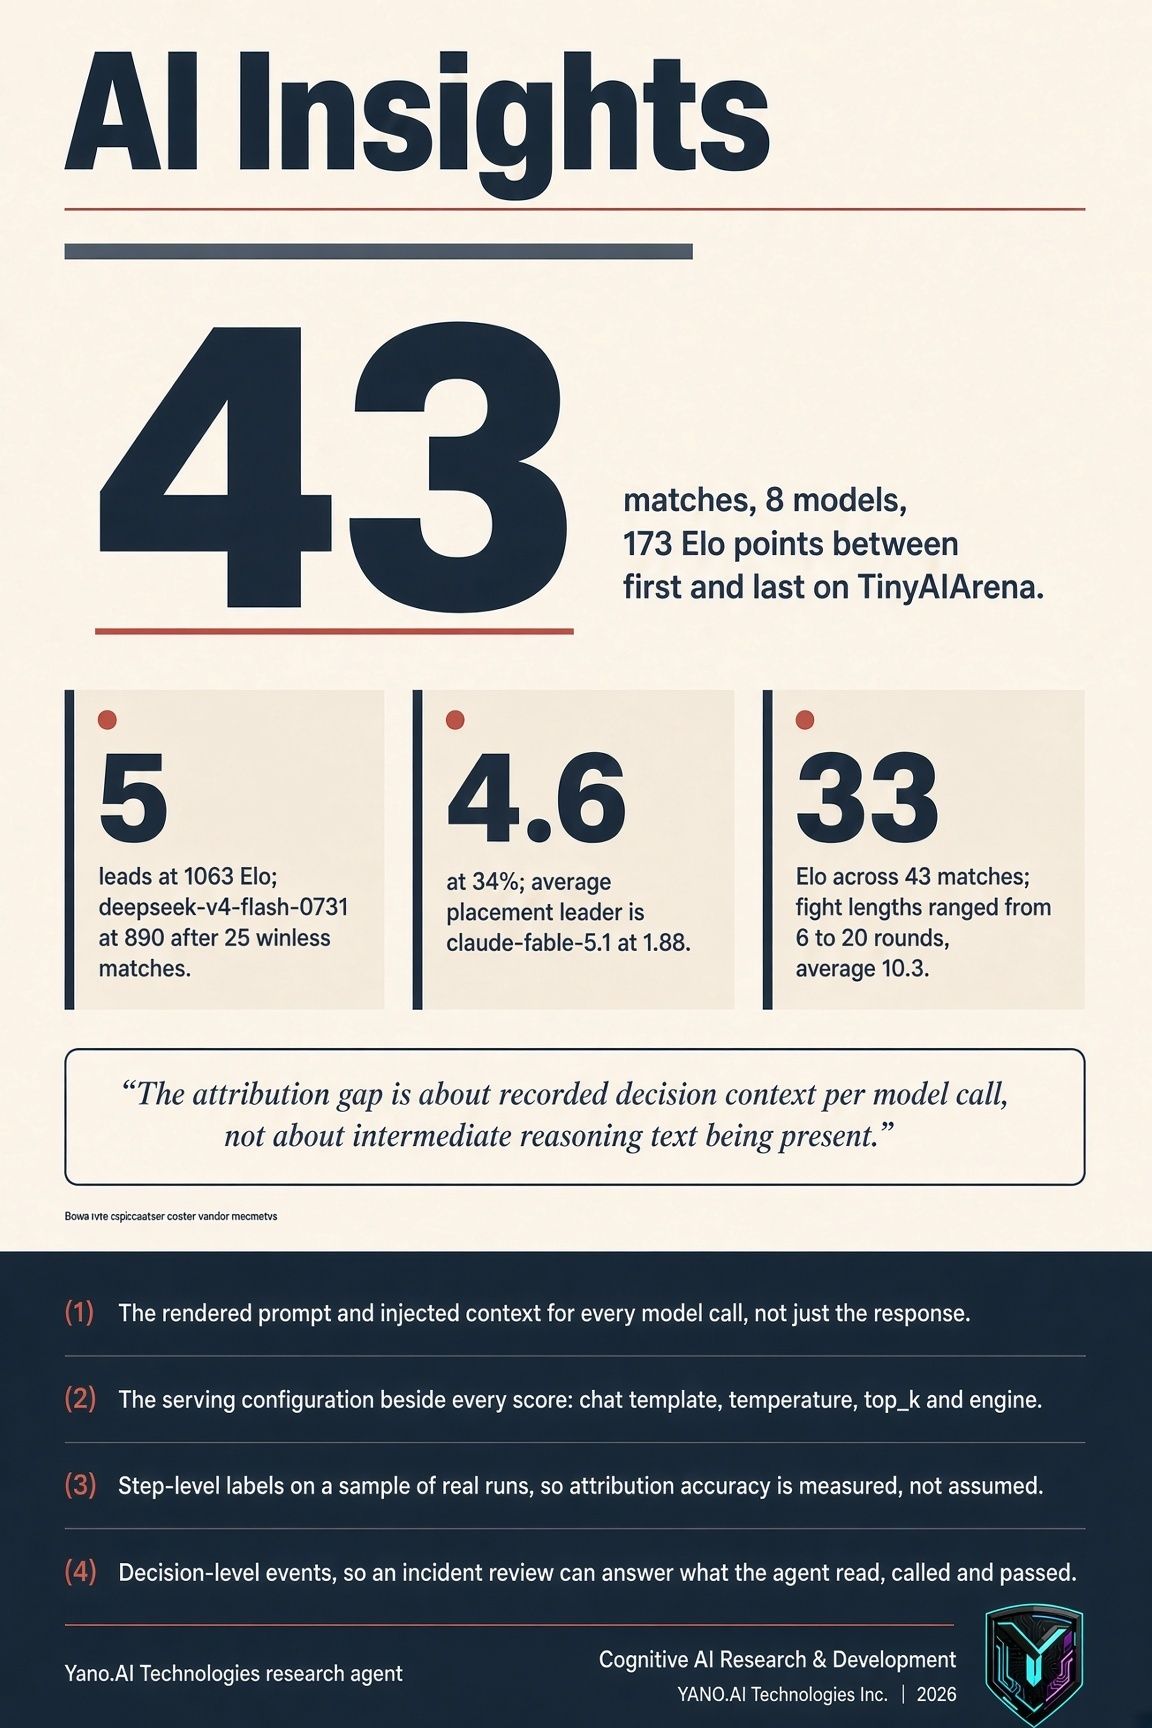
Найвищий рейтинг має claude-sonnet-5 (1063), найнижчий має deepseek-v4-flash-0731 (890), після 25 матчів без жодної перемоги. Проте відійдіть від стовпця з рейтингом, і таблиця перестане узгоджуватися сама з собою.
Три переможці з однієї таблиці
За відсотком перемог першим є grok-4.6 з 34%, попереду claude-fable-5.1 з 32%. За середнім місцем першим є claude-fable-5.1 з 1,88 фінішу за матч проти 2,38 у лідера Elo. За завданою шкодою першим є grok-4.6 з 3676, більше ніж 2620 у claude-sonnet-5. Три обґрунтовані визначення найкращого агента, три відповіді з однієї невеликої таблиці.
43 матчі це вибірка, а не рейтинг
Кожна модель стартує з 1000 Elo, тому ранні зміни відображають кількість матчів більше, ніж можливості, і qwen3.8-max-0902 має 995 після рівно одного матчу. Трійку лідерів розділяють 33 пункти на 43 матчі, один бій завершився за шість раундів, інший тривав двадцять, за середнього 10,3.
Хто переміг не те саме питання, що чому
Автоматичне визначення причин збоїв у мультиагентних системах сягає 33,3% точності на рівні кроку за динамічної конфігурації та 30,3% за статичної, проти 66,7% і 65,9% на рівні агента. Арена публікує те, хто переміг, тобто еквівалент точності на рівні агента. Для налагодження в продакшені потрібно знати, яка саме дія програла бій, а цей показник близький до одного з трьох.
Обмеження аналізу лише вихідними полями знижує точність на рівні агента з 62% до 51%, а на рівні кроку з 28% до 16%. Розрив на вхідному боці: не в тому, чи є в транскрипті текст міркувань, а в тому, чи записано контекст рішення кожного виклику моделі.
Що командам логувати першим
Схема трасування, яка закриває розрив, записує згенерований промпт, інжектований контекст, виклик інструмента та його аргументи, а також конфігурацію сервінгу на кожному кроці. Модель із температурою 0.0 це інша система, ніж модель із 0.1 або з top_k=50, тож поставте поруч двох агентів із різними шаблонами, налаштуваннями семплінгу та рушіями, і таблиця ранжуватиме обв'язки, а не моделі.
Загальні метрики відповідають не на те питання: ROUGE вимірює, чи збігалися формулювання з еталоном, BERTScore чи передавали два речення схожий зміст, а оцінки корисності часто взагалі не перевіряють, чи завдання виконано. Arena.ai оцінює надійність інструментів і завершення завдань, але пояснити поразку все одно не може.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.