AMD каже, що MEXT може зберегти 95% продуктивності сервера з половиною DRAM
AMD каже, що MEXT може скоротити використання серверної DRAM на 20-75%, зберігаючи більшу частину продуктивності завдяки флеш-пам'яті та ШІ. Компанія розгорнула технологію на 145 серверах і планує досягти 2000 наступного року.
AMD окреслила, як MEXT, прогнозний рушій пам'яті, може зменшити фізичну DRAM, потрібну в серверах, зберігаючи більшу частину продуктивності. MEXT заявляє про понад 99% продуктивності системи з повною DRAM під час роботи з лише 25% фізичних DIMM. Технологія переміщує холодні сторінки пам'яті у флеш-пам'ять і використовує модель ШІ, щоб повертати їх до потреби.
Як MEXT переміщує пам'ять у флеш-пам'ять
MEXT вивантажує холодні сторінки пам'яті у флеш-пам'ять, тоді як відсутня пам'ять усе ще реєструється як встановлена DRAM для операційної системи. Оскільки флеш-пам'ять повільніша за DRAM, MEXT використовує модель ШІ, щоб прогнозувати, які сторінки будуть потрібні, і повертати їх до того, як вони знадобляться. AMD каже, що модель може навчатися менше ніж за секунду під час першого розгортання, працює на одному ядрі EPYC без GPU і продовжує навчання під час виконання робочого навантаження. MEXT розгортається як модуль ядра Linux, що працює з будь-яким дистрибутивом Linux, і використовує ансамбль моделей ШІ на чолі з трансформерною великою мовною моделлю.
Внутрішні заяви AMD про продуктивність
У деяких внутрішніх робочих навантаженнях, таких як Synopsys PrimeTime, AMD каже, що сервери з 50% ємності DRAM зберігають 95% продуктивності повного сервера, тоді як ємність 25% забезпечує 80% продуктивності. У тривузловому кластері Azure з процесорами EPYC 5-го покоління AMD каже, що MEXT забезпечив 99% продуктивності повного кластера при 50% ємності DRAM у робочому навантаженні Spark SQL з тесту TPC-DS. Для агентного ШІ AMD заявляє про 99% продуктивності повного сервера при 50% ємності пам'яті та 85% при 25% ємності в середньому геометричному для п'яти одночасних агентів. Для агента з високими потребами в пам'яті AMD заявляє про 90% продуктивності при 50% ємності та 88% при 25% ємності.
Розгортання та впровадження
AMD розгорнула MEXT внутрішньо на 145 серверах і каже, що розширить його до 2000 серверів наступного року. Компанія також оголосила про партнерство з HPE, щоб надати MEXT клієнтам. Фаза 1 включає деякі сервери EPYC Venice зі значком MEXT Ready і виділений накопичувач NVMe або відсік для вивантаження. Фаза 2 принесе ліцензії MEXT і застосунок RAM View на ці сервери, але AMD не сказала, коли почнеться Фаза 2.
Робочі навантаження та обмеження
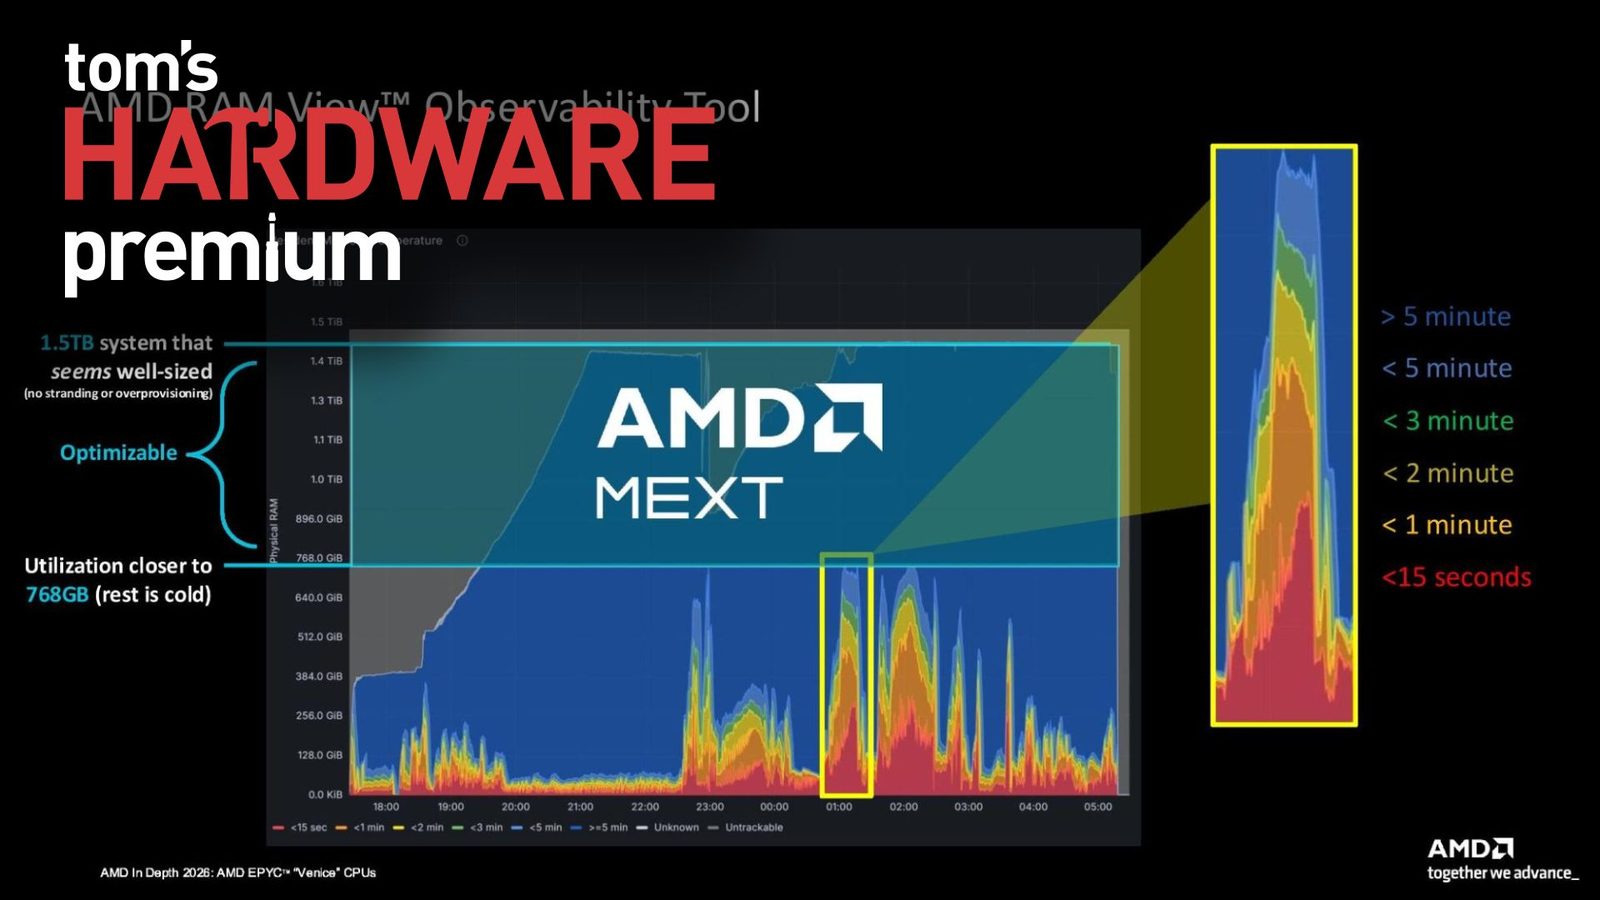
AMD спочатку застосовує MEXT до критичних застосунків EDA, які використовує внутрішньо, зокрема Synopsys PrimeTime, а також оптимізує робочі навантаження агентного ШІ, баз даних та медіа й розваг. Компанія каже, що багато робочих навантажень можуть зменшити ємність приблизно на 20-25%, тоді як більші скорочення стають спеціалізованішими і мають більші відмінності в продуктивності. AMD каже, що RAM View показує, які сторінки гарячі та холодні; в одному узагальненому прикладі система з 1,5 ТБ пам'яті показала майже повне використання, при цьому приблизно половина сторінок не торкалася протягом п'яти хвилин або більше в будь-який момент. AMD не уточнила робоче навантаження для цього прикладу і не надала виноски до деяких слайдів з тестами.
Джерела: Tom's Hardware · The Register
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.