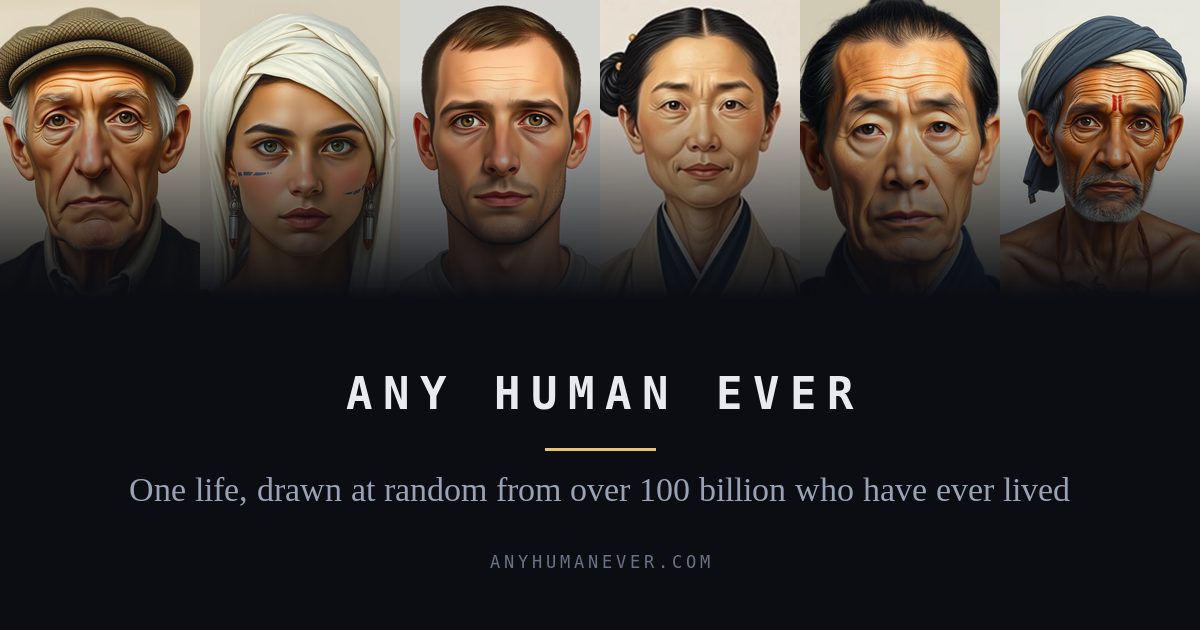
Any Human Ever: сайт випадково обирає одне життя зі 100 мільярдів людей
Проєкт випадково вибирає рік, місце й життя з реальних демографічних даних, а потім розповідає історію. Сторінка джерел документує 326 праць і 87 830 рядків — кожен із позначкою походження.
Новий сайт Any Human Ever перетворює демографічні та історичні дані на одне випадково вибране життя. Його головна сторінка формулює задум одним рядком: «Понад 100 000 000 000 людей жили будь-коли. Виберіть одного». Відвідувач натискає кнопку, і сайт крок за кроком обирає рік, місце й життя — кожне випадково з реальних даних — а потім розповідає відповідну історію. Опис сайту обіцяє, що кожна деталь має джерело.
Як працює вибір
Перший етап — рік народження. Майже всі, хто будь-коли жив, народилися недавно, пояснює сайт, бо населення зростало експоненційно, тож випадкове народження набагато ймовірніше припаде на близьке минуле; аргумент ілюструє графік населення з перемиканням між логарифмічною та лінійною шкалою. Другий етап — місцевість на карті світу, де яскравіші скупчення означають більше людей. Третій додає демографічні показники й хронологію, а четвертий подає історію з прямою приміткою, що вибрана людина не є реальною.
Ілюстрації лише за бажанням
Для кожного життя пропонується ілюстрація, але вона залишається прихованою, поки не увімкнути перемикач. Сайт зазначає, що зображення створені моделлю FLUX.1-schnell на власному ноутбуці автора, і підпис містить це застереження. Вибрані у браузері життя зберігаються локально: галерея вміщує до 100 записів, і кожен має посилання для поширення.
Звідки беруться дані
Сторінка джерел перелічує 326 наборів даних і наукових праць, які дають 87 830 рядків у 80 таблицях, і позначає кожен рядок за походженням. Рядки «extracted» (72,0% рядків, 14,2% цитат, які бачить читач) походять із таблиці, завантаженої від цитованого видавця. Показники «derived» (11,1% / 1,5%) обчислені з цитованих чисел, а сама арифметика описана в рядку. Значення «attributed» (7,7% / 47,6%) написала модель, стверджуючи, що так сказано в джерелі. Рядки «context» (3,7% / 22,5%) використовують джерело для категорій, тоді як число задала модель. Факти «authored» (5,6% / 14,1%) — це твердження моделі без цитованого джерела, і всі вони зареєстровані під ідентифікатором RH109. Ці частки виміряли на 200 життях 21 вересня 2026 року. Найбільша категорія джерел — сім'я, праця й суспільство (85 позицій), далі клімат і небо (66), віра, мова та поховання (57); війну й конфлікти представляє одне джерело.
Навіщо це створено
На сторінці «Про проєкт» автори доводять, що писана історія є упередженою вибіркою: про послідовність франкських королів відомо більше, ніж про побут звичайного селянина в Авіньйоні V століття, хоча більшість людей, які будь-коли жили, були азійцями, бідними й жили недовго. Проєкт ставить питання, що було б, якби історії вибирали з реальних даних і рандомізували для чесного відображення минулого людства. Наводиться цитата поетеси Мюріел Рукейзер: «Всесвіт складається з історій, а не з атомів».
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.