Context Language Models: моделі, які самостійно керують контекстом
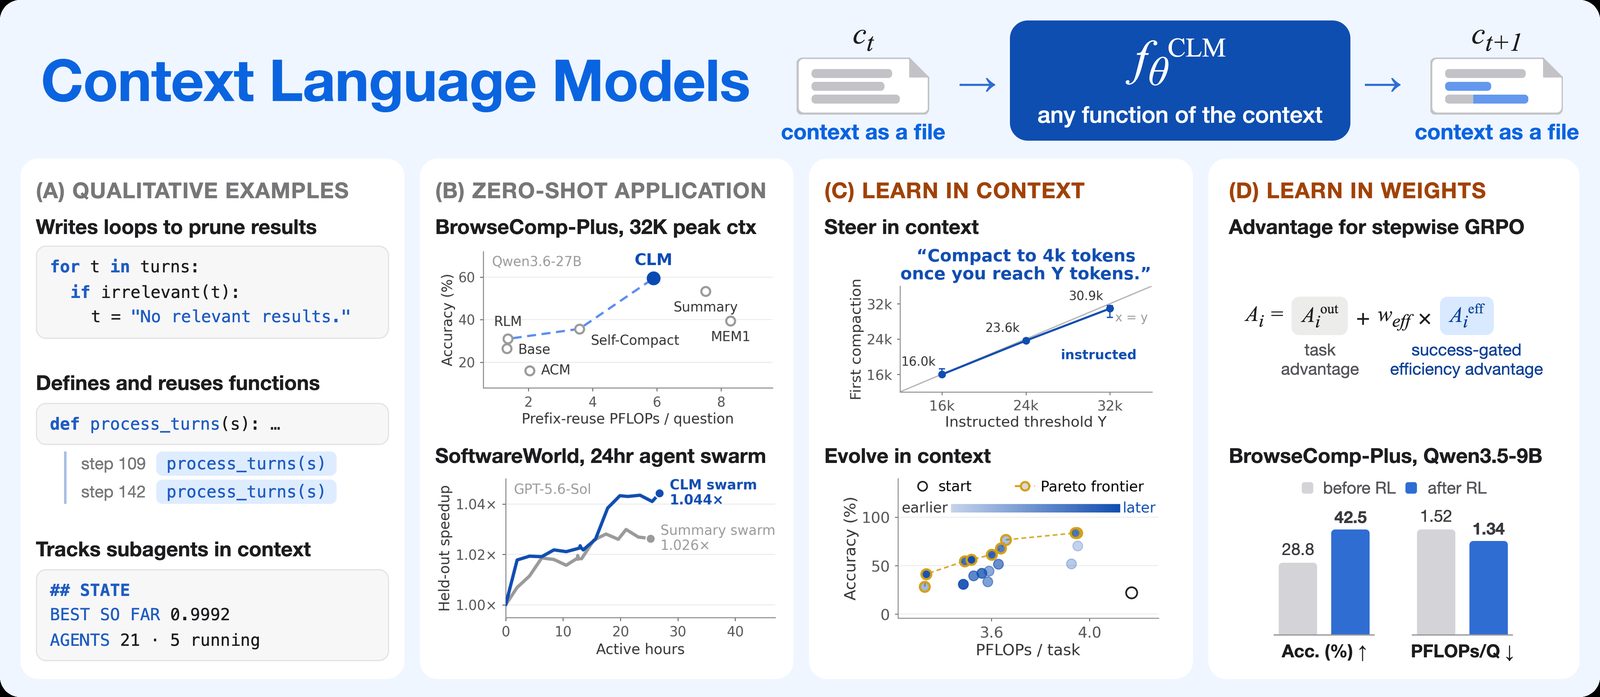
Дослідники з Вашингтонського університету, MIT і Meta представили Context Language Models (CLM): моделі зберігають контекст як файл і самі його редагують. На BrowseComp-Plus точність зросла на 11,4%, а витрати знизилися на 21,5%.
Дослідники з Вашингтонського університету, MIT і Meta представили Context Language Models (CLM) — мовні моделі, які самостійно керують власним контекстом. Роботу опубліковано на arXiv 29 вересня.
Дотепер контекстом керували зовнішні механізми: вручну зібрані системи або обмежені інструменти. У CLM цю справу доручено самій моделі.
Контекст як файл
У CLM контекст зберігається як файл. Модель може вільно вносити до нього зміни: або додавати нові токени, або редагувати будь-яку ділянку за допомогою Bash. Кожна зміна миттєво відображається в живому контексті моделі.
Оскільки контекст — це окремий файл, в одній системі може існувати кілька таких файлів, і підхід поширюється на мультиагентні системи. У тестах моделі також показали нову поведінку: створили трекери для мультиагентної оркестрації, запровадили нову роль чату для внутрішніх записів і визначили багаторазові функції керування контекстом.
За словами авторів, результат підтверджує ідею «Bitter Lesson»: свобода дає моделі кращі стратегії, ніж вручну написані правила.
Результати
CLM працює без додаткового тренування на таких моделях, як Qwen3.6-27B і GPT5.6-Sol. На бенчмарку глибоких досліджень BrowseComp-Plus CLM із лімітом контексту 32K показав 59,4%: це на 11,4% вища точність, ніж у найсильнішого базового методу, а витрати FLOPs на 21,5% менші.
На TerminalBench 2.1 CLM досяг точності найсильнішого методу, але витратив на 29,5% менше FLOPs. На 12-годинному EdgeBench показав на 5% вищий бал із на 59% меншими обчислювальними витратами. На 24-годинному завданні, де група агентів працює над шістьма взаємозалежними репозиторіями, за того самого бюджету досяг на 65% більшого прискорення.
Навчання та ефективність
Поведінкою CLM також можна керувати текстовими інструкціями: користувач може просто описати бажану стратегію. Цикл оптимізації навичок сам удосконалює інструкції керування контекстом; на ContextBench точність зросла максимум на 35,9 пункту, а обчислювальні витрати знизилися.
За допомогою нового методу онлайн-навчання з підкріпленням автори покращили результат моделі Qwen3.5-9B на BrowseComp-Plus на 47,6% і зменшили споживання FLOPs на 12%.
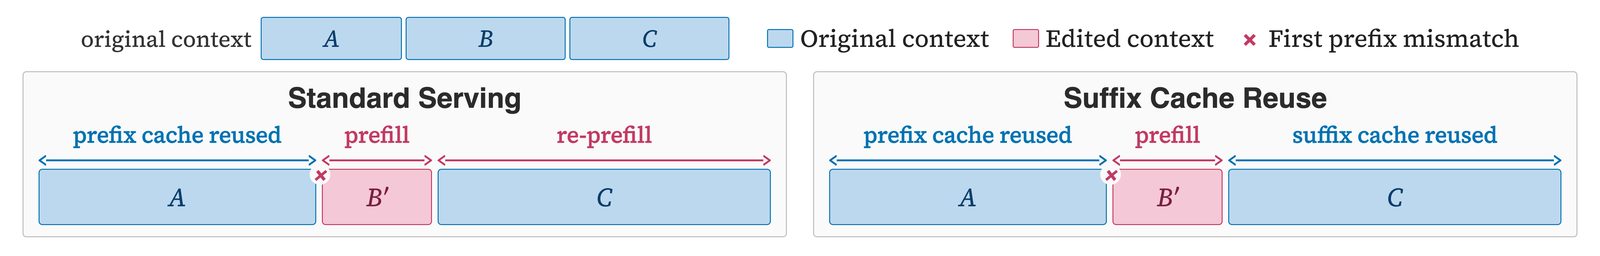
CLM редагує контекст навіть усередині, що змушує стандартні сервісні системи перераховувати кеш. Щоб розв’язати цю проблему, автори розробили Suffix Cache Reuse (SCR) для SGLang: після зміни SCR зберігає кеш незмінених ділянок і зменшує обчислювальні витрати сервера на 35% порівняно зі стандартним SGLang, зберігаючи ту саму продуктивність.
Код опубліковано на GitHub. Практично для довготривалих агентів керування контекстом більше залежатиме від самої моделі й менше — від вручну зібраних зовнішніх систем.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.