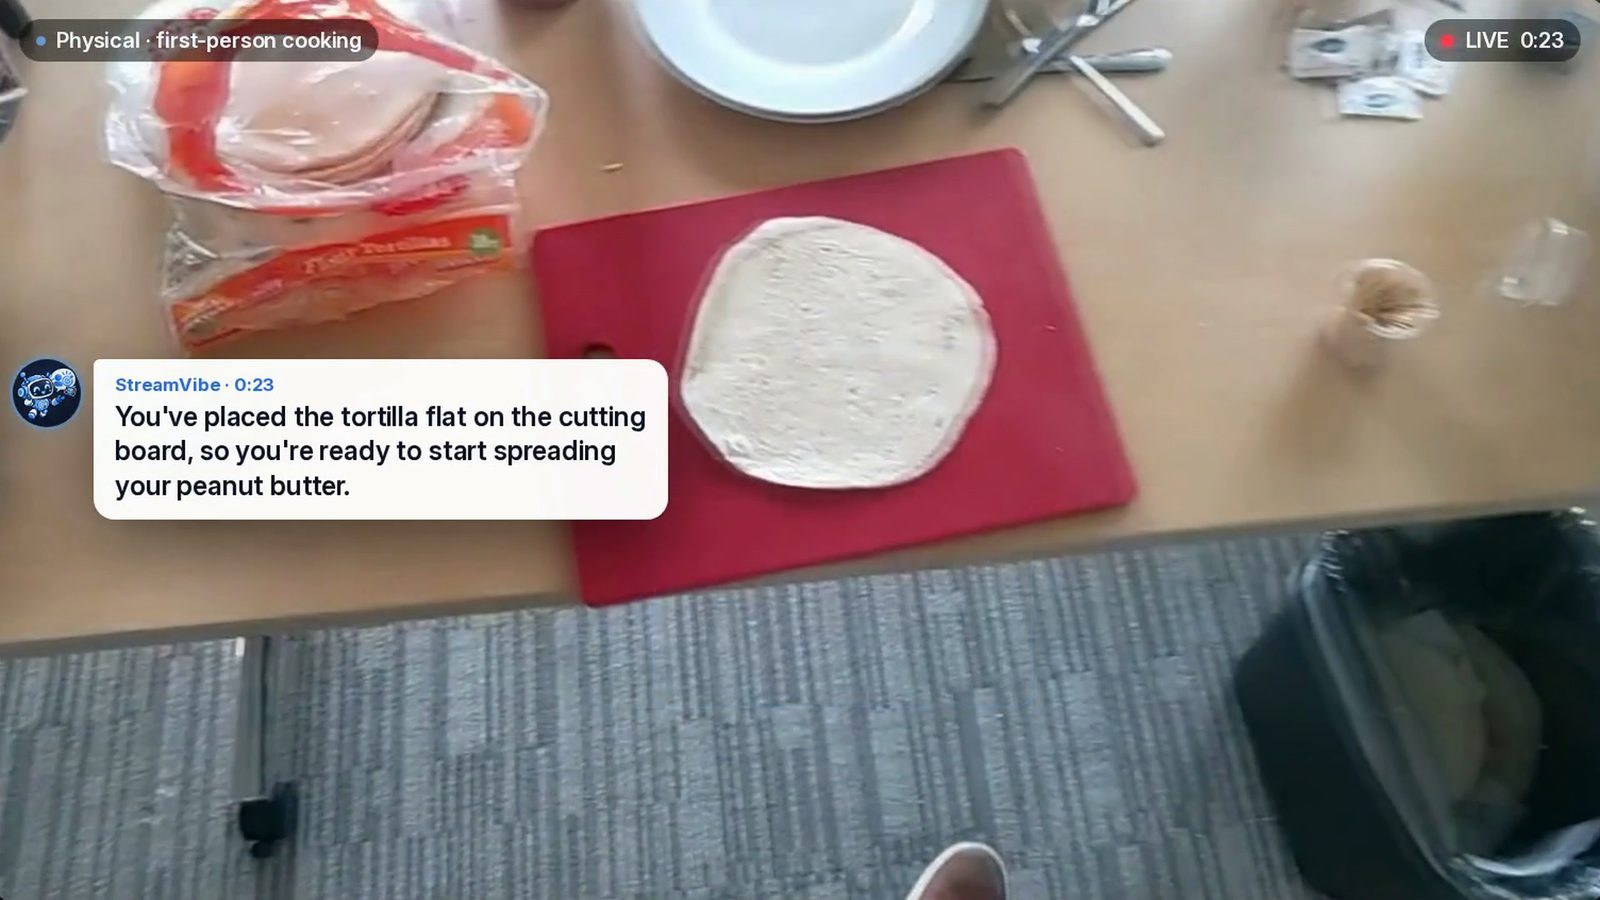
Команда Google представила відеоагента StreamVibe для своєчасної допомоги
Дослідники під керівництвом Google представили StreamVibe, відеоагента, що сам вирішує, коли запропонувати допомогу під час виконання завдань. Тести показують кращу вчасність відповідей, але й складнощі з довгими відео.
Дослідницька команда під керівництвом Google представила StreamVibe, відеоагента, що сам вирішує, коли заговорити, поки користувач працює. Проєкт об'єднує дослідників з Google, Stanford, Oxford та кількох університетів США, щоб створити помічника, який може спостерігати за діями на кшталт приготування їжі чи збирання меблів і пропонувати допомогу лише тоді, коли вона потрібна. Тести показують і обіцянку більш проактивної відеодопомоги, і складнощі, з якими нинішні моделі ще стикаються.
Чому наявні помічники не справляються
За даними статті, наявні відеопомічники створені для чітких команд, як-от "Дай знати, коли вода почне кипіти", тож вони рідко помічають невисловлені наміри. Їм також важко відстежувати, що вже зроблено, що може спричиняти повторні поради або запізнілі відповіді. Коли користувачі змінюють запит посередині завдання, помічники часто дотримуються початкових інструкцій. StreamVibe призначений розрізняти явно висловлені, невисловлені та змінні наміри користувача під час завдання.
Бенчмарк і навчання
Щоб виміряти проблему, команда склала бенчмарк приблизно з 4 100 прикладів із понад 183 годин записів повсякденного життя та роботи з програмним забезпеченням. Gemini 2.5 Flash пропонувала, коли запропонувати допомогу і що сказати, а чотири експерти-оцінювачі мали одноголосно схвалити кожен приклад. Тест охоплює чіткі інструкції, нечіткі цілі та запити, що змінюються з часом. В одному прикладі користувач розбирає іграшковий екскаватор, просить оновлення про хід роботи, а потім переходить до перевірки якості через три хвилини.
Дослідники навчили StreamVibe-VL, модель, яка, ймовірно, базується на Alibaba Qwen3.5-9B і щосекунди вирішує, мовчати чи говорити. Другий етап навчання використовує навчання з підкріпленням, щоб зробити модель стриманішою, щоб вона не переривала постійно. Окрема система пам'яті відстежує незавершені запити та виконані кроки, хоча саме модель вирішує, чи говорити і що сказати.
Результати та обмеження
За словами дослідників, StreamVibe-VL покращує вчасність і якість відповідей на 10,7 відсотка порівняно з іншими моделями, тоді як система пам'яті призначена підвищити проактивну взаємодію ще на 12,3 відсотка і скоротити зайві переривання. StreamVibe-VL загалом випереджає базову модель та інші відкриті моделі з великим відривом, хоча власницька Gemini 3.8 Flash від Google має вищі результати в кількох тестах. Зі збільшенням тривалості відео моделі значно рідше правильно вибирають час для відповіді.
Моделі часто ухвалюють правильне рішення, коли їм треба вирішувати лише в окремі моменти, чи доречний промпт. Але коли вони обробляють усе відео і спираються на власні попередні відповіді, продуктивність усіх протестованих систем різко падає, оскільки помилки накопичуються, а ключовий показник вмісту знижується на 61,5 відсотка залежно від власної історії системи. У відео довжиною понад п'ять хвилин моделі рідко вибирають правильний момент і особливо важко відстежують змінену інструкцію на довгому відрізку.
У навчальному ролику GIMP про перетворення фото на чорно-біле порівнювана модель JoyAI каже, що готове зображення вже збережено, хоча користувач його ще не відкривав, тоді як StreamVibe-VL підказує наступний крок, наприклад "Colors", а потім "Desaturate". Дослідники визнають, що реальні ситуації, ймовірно, складніші за їхню тестову конфігурацію, а майбутня робота вивчатиме, як уподобання користувача і середовище впливають одне на одне з часом.
Джерела: The Decoder
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.