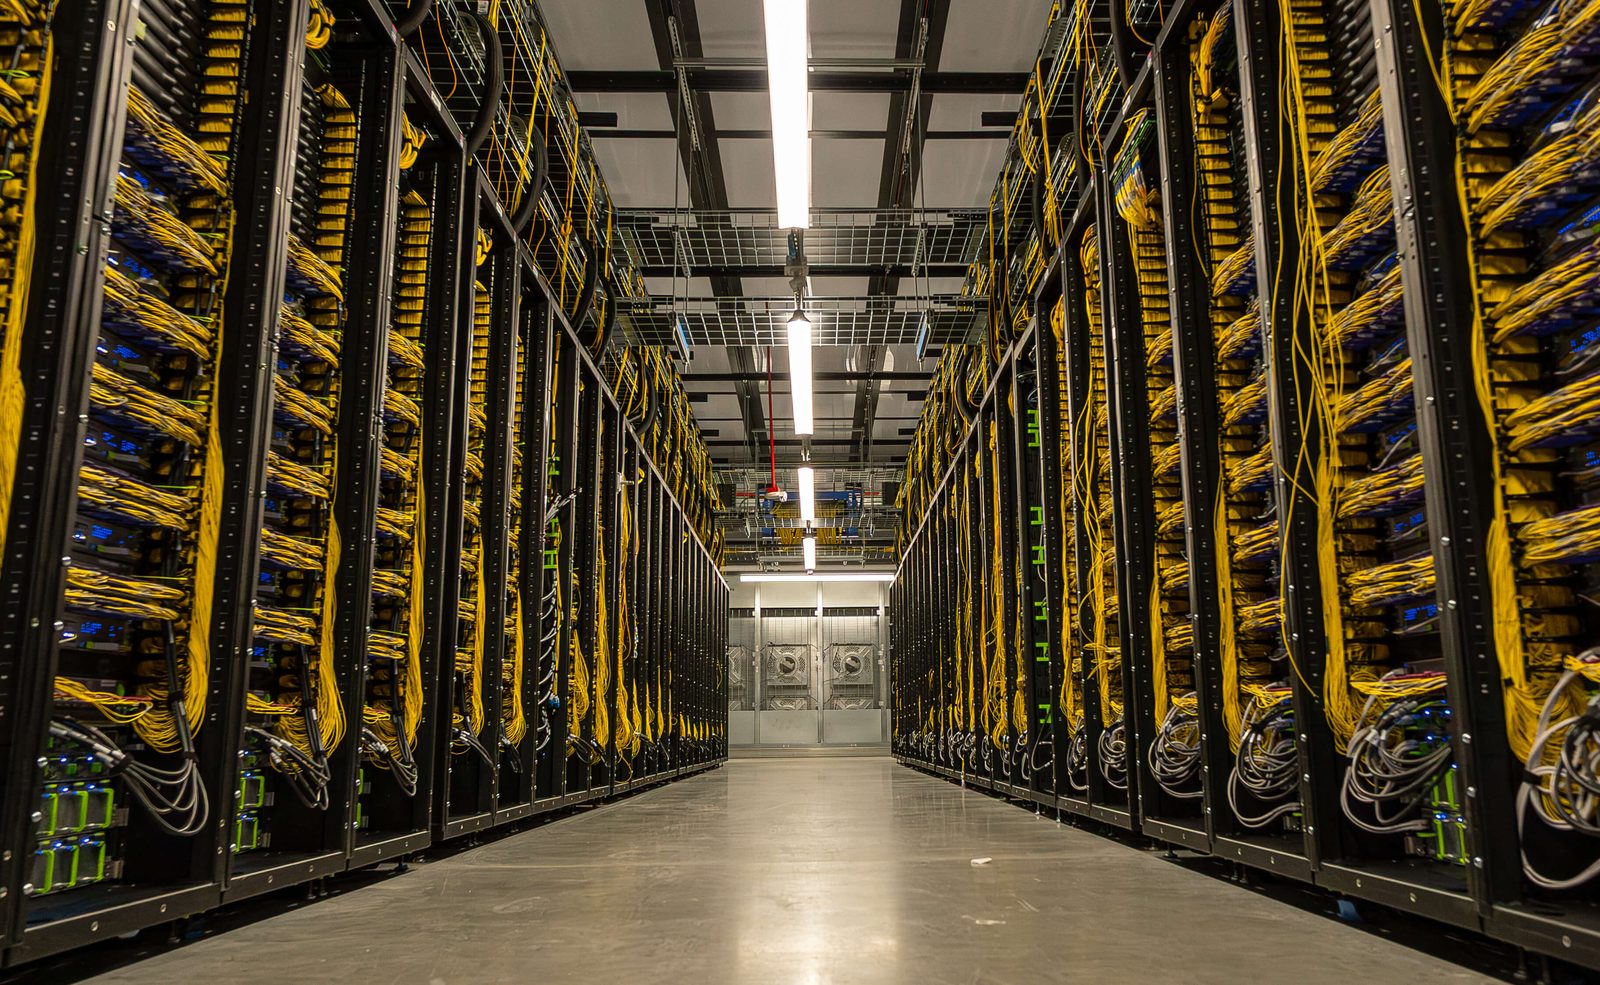
Всередині Prometheus: гігаватний AI-суперкластер Meta в New Albany
Meta завершила першу фазу гігаватного AI-суперкластера Prometheus у New Albany, Ohio. Система включає сотні тисяч GPU, планує масштабуватися до мільйона, і демонструє високу стабільність та ефективність мережі.
Meta завершила першу фазу Prometheus, свого гігаваттного AI-суперкластера в дата-центрі New Albany, Ohio. Об'єкт, який два роки тому був звичайним дата-центром для веб-трафіку, тепер використовується для тренування передовних базових моделей, включаючи родину Muse.
Масштаб у мільйон GPU
Prometheus включає сотні тисяч GPU в декількох пов'язаних між собою будівлях, з'єднаних кілометрами оптоволокна для роботи як єдиної машини. На повному масштабі він становитиме приблизно один мільйон розподілених GPU. Система зараз працює на двох платформах NVIDIA, а третя, базована на Vera Rubin NVL72, прибуде незабаром. Catalina на базі GB200 NVL72 надає 72 GPU з 13,4 TB HBM3e та 720 пікових PFLOPS обчислень FP8, тоді як Clemente на базі GB300 підвищує пам'ять до 288 GB на GPU і перевищує один exaFLOP пікових обчислень FP4.
Мережа та надійність
Поза стандартною мережею дата-центра, виділена мережа Ethernet Back-End забезпечує пряму GPU-to-GPU комунікацію всередині та між будівлями. Мережеві фабрики рівня будівлі з'єднують до 20,736 GPU, тоді як мережа Backend Aggregation простягається від 2 km до понад 100 km з кількома Pbps регіональної пропускної здатності. Meta повідомляє про понад 85% goodput на запусках попереднього тренування і понад 90% у навчанні з підкріпленням, а виправлення прошивки підвищили середній час між перериваннями з приблизно 47 000 до понад 54 000 GPU-годин.
Інженерія стабільності
Переривання досягли піку близько 1,000 подій на 8K GPU щоденно в середині 2025; рік перехреснофункціональної роботи зменшив цей показник на 99%. Цільові виправлення вирішили проблеми цілісності сигналу NVLink у понад 600,000 з'єднаннях, помилки пам'яті HBM та LPDDR, стан комутаторів та події бекенд-мережі. Кожен домен NVL72 з 72 GPU виконує 64-GPU зріз, а вісім GPU у стійці залишаються резервними; відновлення після збоїв поєднує відмовостійкість з урахуванням паралелізму та асинхронне розподілене збереження контрольних точок. Стрибки потужності 30-40% контролює фреймворк обмеження Dynamo Dimmer, підкріплений акумуляторами стійок і накопичувачами енергії об'єкта, тоді як поєднання рідинного охолодження з повітряною підтримкою та рідинного охолодження об'єкта обслуговує гетерогенний парк.
Джерела: Engineering at Meta
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.